Crítica fotográfica con IA o humana: qué detectan un chatbot, una herramienta de crítica y un crítico humano
Una crítica fotográfica con IA es tan buena como lo que se construye y se mide alrededor del modelo. Un chatbot general responde a la pregunta que escribiste. FinalFrame primero mide la foto, le hace las mismas preguntas fijas cada vez y pone a prueba sus lecturas con fotos cuyos defectos ya se conocen. Lo que obtienes es una segunda opinión medida frente a un estándar que tú eliges: un problema nombrado, los valores de deslizador para corregirlo en tu editor y un dictamen sobre si vale la pena seguir editando, para que la próxima edición tenga una dirección. Un crítico humano sigue ganando en la intención y en si la imagen llega.
Si alguna vez pegaste una foto en un chatbot y preguntaste «¿qué te parece?», quizá reconozcas la respuesta que describen los fotógrafos que probaron ChatGPT a finales de 2025: una apertura cálida, una lista de lo que funciona y una o dos sugerencias amables. Una crítica, en el sentido que usa esta página, le hace a la foto las mismas preguntas fijas cada vez, mide su estado técnico, nombra un problema y decide qué hacer después.
Si estás eligiendo adónde mandar la próxima foto, esta página da las cifras medidas de FinalFrame, con fecha, cómo se ve la respuesta de un chatbot ante la misma petición y dónde una persona sigue haciéndolo mejor.
Qué es una crítica fotográfica con IA y en qué se diferencia de preguntarle a un chatbot
Un chatbot general responde al prompt que recibe. Dale una foto y una pregunta vaga y elegirá él de qué hablar. Peter Fenech, de TechRadar, exeditor de Digital Photographer, hizo exactamente esta prueba en diciembre de 2025 y resumió la primera ronda en una línea: «con un prompt genérico, lo más probable es que los comentarios sigan siendo genéricos». Con prompts más largos que nombraban su intención obtuvo respuestas más específicas. (TechRadar, 31 dic. 2025)
Un prompt mejor te da una respuesta con mejor forma; Fenech encontró exactamente eso. Lo que añade FinalFrame no está en el prompt. Mide la foto antes de que se escriba la crítica: lee los datos de cámara del archivo y comprueba el enfoque en el detalle que importa, de cerca, como un paso propio. Después, cada crítica responde a las mismas preguntas fijas, en un orden fijo, así que lo que cubre la lectura no depende de lo bien que hayas preguntado. FinalFrame funciona con un modelo de OpenAI, como dicen sus Términos. El modelo es una parte del resultado. La medición previa a que escriba, y las pruebas de lo que escribe con fotos cuyos defectos ya se conocen, son el resto; la siguiente sección da las cifras.
Aquí importan sobre todo tres preguntas. Si la toma está nítida donde importa, y si el problema pide repetir la toma o se resuelve en el escritorio: las 2 lecturas que más a fondo ponemos a prueba. Cuál es el único problema que más le cuesta a la toma, nombrado a partir de una lista fija y elegido según lo que le cuesta a la toma en el contexto que elijas: el estándar frente al que pides que te midan (Limpio & natural, Ambiente & estilo, Listo para imprimir, Listo para competir, Social o Entrega al cliente). Y si debes seguir editando: un indicador de parar con su razón, más un dictamen de si vale la pena que es un sí o un no. Con la respuesta llega qué mover: valores de deslizador para ese único problema, en el editor que fijaste en tus preferencias (Lightroom, Capture One, Photoshop y otros); sube la versión editada y la siguiente crítica dice si ese problema está resuelto, parcialmente resuelto o sigue ahí. Puedes escribirle esas preguntas a un chatbot; lo que no puedes escribir es la comprobación del enfoque que hay detrás de la primera, las pruebas con fotos de defectos conocidos que presenta la siguiente sección, ni una medición de lo que cambió tu edición: cada nueva versión se puntúa por sí sola y luego se mide frente a la anterior, y volver a subir el mismo archivo se marca como la misma imagen.
Dónde es fuerte la crítica con IA, y cómo lo sabemos
Primero, la lectura técnica. La conclusión final de Fenech fue que «la IA es muy buena en los análisis técnicos», pero probó sus propias tomas terminadas, y ninguno de los artículos que encontramos probó una foto con un defecto conocido. (TechRadar; Amateur Photographer, nov. 2025; Venture Photography, nov. 2025) Así que probamos las nuestras. En nuestra última prueba completa de enfoque, hecha en septiembre de 2026 con una versión anterior de la crítica, 16 fotos con una clara falta de nitidez se leyeron 5 veces cada una: la crítica detectó la falta de nitidez en 75 de las 80 lecturas, y en 100 lecturas de 20 fotos nítidas nunca dijo de ninguna que le faltara nitidez. En una ronda de octubre de 2026, con archivos que conservaban sus datos de cámara, detectó un límite de captura real en las 45 lecturas de las 15 fotos que lo tenían, y emitió 0 dictámenes erróneos de repetir la toma en 132 lecturas de 44 fotos en las que una decisión de estilo o un defecto corregible no debe leerse como tal. Son nuestras propias fotos y etiquetas, elegidas por difíciles; tus fotos no están en el conjunto.
Lo segundo es la parada. En una primera crítica, FinalFrame comprueba un conjunto fijo de condiciones para parar, y puede decir que pares antes cuando la toma lleva un límite de captura, un defecto fijado en el momento del disparo, como un enfoque que no cayó en el sujeto, que ninguna edición puede levantar; entonces la razón nombra el límite y la toma queda marcada como que no vale la pena dedicarle esa hora. Pocos amigos te dirán que dejes de editar una fotografía que se nota que estás disfrutando, y el mentor que lo haría no siempre está a mano; el indicador pone esa decisión en cada crítica. La lección sobre cómo leer ese indicador es dejar de editar.
Lo tercero es la propia puntuación: ¿pone una foto con defecto por debajo de una sin defecto? En octubre de 2026 puntuamos 42 fotos de los conjuntos de prueba etiquetados con los que comprobamos cada nueva versión de FinalFrame: 16 con un defecto conocido (15 de ellas, un problema de enfoque) y 26 sin él. En 412 de los 416 emparejamientos de una foto sin defecto con una con defecto (99 %), FinalFrame puntuó más alto la foto sin defecto; las fotos sin defecto promediaron 7,0 y las fotos con defecto, 5,4.
Con las mismas fotos, GPT-6.1 Sol con esfuerzo bajo, al que solo se le dio la foto y una breve petición de una crítica y una puntuación de 1 a 10 a través de la API de OpenAI (no la app de ChatGPT), promedió 7,7 para las fotos sin defecto y 6,7 para las fotos con defecto (7,7 y 6,6 con esfuerzo alto): alrededor de 1 punto entre los grupos, donde FinalFrame puso 1,6. El método, el prompt y las puntuaciones de cada foto: cómo lo probamos (en inglés).
El modelo a secas es un modelo capaz al que se le dan unas pocas frases de instrucción; pon FinalFrame a su lado y lo que ves es lo que se construye alrededor de un modelo, no cuál modelo es mejor. Lo que construye alrededor del modelo es una crítica pensada para usarse como referencia: una puntuación que baja cuando la foto tiene un defecto, un problema nombrado, un dictamen sobre si vale la pena seguir editando o si hay que repetir la toma, el cambio que más movería la puntuación y valores de deslizador para la próxima edición en el contexto que elegiste. Las dos fotos de abajo muestran dónde una respuesta a secas y su puntuación pueden separarse.
Dos de las fotos con defecto: qué escribió cada uno y qué puntuación puso
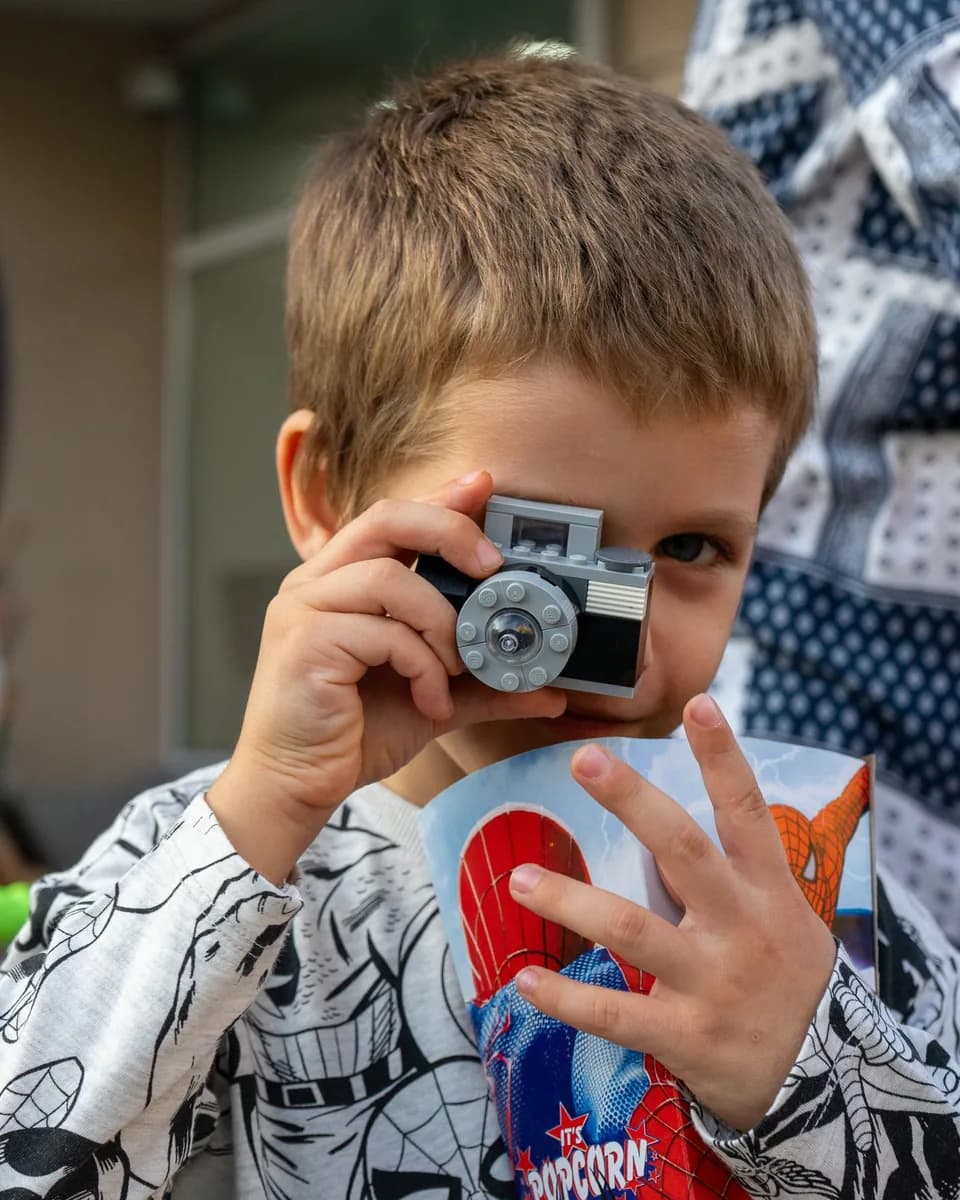
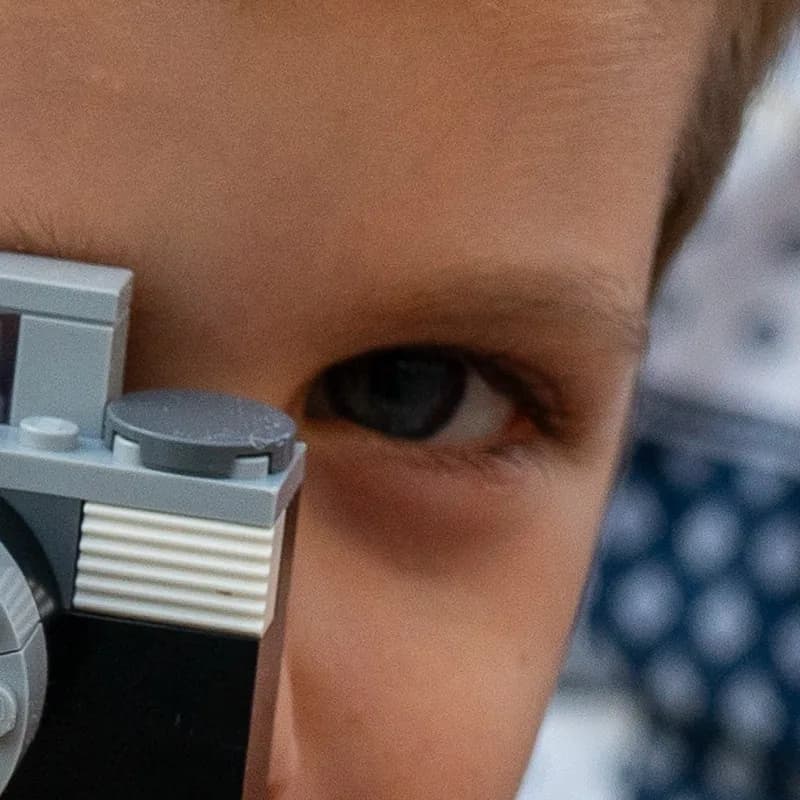
El ojo, de cerca, del mismo archivo.
GPT-6.1 Sol a secas (API de OpenAI, esfuerzo bajo): 7,8/10. FinalFrame (contexto Limpio & natural): 5,5/10. Una lectura cada uno, octubre de 2026.
GPT-6.1 Sol (API de OpenAI, esfuerzo bajo; traducido del inglés)
7,8/10
GPT-6.1 Sol: «El enfoque es bueno donde importa, con un detalle agradable en el cabello, el ojo y las manos». El mayor problema, según el modelo: «Lo que más la está frenando es la figura del fondo a la derecha, que distrae».
FinalFrame (traducido del inglés)
5,5/10
FinalFrame: «el único ojo visible tiene que sostener todo el retrato, y no está lo bastante nítido para una imagen limpia de portafolio». Y su veredicto: «No dedicaría mucho más tiempo a editar esta versión; vale la pena repetir la idea con el ojo bien enfocado».
El modelo a secas elogió el enfoque y puso 7,8. FinalFrame nombró el ojo blando como el límite, puso 5,5 y dijo que había que repetir la toma en lugar de seguir editando: sus palabras y su número dicen lo mismo.
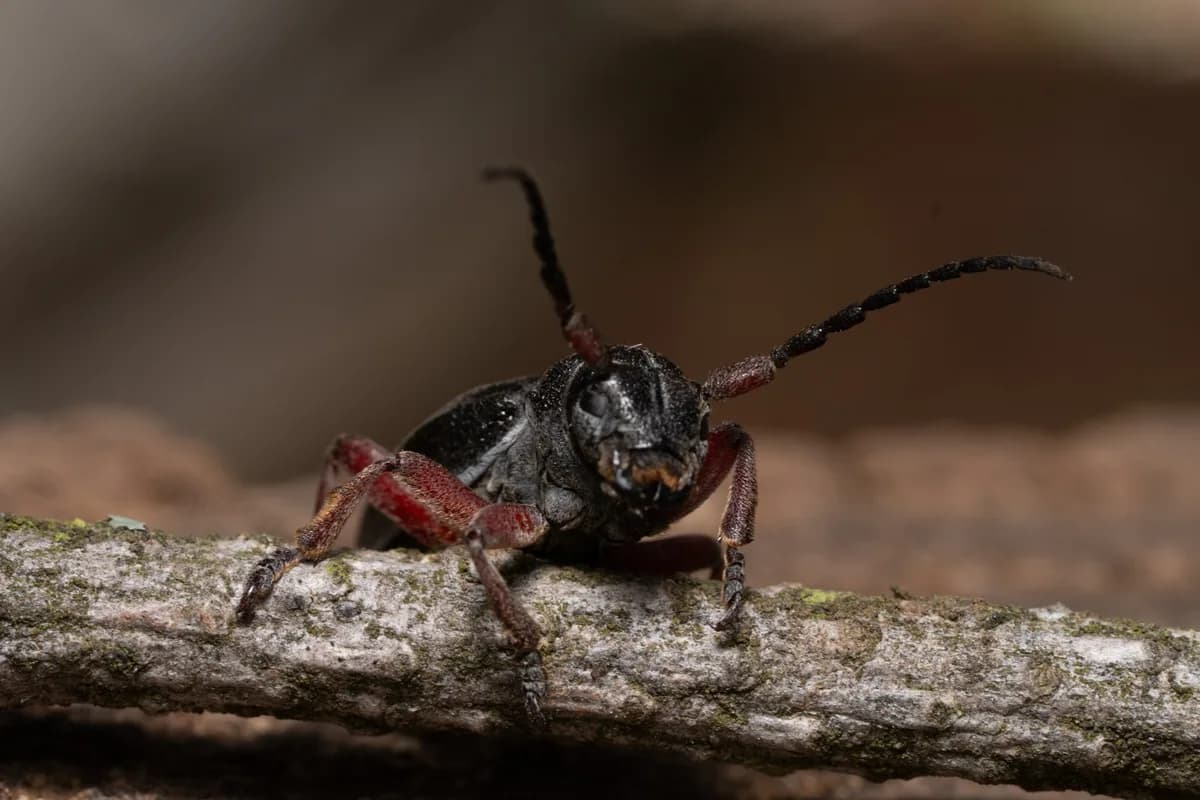
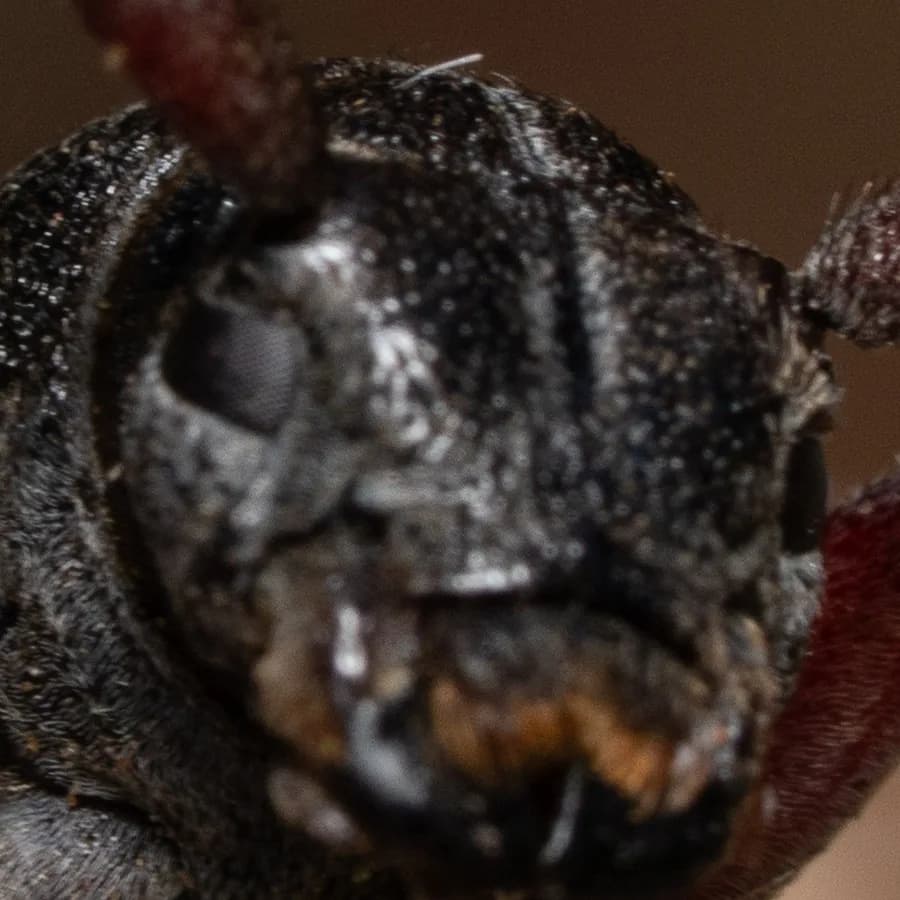
El ojo, de cerca, del mismo archivo.
GPT-6.1 Sol a secas (API de OpenAI, esfuerzo bajo): 7,3/10. FinalFrame (contexto Limpio & natural): 5,6/10. Una lectura cada uno, octubre de 2026.
GPT-6.1 Sol (API de OpenAI, esfuerzo bajo; traducido del inglés)
7,3/10
GPT-6.1 Sol: «Lo que más la está frenando es la falta de detalle nítido alrededor de los ojos y la cara. Son los puntos focales naturales, pero se ven ligeramente blandos…»
FinalFrame (traducido del inglés)
5,6/10
FinalFrame: «la zona cara/ojo no se define con suficiente precisión». Y su veredicto: «aplicar nitidez y contraste local no convertirá esto en una pieza de portafolio nítida».
Aquí los dos nombraron la falta de nitidez en la cara. El modelo a secas, que había dicho que el enfoque de la cámara de juguete era bueno, puntuó esta solo medio punto más bajo: 7,3 frente a 7,8. El 5,6 de FinalFrame dice lo que dicen sus palabras, y que aplicar nitidez no lo arreglará.
Pruébalo con una foto que ya juzgaste por tu cuenta: un problema nombrado, un sí o un no sobre si vale la pena seguir editando, y la razón cuando dice que pares. Después compáralo con lo que tú habrías dicho.
Criticar una fotoLa misma petición en la app de ChatGPT
La prueba anterior se hizo a través de la API de OpenAI. La mayoría de la gente pregunta en la app de ChatGPT, a menudo con sus chats anteriores y la Memoria detrás. Así que escribimos la misma petición a mano en la app, en una cuenta de pago con la Memoria activada, usando el modelo y el ajuste con los que se abrió la app (GPT-6, Medium). Preguntamos por las 2 fotos de ejemplo de arriba, elegidas porque la puntuación del modelo de la API estaba entre las más alejadas de la nuestra, y por 1 foto sin defecto del mismo conjunto, 3 veces cada una, en un chat nuevo cada vez.
Las puntuaciones de la app apenas se movieron de un chat a otro: 7,6, 7,6 y 7,8 para la foto sin defecto; 7,2, 7,2 y 7,1 para la cámara de juguete; 7,2, 7,4 y 7,2 para el escarabajo. En cada una de las 3 rondas puntuó la foto sin defecto por encima de las dos con defecto, por entre 0,2 y 0,7 puntos. Ninguna de las 3 respuestas sobre la cámara de juguete, la foto cuyo enfoque no había caído en el ojo, notó el ojo blando: 2 dijeron que el enfoque era bueno («El enfoque es razonablemente nítido», traducido del inglés), la tercera elogió el detalle del cabello, las manos y la cámara de juguete, que es donde cayó el enfoque, y las 3 culparon al desorden visual. En el escarabajo, sus palabras se movieron más que sus números: 2 respuestas nombraron la falta de nitidez en la cara, y la tercera nombró un problema distinto, «La cara del escarabajo está demasiado oscura» (traducido del inglés), y sugirió levantar las sombras; la puntuación se quedó entre 7,2 y 7,4 en todos los casos.
Como esos 2 ejemplos se eligieron por sus grandes fallos, añadimos 2 fotos que no lo eran: un retrato de un burro de nuestro propio conjunto de calibración, con un defecto corriente (luz plana y brillante, y un cielo casi quemado), y una segunda foto sin defecto, una panorámica de atardecer, 3 chats cada una. Con el burro, la app nombró un problema principal distinto en cada uno de los 3 chats: la luz, después el espacio vacío, después la cabeza del burro contra los árboles de atrás; cada uno, un punto justo sobre esta foto, 2 de ellos presentes en la propia valoración de nuestro fundador, pero uno distinto cada vez. FinalFrame, ejecutado 3 veces con el mismo archivo, nombró todas las veces el cielo brillante, que se impone a la cara, le puso 7,0 cada vez y dio el mismo plan de edición cada vez. En la panorámica, las 3 respuestas de la app y las 3 ejecuciones de FinalFrame señalaron el primer plano oscuro. En estas 2 fotos, las puntuaciones de la app quedaron a menos de medio punto de las de FinalFrame; las grandes diferencias en la cámara de juguete y el escarabajo estuvieron en las 2 fotos elegidas por sus grandes fallos.
A través de la API, GPT-6.1 Sol había puntuado las 3 primeras fotos con 8,2, 7,8 y 7,3 con esfuerzo bajo. La prueba en la app difiere de eso en más que la Memoria: otro modelo (GPT-6, no GPT-6.1 Sol), otro ajuste de esfuerzo y lo que sea que la app añade a un chat. Fue una sola cuenta, la del fundador, con la Memoria activada, así que los chats anteriores pueden haber influido en los posteriores. Por eso esto muestra lo que obtienes de ChatGPT tal como lo usarías, no cuánto mueve una puntuación la Memoria por sí sola. Las puntuaciones están en cómo lo probamos (en inglés).
Tres maneras de conseguir una crítica de una foto
Cada fila tiene excepciones. La columna del chatbot resume lo que publicaron fotógrafos y un equipo de investigación entre noviembre de 2025 y agosto de 2026, experiencias individuales y no una prueba controlada, y los chatbots cambian a menudo. Nuestras propias pruebas de un modelo a secas, a través de la API de OpenAI y a mano en la app de ChatGPT, se presentan antes de la tabla y no forman parte de esta columna.
| Un chatbot, consultado sin más | FinalFrame | Un crítico humano | |
|---|---|---|---|
| Fundamentos técnicos | Bien valorado por un probador en sus propias tomas terminadas; no se probó con una foto con un defecto conocido (TechRadar, dic. 2025) | Medido, sept. 2026, con una versión anterior: falta de nitidez señalada en 75 de 80 lecturas de fotos claramente blandas, 0 falsas alarmas en 100 lecturas de fotos nítidas; se lee sobre una copia almacenada de tu foto, no sobre tu archivo original, con la comprobación del enfoque en el detalle clave hecha como un paso propio | Fuerte; un mentor puede revisar todo el archivo al 100 % |
| Intención y reglas rotas a propósito | Ciego salvo que se le diga (Venture Photography, nov. 2025) | Toma tu objetivo como el contexto que eliges, entre 6, y juzga frente a él; más allá de eso no puede conocer la intención, lo dice y te deja marcar el problema nombrado como que no coincide con tu foto | Lo que mejor hace |
| La misma foto, leída otra vez | No medido en los artículos publicados en los que se basa esta columna; la respuesta cambia según cómo preguntes (TechRadar, dic. 2025) | Medido en cada prueba completa; oct. 2026, 77 críticas leídas 3 veces: nunca más de 0,4 de diferencia entre las 3 lecturas, la misma Puntuación FinalFrame en las 3 para 47; la misma letra de nivel para 71 | Puede variar con el cansancio, el ánimo y el orden de las obras presentadas, por eso los salones sientan a un jurado |
| Qué decide | Comenta casi todos los aspectos, en las pruebas de un preprint de 2026; sin un veredicto fijo (arXiv:2606.29689) | Un problema de una lista fija; un indicador de parar con su razón; un sí o no sobre si vale la pena | Lo que más le importa; uno bueno te dirá cuándo una toma está terminada, o no merece más tiempo |
| Velocidad y disponibilidad | De segundos a minutos, a cualquier hora | Alrededor de un minuto, a cualquier hora, con la medición de arriba hecha primero | Horas en un foro; una semana o más para una noche de club o un mentor |
Lee la columna de FinalFrame como un modelo con un proceso de medición a su alrededor. Lee la columna de la derecha como aquella para la que estás preparando la fotografía.
Dónde sigue ganando un crítico humano
La intención. Todas las fuentes de esta página llegan aquí. Venture Photography, una escuela de talleres, en una entrada de noviembre de 2025 (firma: sengmah): «la IA solo puede evaluar lo que ve visualmente, no si cumpliste tu objetivo artístico». (Venture Photography, 24 nov. 2025) Geoff Harris, de Amateur Photographer, le dio a ChatGPT una toma de Henri Cartier-Bresson en noviembre de 2025 y recibió una lista de mejoras, una de las cuales, escribió, «haría que HCB se revolviera en su tumba». (Amateur Photographer, 17 nov. 2025) Un crítico humano que te conoce, o que simplemente pregunta qué buscabas, lee el horizonte inclinado como la idea. Un modelo lo lee como un horizonte inclinado; y muchas veces también un juez de salón, que ve la imagen sin su autor al lado para explicarla.
La página de puntuación de FinalFrame dice que la crítica «no puede conocer tu intención» y que «un horizonte inclinado puede ser la idea entera». Lo que sí toma es tu objetivo: eliges un contexto (Limpio & natural, Ambiente & estilo, Listo para imprimir, Listo para competir, Social o Entrega al cliente) y la foto se juzga frente a él. Misma foto, distinto contexto, distinta puntuación, y de eso se trata. El conjunto etiquetado incluye fotos de estilo deliberado (ojos detrás de gafas de sol o del ala de un sombrero, un desenfoque de movimiento deliberado) para que una decisión estilística no se lea como una razón para repetir la toma; la cifra de 0 en 132 de arriba las incluye. La crítica aún puede decir lo que esa decisión cuesta en el contexto que elegiste. La regla de lectura es la de la página de puntuación: dale menos peso a un defecto señalado cuando fue una decisión deliberada. Hay más sobre dónde puede equivocarse la IA en cómo funciona la Puntuación FinalFrame.
La emoción y la sala. Un crítico humano puede decirte si la imagen le llegó, y cómo se lee junto al resto de tu trabajo. Los niveles de FinalFrame están calibrados según el juicio de los salones internacionales (las exposiciones PSA y FIAP), y es un estándar útil con el que medirse; sigue siendo un estándar, no un juez. La conclusión de Harris es la que reconocerá la mayoría de los fotógrafos: «ningún gran concurso de fotografía que se precie despediría jamás al jurado para poner a ChatGPT en su lugar». (Amateur Photographer)
El problema de la selectividad: lo que encontró un preprint de 2026
La evidencia publicada más directa que encontramos es un preprint de junio de 2026 de Sajjad Ghiasvand y cuatro coautores, «Can MLLMs Critique Like Humans?», que puntuó ocho modelos de pesos abiertos más GPT-5.5 frente a críticas humanas clasificadas de 1.227 publicaciones de r/photocritique. (arXiv:2606.29689, v2 31 ago. 2026) Aquí importan dos hallazgos.
Primero, los modelos de frontera ganaron la preferencia de los jueces: en la condición principal, los 4 jueces LLM «prefieren las críticas de los modelos de frontera a las humanas». Pero cuando se les preguntó cuán parecida era en sustancia cada crítica de modelo a la humana, los jueces y 2 anotadores humanos puntuaron todos los modelos entre 1,81 y 2,59 en una escala de 5 puntos, «cercano a “mayormente diferente”». (arXiv:2606.29689)
Segundo, y este es el que hay que recordar: «los modelos divergen de maneras que las puntuaciones no revelan: cubren casi todos los aspectos estéticos donde los humanos son selectivos y se repiten entre críticas de una misma foto, incluso cuando se les pide escribir con una extensión humana». Cubrir todos los aspectos no es encontrar todos los problemas: los autores también encontraron que «ocultar la imagen apenas cambia» las puntuaciones automáticas de similitud, y que la medida habitual «premia un estilo de crítica fluido y exhaustivo en lugar de la selectividad y la especificidad de la crítica humana». (arXiv:2606.29689) En pocas palabras: si se lo deja a su aire, un modelo comenta casi todo, y las puntuaciones automáticas del artículo apenas se movieron cuando el modelo nunca vio la foto. Un buen crítico primero mira y después deja fuera la mayor parte.
El diseño de FinalFrame responde a las dos mitades de ese hallazgo, aunque no hemos pasado la prueba del artículo sobre él. La medición descrita antes ata las lecturas técnicas a los píxeles. La mitad de la selectividad es una decisión pedagógica más antigua que el artículo: la crítica nombra un problema, elegido según lo que le cuesta a la toma en tu contexto, y empieza por ese, para que la próxima edición tenga un solo objetivo. Si ese problema es el que tú habrías nombrado es una pregunta justa; un control «No coincide con mi foto» debajo de él te deja marcarlo cuando no lo es.
La consistencia: la parte difícil, y lo que medimos
La consistencia es una de las partes difíciles de cualquier crítica, humana o de IA. En un estudio de 4 años en un importante concurso de vinos de Estados Unidos, los jueces que recibieron el mismo vino 3 veces en una misma sesión a menudo lo puntuaron de forma distinta, algunos de Bronce a Oro (Hodgson, Journal of Wine Economics, 2008); no encontramos ningún estudio así sobre jueces de fotografía. Un modelo también puede leer la misma foto de forma distinta, el nuestro incluido. Ninguna fuente publicada que encontramos midió eso, ni para un chatbot ni para ninguna app de crítica, así que esta sección trata del nuestro; también es una prueba que puedes hacer con lo que uses, nosotros incluidos: manda la misma foto 3 veces y compara. La página de puntuación de FinalFrame dice que la puntuación «puede variar ligeramente en una segunda lectura de la misma foto», y eso sigue siendo cierto. Lo que hicimos fue medir cuánto, y luego contenerlo.
En la ronda de octubre de 2026, 77 críticas de 73 fotografías, cada una leída 3 veces, en un conjunto cargado de casos límite: ninguna se movió más de 0,4 puntos entre las 3 lecturas, y 47 de las 77 obtuvieron la misma Puntuación FinalFrame en las 3; la letra de nivel coincidió en las 3 para 71 de las 77, el dictamen de si vale la pena para 73 y el de parar para 75. Llegamos ahí midiendo primero: en agosto de 2026, con 10 fotos leídas 5 veces cada una, un cambio en cómo se ejecuta el modelo redujo a la mitad la dispersión mediana entre la puntuación potencial más alta y la más baja de una foto (hasta dónde podría llevarla la edición), de 0,8 a 0,4 puntos. La dispersión ahora se informa en cada prueba completa; las cifras de octubre de arriba vienen de una de esas pruebas.
Un límite. El problema nombrado se repite con menos firmeza que la puntuación: en una ronda de septiembre de 2026 con una versión anterior, 71 fotos leídas 5 veces cada una, el mismo problema fue el principal en al menos 4 de las 5 lecturas para 59 de ellas, y en las 5 para 40, así que una nueva lectura puede empezar por un problema distinto.
Cómo usar ambas
Trata las dos como instrumentos distintos y no como rivales. Usa la lectura de la IA dentro del ciclo de edición: corrige lo único que nombra, sube la nueva versión, mira si la corrección funcionó y detente cuando el indicador de parar te dé la razón. En la nueva versión, la crítica dice si el problema anterior está resuelto, parcialmente resuelto o sigue ahí, y un movimiento de la puntuación de 0,1 o menos se etiqueta como dentro de la variación normal en lugar de presentarse como progreso.
Usa a las personas donde la IA te dijo que es ciega. Lleva la versión terminada a una noche de crítica de un club o a un foro como r/photocritique y haz una sola pregunta: ¿esta imagen dice lo que quise decir? Obtendrás la lectura emocional, la lectura del contexto y, a veces, «esta fotografía no me importa», algo que ningún modelo te dará. Cuando las dos discrepan sobre un defecto técnico, lo zanja el archivo, al 100 % y al tamaño en que se va a mostrar; cuando discrepan sobre si la toma funciona, el humano está respondiendo la pregunta que importa.
Si ya puedes nombrar el síntoma (una toma plana, un cielo blanco, un ojo blando), ve directamente al índice de diagnóstico, que lleva cada uno a su lección. Y si la toma está limitada por la captura, ninguna edición levanta ese límite: la pregunta pasa a ser si funciona tal como está o merece repetirse. Si quieres el método que sigue una crítica en lugar de una comparación de quién la da, lee cómo criticar una foto.
Preguntas frecuentes sobre la crítica fotográfica con IA
- ¿Puede ChatGPT criticar mis fotos?
- Sí, y con un prompt detallado lo hace mejor. Peter Fenech, de TechRadar, encontró que «lo más probable es que los comentarios sigan siendo genéricos» salvo que describiera su intención, y aun así sospechaba que buena parte estaba «sacada de respuestas enlatadas». (TechRadar, dic. 2025; Amateur Photographer, nov. 2025) OpenAI dice que, cuando la Memoria está activada, ChatGPT puede recordar detalles de tus chats anteriores y usarlos para personalizar sus respuestas (OpenAI Help Center, «Memory in ChatGPT», consultado en octubre de 2026). Si quieres comentarios sobre la foto que no estén moldeados por lo que ChatGPT sabe de ti, abre un chat temporal y, donde te ofrezca la opción, elige Unpersonalized (sin personalización). Ninguno de los dos artículos de revista lo probó con una foto con un defecto conocido, y ninguno midió si lee la misma foto igual dos veces. Lo que añade FinalFrame está fuera del prompt: una comprobación del enfoque en el detalle que importa, hecha como un paso propio, lecturas puestas a prueba con fotos de defectos conocidos y una respuesta medida a cuánto se mueve una lectura repetida.
- ¿Es precisa la crítica fotográfica con IA?
- Depende de lo que se midió, así que pide las cifras. Las de FinalFrame, de sus propias pruebas etiquetadas: falta de nitidez señalada en 75 de 80 lecturas de tomas claramente blandas y, por error, en 0 de 100 lecturas de tomas nítidas (septiembre de 2026, con una versión anterior), y en 77 críticas de 73 fotografías, cada una leída 3 veces, el mismo nivel en las 3 lecturas para 71 (octubre de 2026). En cuanto a la intención, conoce el contexto que eliges: el estándar frente al que juzga. Lo que no puede saber es que una decisión dentro de la toma fue deliberada, así que un cielo en clave alta o una inclinación intencionada pueden leerse como un defecto; dale menos peso a esa nota. Sus Términos llaman al resultado «opinión algorítmica», no una evaluación experta. Trátala como una segunda opinión medida frente a un estándar con nombre.
- ¿Los comentarios de la IA harán que mis fotos sean genéricas?
- Pueden, si actúas sobre todo lo que dice un modelo general: el preprint de 2026 encontró que los modelos «cubren casi todos los aspectos estéticos donde los humanos son selectivos», y que su parecido con las críticas humanas refleja «un estilo de crítica estable más que una observación específica de la imagen» (arXiv:2606.29689); corregir 10 notas a la vez es como una toma con carácter se convierte en una toma meramente correcta. FinalFrame nombra un problema por crítica, elegido según lo que le cuesta a la toma en el contexto que elegiste. Corrígelo, sube la nueva versión y mira si la corrección funcionó. Si lo único que nombra es una decisión que tomaste a propósito, consérvala.
- ¿Hay alguna crítica fotográfica con IA gratis?
- Sí. La página de inicio de FinalFrame ofrece una crítica de demostración gratis sin cuenta (el nivel, las puntuaciones, el cuello de botella nombrado y el veredicto; los ajustes completos del editor necesitan una cuenta gratuita), y una cuenta gratuita recibe 3 críticas al mes, de 1 crédito cada una, más hasta 2 créditos bonus que ganas una sola vez, cuando subes una versión editada.
Mira una crítica medida de una toma que conoces bien
Sube una fotografía sobre la que ya tengas una opinión. FinalFrame lee su enfoque y si tiene un límite de captura, nombra el único problema que más le cuesta y dice si vale la pena seguir editando, y por qué cuando dice que pares. Los valores de deslizador para esa única corrección vienen con una cuenta gratuita. Compáralo con lo que tú habrías dicho; las diferencias en ambas direcciones son la parte útil.
Criticar una fotoChatGPT y OpenAI son marcas comerciales de OpenAI. FinalFrame no está afiliado a OpenAI ni cuenta con su respaldo.