Critique photo par IA ou critique humaine : ce que repèrent un chatbot, un outil de critique et un humain
Une critique photo par IA vaut ce qui est construit et mesuré autour du modèle. Un chatbot généraliste répond à la question que vous avez tapée. FinalFrame mesure d'abord la photo, lui pose à chaque fois les mêmes questions fixes et teste ses lectures sur des photos dont les défauts sont déjà connus. Ce que vous obtenez, c'est un deuxième avis mesuré au regard d'un étalon que vous choisissez : un problème nommé, les valeurs de curseurs correspondantes dans votre logiciel de retouche, et un avis sur l'intérêt de retoucher davantage, pour que la prochaine retouche ait une direction. Un critique humain garde l'avantage sur l'intention et sur la question de savoir si l'image touche.
Si vous avez déjà collé une photo dans un chatbot en demandant « qu'en pensez-vous ? », vous reconnaîtrez peut-être la réponse que décrivent les photographes qui ont testé ChatGPT fin 2025 : une entrée en matière chaleureuse, une liste de ce qui fonctionne, et une ou deux suggestions formulées en douceur. Une critique au sens où cette page l'entend pose à chaque fois des questions fixes à la photo, mesure son état technique, nomme un problème et décide de la suite.
Si vous hésitez sur l'endroit où envoyer votre prochaine photo, cette page donne les chiffres mesurés de FinalFrame, datés, ce à quoi ressemble la réponse d'un chatbot à la même demande, et là où une personne fait encore mieux.
Ce qu'est une critique photo par IA, et en quoi elle diffère d'une question posée à un chatbot
Un chatbot généraliste répond à la requête qu'on lui donne. Donnez-lui une photo et une question vague, et il choisit de quoi il parle. Peter Fenech, de TechRadar, ancien rédacteur de Digital Photographer, a fait exactement ce test en décembre 2025 et a résumé la première manche en une ligne : « avec une requête générique, le retour risque de rester générique ». Des requêtes plus longues qui nommaient son intention lui ont valu des réponses plus ciblées. (TechRadar, 31 déc. 2025)
Une meilleure requête vous donne une réponse mieux construite ; c'est exactement ce qu'a constaté Fenech. Ce qu'ajoute FinalFrame n'est pas dans la requête. Il mesure la photo avant que la critique soit écrite : il lit les données de l'appareil dans le fichier et vérifie la mise au point sur le détail qui compte, de près, comme une étape à part entière. Ensuite, chaque critique répond aux mêmes questions fixes, dans un ordre fixe, si bien que ce que couvre la lecture ne dépend pas de la qualité de votre question. FinalFrame fonctionne sur un modèle d'OpenAI, comme l'indiquent ses Conditions d'utilisation. Le modèle est une partie du résultat. La mesure avant qu'il écrive, et le test de ce qu'il écrit sur des photos dont les défauts sont déjà connus, sont le reste ; la section suivante donne les chiffres.
Trois questions comptent le plus ici. L'image est-elle nette là où cela compte, et le problème demande-t-il de refaire la photo ou se règle-t-il devant l'écran : les 2 lectures que nous testons le plus durement. Quel problème coûte le plus à l'image, nommé à partir d'une liste fixe et choisi selon ce qu'il coûte à l'image dans le contexte que vous choisissez : l'étalon auquel vous demandez à être mesuré (Sobre & naturel, Ambiance & style, Prêt à imprimer, Prêt pour le concours, Réseaux sociaux ou Travail client). Et faut-il continuer à retoucher : un indicateur d'arrêt avec sa raison, plus un avis « Mérite l'effort » qui est un oui ou un non. Avec la réponse vient ce qu'il faut bouger : des valeurs de curseurs pour ce problème précis, dans le logiciel que vous avez choisi dans vos préférences (Lightroom, Capture One, Photoshop et d'autres) ; téléversez la version retouchée, et la critique suivante dit si ce problème est résolu, partiellement résolu ou toujours présent. Vous pouvez taper ces questions dans un chatbot ; ce que vous ne pouvez pas taper, c'est la vérification de la mise au point derrière la première, les tests sur des photos aux défauts connus dont la section suivante rend compte, ou une mesure de ce que votre retouche a changé : chaque nouvelle version est notée pour elle-même, puis mesurée par rapport à la précédente, et un nouveau téléversement du même fichier est signalé comme la même image.
Là où la critique par IA est forte, et comment nous le savons
Commençons par la lecture technique. Le verdict final de Fenech était que « l'IA est très douée pour les analyses techniques », mais il a testé ses propres images finies, et aucun des articles que nous avons trouvés n'a essayé une photo au défaut connu. (TechRadar ; Amateur Photographer, nov. 2025 ; Venture Photography, nov. 2025) Nous avons donc testé les nôtres. Lors de notre dernier test complet de mise au point, réalisé en septembre 2026 sur une version antérieure de la critique, 16 photos nettement floues ont été lues 5 fois chacune : la critique a repéré le flou dans 75 des 80 lectures, et sur 100 lectures de 20 photos nettes, elle n'en a jamais qualifié une seule de floue. Lors d'une série d'octobre 2026, sur des fichiers qui contenaient leurs données d'appareil, elle a détecté une vraie limite de prise de vue dans les 45 lectures des 15 photos qui en avaient une, et a émis 0 demande erronée de refaire la photo sur 132 lectures de 44 photos où un choix de style ou un défaut corrigible ne doit pas être lu comme une telle limite. Ce sont nos propres photos et nos propres étiquettes, choisies pour être difficiles ; vos photos ne font pas partie de l'ensemble.
Le deuxième point, c'est l'arrêt. Lors d'une première critique, FinalFrame vérifie un ensemble fixe de conditions d'arrêt, et il peut dire stop tôt quand l'image porte une limite de prise de vue, un défaut figé au moment du déclenchement, comme une mise au point qui a manqué le sujet, qu'aucune retouche ne peut lever ; la raison nomme alors cette limite et l'image est marquée comme ne méritant pas l'heure de travail. Peu d'amis vous diront d'arrêter de retoucher une photo que vous prenez visiblement plaisir à retoucher, et le mentor qui le ferait n'est pas toujours disponible ; l'indicateur met cet avis dans chaque critique. La leçon pour lire cet indicateur est Arrêter de retoucher.
Le troisième, c'est le score lui-même : place-t-il une photo défectueuse sous une photo sans défaut ? En octobre 2026, nous avons noté 42 photos issues des ensembles de test étiquetés sur lesquels nous vérifions chaque nouvelle version de FinalFrame : 16 avec un défaut connu (dont 15 un problème de mise au point) et 26 sans. Dans 412 des 416 paires associant une photo sans défaut à une photo défectueuse (99 %), FinalFrame a donné le score le plus haut à la photo sans défaut ; les photos sans défaut ont obtenu 7,0 en moyenne, les photos défectueuses 5,4.
Sur les mêmes photos, GPT-6.1 Sol avec l'effort réglé sur « low », à qui l'on ne donnait via l'API d'OpenAI (pas l'application ChatGPT) que la photo et une courte demande de critique et de score de 1 à 10, a donné en moyenne 7,7 aux photos sans défaut et 6,7 aux photos défectueuses (7,7 et 6,6 avec l'effort sur « high ») : environ 1 point d'écart entre les groupes, là où FinalFrame en mettait 1,6. La méthode, la requête et les scores de chaque photo : comment nous avons testé (en anglais).
Le modèle seul est un modèle capable à qui l'on donne quelques phrases d'instruction ; placez FinalFrame à côté, et ce que vous voyez, c'est ce qui est construit autour d'un modèle, pas lequel des modèles est le meilleur. Ce que FinalFrame construit autour du modèle, c'est une critique faite pour servir de référence : un score qui baisse quand la photo a un défaut, un problème nommé, un avis sur l'intérêt de retoucher davantage ou sur la nécessité de refaire la photo, le changement qui ferait le plus monter le score, et des valeurs de curseurs pour la prochaine retouche dans le contexte que vous avez choisi. Les deux photos ci-dessous montrent où une réponse du modèle seul et son score peuvent diverger.
Deux des photos défectueuses : ce que chacun a écrit, et le score donné par chacun
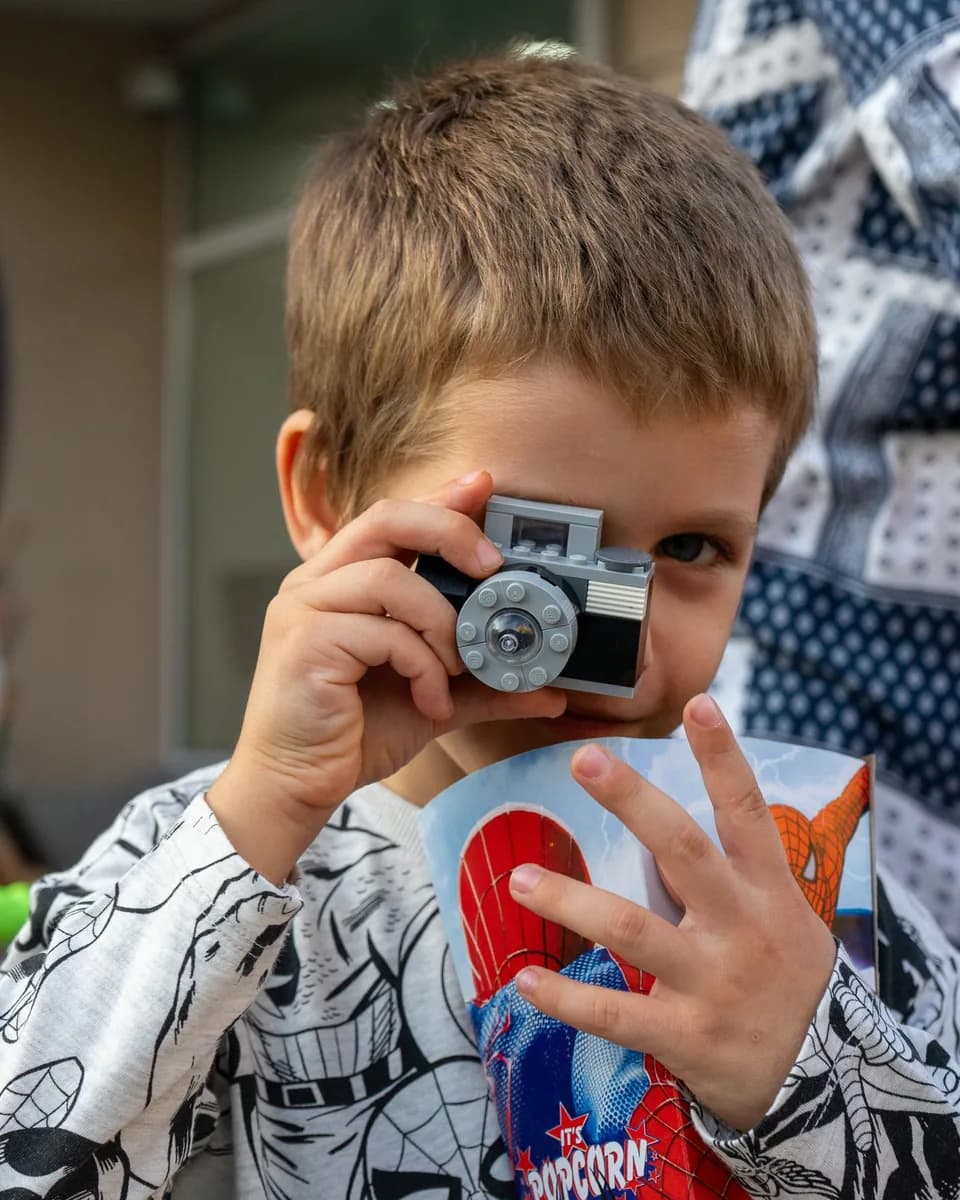
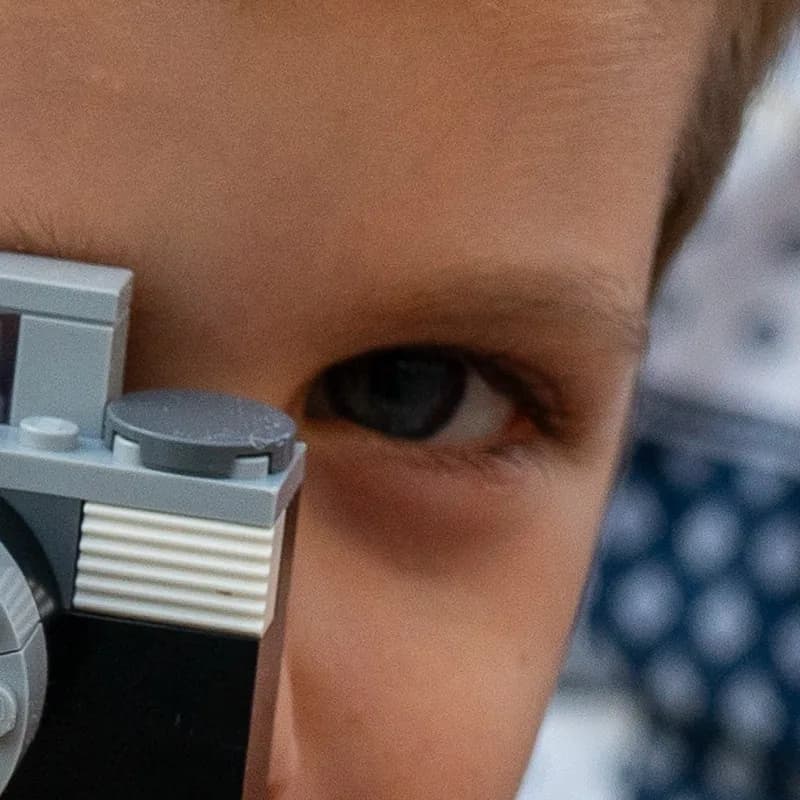
L'œil, en gros plan, tiré du même fichier.
GPT-6.1 Sol seul (API OpenAI, effort « low ») : 7,8/10. FinalFrame (contexte « Sobre & naturel ») : 5,5/10. Une lecture chacun, octobre 2026.
GPT-6.1 Sol (API OpenAI, effort « low », traduit de l'anglais)
7,8/10
GPT-6.1 Sol : « La mise au point est bonne là où cela compte, avec de beaux détails dans les cheveux, l'œil et les mains. » Le plus gros problème qu'il relève : « Ce qui freine le plus cette image, c'est la silhouette qui détourne l'attention à l'arrière-plan, à droite. »
FinalFrame (traduit de l'anglais)
5,5/10
FinalFrame : « le seul œil visible doit porter tout le portrait, et il n'est pas assez net pour une image de portfolio soignée. » Et son verdict : « Je ne passerais pas beaucoup plus de temps à retoucher cette version ; l'idée mérite d'être refaite avec un œil parfaitement net. »
Le modèle seul a salué la mise au point et a donné 7,8. FinalFrame a nommé l'œil flou comme la limite, a donné 5,5 et a conseillé de refaire la photo plutôt que de continuer à la retoucher : ses mots et son chiffre disent la même chose.
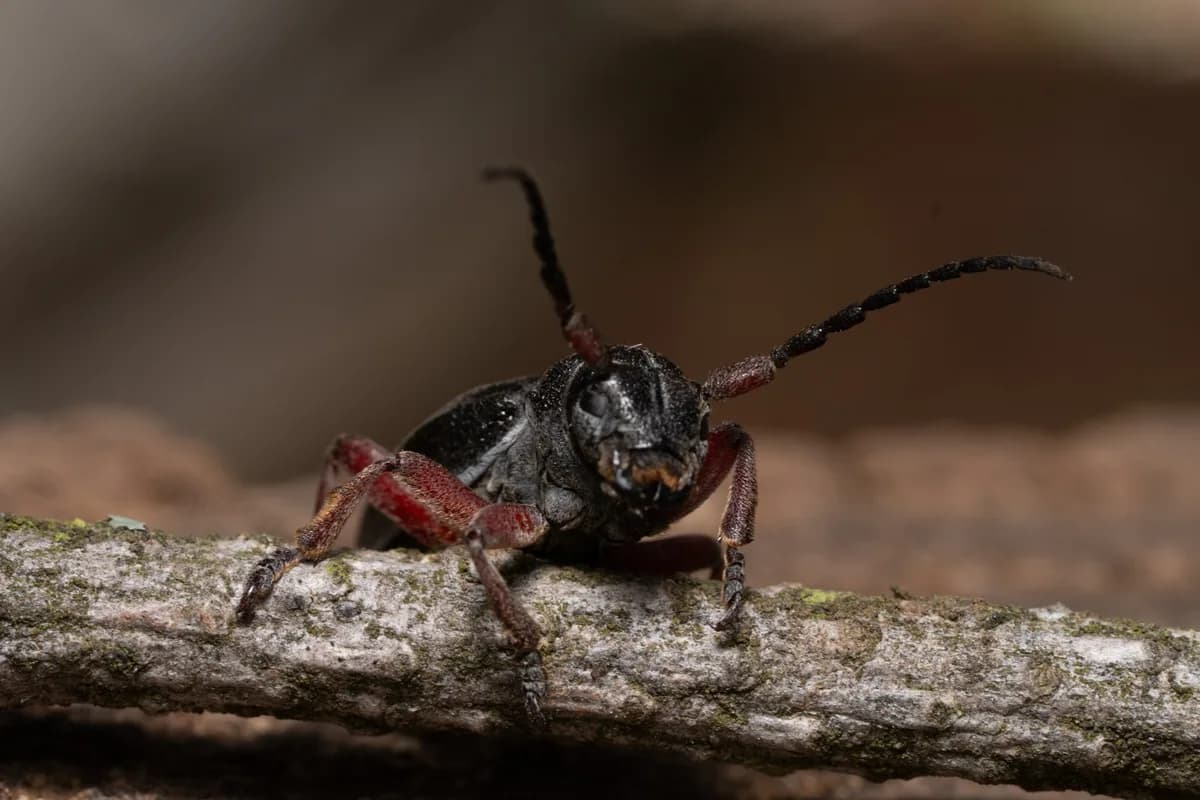
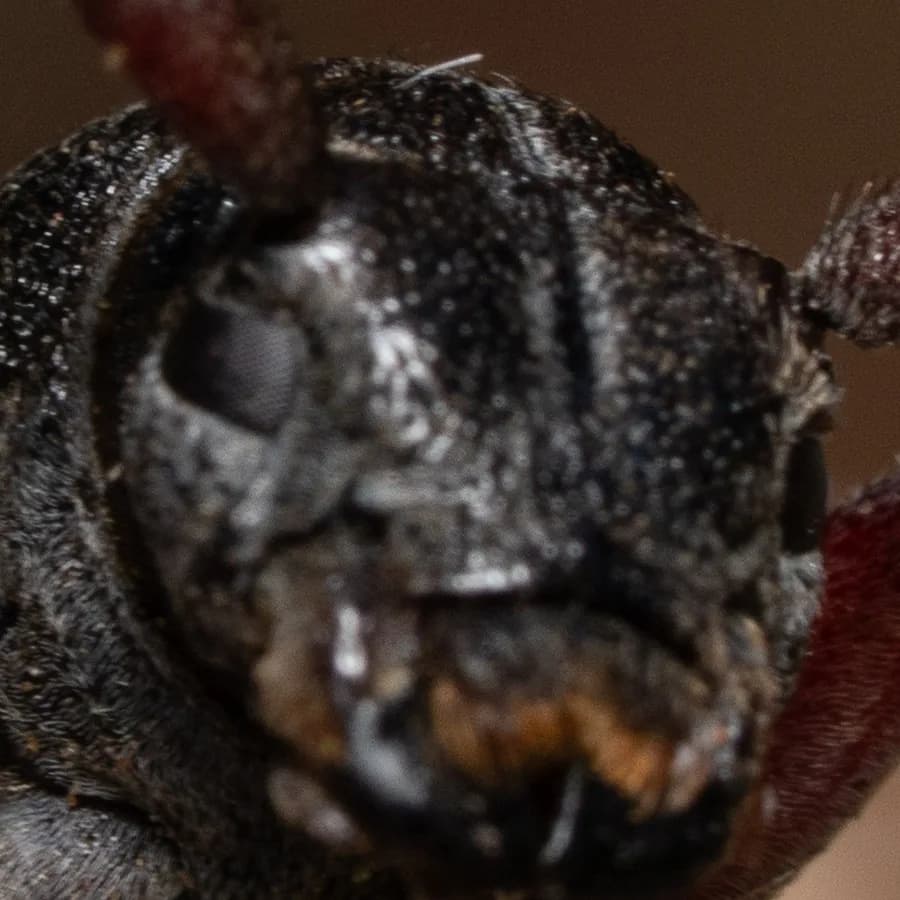
L'œil, en gros plan, tiré du même fichier.
GPT-6.1 Sol seul (API OpenAI, effort « low ») : 7,3/10. FinalFrame (contexte « Sobre & naturel ») : 5,6/10. Une lecture chacun, octobre 2026.
GPT-6.1 Sol (API OpenAI, effort « low », traduit de l'anglais)
7,3/10
GPT-6.1 Sol : « Ce qui freine le plus cette image, c'est le manque de détails nets autour des yeux et du visage. Ce sont les points focaux naturels, mais ils paraissent légèrement flous… »
FinalFrame (traduit de l'anglais)
5,6/10
FinalFrame : « la zone visage/œil n'est pas rendue avec assez de précision. » Et son verdict : « l'accentuation et le contraste local ne feront pas de cette image une pièce de portfolio nette. »
Ici, les deux ont nommé le visage flou. Le modèle seul, qui avait jugé bonne la mise au point sur la photo de l'appareil jouet, a noté celle-ci seulement un demi-point plus bas : 7,3 contre 7,8. Le 5,6 de FinalFrame dit ce que disent ses mots, y compris que l'accentuation ne réglera pas le problème.
Essayez-le sur une photo que vous avez déjà jugée vous-même : un problème nommé, un oui ou un non sur l'intérêt de retoucher davantage, et la raison quand il dit stop. Puis comparez avec ce que vous auriez dit.
Critiquer une photoLa même demande dans l'application ChatGPT
Le test ci-dessus passait par l'API d'OpenAI. La plupart des gens posent plutôt la question dans l'application ChatGPT, souvent avec leurs conversations précédentes et Memory derrière. Nous avons donc tapé la même demande à la main dans l'application, sur un compte payant avec la fonction Memory activée, en utilisant le modèle et le réglage avec lesquels l'application s'ouvrait (GPT-6, Medium). Nous avons posé la question pour les 2 photos d'exemple ci-dessus, choisies parce que le score du modèle de l'API comptait parmi les plus éloignés du nôtre, et pour 1 photo sans défaut du même ensemble, 3 fois chacune, dans une nouvelle conversation à chaque fois.
Les scores de l'application ont à peine bougé d'une conversation à l'autre : 7,6, 7,6 et 7,8 pour la photo sans défaut, 7,2, 7,2 et 7,1 pour l'appareil photo jouet, 7,2, 7,4 et 7,2 pour le coléoptère. À chacun des 3 tours, elle a placé la photo sans défaut au-dessus des deux photos défectueuses, de 0,2 à 0,7 point. Aucune des 3 réponses sur l'appareil photo jouet, la photo dont la mise au point avait manqué l'œil, n'a remarqué l'œil flou : 2 ont jugé la mise au point bonne (« La mise au point est raisonnablement nette », traduit de l'anglais), la troisième a salué les détails des cheveux, des mains et de l'appareil jouet, c'est-à-dire là où la mise au point était tombée, et les 3 ont mis en cause l'encombrement. Sur le coléoptère, ses mots ont plus bougé que ses chiffres : 2 réponses ont nommé un flou sur la tête, et la troisième a nommé un autre problème, « Le visage du coléoptère est trop sombre » (traduit de l'anglais), et a suggéré de relever les ombres ; le score est resté entre 7,2 et 7,4 dans tous les cas.
Comme ces 2 exemples avaient été choisis pour de grosses erreurs, nous avons ajouté 2 photos qui ne l'avaient pas été : un portrait d'âne issu de notre propre ensemble de calibrage, avec un défaut ordinaire (une lumière plate et vive, et un ciel presque brûlé), et une deuxième photo sans défaut, un panorama au coucher du soleil, 3 conversations chacune. Sur l'âne, l'application a nommé un problème principal différent dans chacune des 3 conversations : la lumière, puis l'espace vide, puis la tête de l'âne sur les arbres derrière lui ; chacun un point juste sur cette photo, dont 2 figurent dans l'évaluation de notre fondateur lui-même, mais un différent à chaque fois. FinalFrame, lancé 3 fois sur le même fichier, a nommé chaque fois le ciel lumineux qui prend le pas sur la tête, lui a donné 7,0 chaque fois et a proposé chaque fois le même plan de retouche. Sur le panorama, les 3 réponses de l'application et les 3 passages de FinalFrame ont tous désigné le premier plan sombre. Sur ces 2 photos, les scores de l'application se situaient à moins d'un demi-point de ceux de FinalFrame ; les grands écarts sur l'appareil photo jouet et le coléoptère concernaient les 2 photos choisies pour de grosses erreurs.
Via l'API, GPT-6.1 Sol avait noté les 3 premières photos 8,2, 7,8 et 7,3 avec l'effort sur « low ». La série dans l'application en diffère sur plus que Memory : un autre modèle (GPT-6, pas GPT-6.1 Sol), un autre réglage d'effort, et tout ce que l'application ajoute à une conversation. Il s'agissait d'un seul compte, celui du fondateur, avec Memory activée, si bien que des conversations antérieures ont pu influencer les suivantes. Cela montre donc ce que vous obtenez de ChatGPT tel que vous l'utiliseriez, et non de combien la seule fonction Memory fait bouger un score. Les scores sont sur la page comment nous avons testé (en anglais).
Trois façons de faire critiquer une photo
Chaque ligne a ses exceptions. La colonne chatbot résume ce que des photographes et une équipe de recherche ont publié entre novembre 2025 et août 2026, des expériences isolées plutôt qu'un test contrôlé, et les chatbots changent souvent. Nos propres tests d'un modèle seul, via l'API d'OpenAI et à la main dans l'application ChatGPT, sont présentés au-dessus du tableau et ne font pas partie de cette colonne.
| Un chatbot, interrogé au cas par cas | FinalFrame | Un critique humain | |
|---|---|---|---|
| Fondamentaux techniques | Bien noté par un testeur sur ses propres images finies ; pas testé sur une photo au défaut connu (TechRadar, déc. 2025) | Mesuré en sept. 2026, sur une version antérieure : flou signalé dans 75 des 80 lectures de photos nettement floues, 0 fausse alerte dans 100 lectures de photos nettes ; lu sur une copie enregistrée de votre photo, pas sur votre fichier d'origine, avec la vérification de la mise au point sur le détail clé comme étape à part entière | Solide ; un mentor peut vérifier tout le fichier à 100 % |
| Intention et règles enfreintes volontairement | Aveugle sauf si on le lui dit (Venture Photography, nov. 2025) | Prend votre objectif sous la forme du contexte que vous choisissez parmi 6, et juge par rapport à lui ; au-delà, il ne peut pas connaître l'intention, le dit, et vous laisse signaler que le problème nommé ne correspond pas à votre photo | Ce qu'il fait de mieux |
| La même photo, relue | Non mesuré dans les articles publiés sur lesquels s'appuie cette colonne ; la réponse change selon la façon dont vous demandez (TechRadar, déc. 2025) | Mesuré à chaque série de tests complète ; oct. 2026, 77 critiques lues 3 fois : jamais plus de 0,4 point d'écart sur les 3 lectures, le même Score FinalFrame aux 3 pour 47 ; le même palier en lettre pour 71 | Peut varier avec la fatigue, l'humeur et l'ordre des images présentées, c'est pourquoi les salons réunissent un jury |
| Ce qu'il tranche | Commente presque tous les aspects, dans les tests d'une prépublication de 2026 ; pas de verdict fixe (arXiv:2606.29689) | Un problème tiré d'une liste fixe ; un indicateur d'arrêt avec sa raison ; un oui ou un non « Mérite l'effort » | Ce qui compte le plus pour lui ; un bon critique vous dira quand une image est terminée, ou ne mérite pas plus de temps |
| Rapidité et disponibilité | De quelques secondes à quelques minutes, à toute heure | Environ une minute, à toute heure, après les mesures décrites plus haut | Des heures sur un forum ; une semaine ou plus pour une soirée de club ou un mentor |
Lisez la colonne FinalFrame comme un modèle entouré d'un processus de mesure. Lisez la colonne de droite comme celle pour laquelle vous préparez la photographie.
Là où un critique humain garde l'avantage
L'intention. Toutes les sources de cette page aboutissent ici. Venture Photography, une école de stages photo, dans un billet de novembre 2025 (signé sengmah) : « l'IA ne peut évaluer que ce qu'elle voit visuellement, pas si vous avez atteint votre objectif artistique ». (Venture Photography, 24 nov. 2025) Geoff Harris, d'Amateur Photographer, a soumis une image d'Henri Cartier-Bresson à ChatGPT en novembre 2025 et a reçu une liste d'améliorations dont l'une, écrit-il, « ferait se retourner HCB dans sa tombe ». (Amateur Photographer, 17 nov. 2025) Un critique humain qui vous connaît, ou qui vous demande simplement ce que vous cherchiez, lit l'horizon penché comme l'idée. Un modèle le lit comme un horizon penché ; c'est souvent le cas aussi d'un juge de salon, qui voit l'image sans son auteur pour l'expliquer.
La page de FinalFrame sur la notation dit que la critique « ne peut pas connaître votre intention » et qu'« un horizon penché peut être toute l'idée ». Ce qu'elle prend en compte, c'est votre objectif : vous choisissez un contexte (Sobre & naturel, Ambiance & style, Prêt à imprimer, Prêt pour le concours, Réseaux sociaux ou Travail client) et la photo est jugée par rapport à lui. Même photo, autre contexte, autre score, et c'est tout l'intérêt. L'ensemble étiqueté contient des photos au style délibéré (des yeux derrière des lunettes de soleil ou un bord de chapeau, un flou de mouvement voulu) pour qu'un choix stylistique ne soit pas lu comme une raison de refaire la photo ; le chiffre de 0 sur 132 cité plus haut les inclut. La critique peut tout de même dire ce que ce choix coûte dans le contexte que vous avez choisi. La règle de lecture est celle de la page sur la notation : accordez moins de poids à un défaut signalé quand il s'agissait d'une décision délibérée. Pour en savoir plus sur les erreurs possibles de l'IA, voyez la page Comment fonctionne le Score FinalFrame.
L'émotion et le public. Un critique humain peut vous dire si l'image l'a touché, et comment elle se lit à côté du reste de votre travail. Les paliers de FinalFrame sont calibrés sur le jugement des salons internationaux (les expositions PSA et FIAP), et c'est un étalon utile auquel se mesurer ; cela reste un étalon, pas un juré. La conclusion de Harris est celle que la plupart des photographes reconnaîtront : « aucun grand concours photo digne de ce nom ne congédierait son jury pour faire appel à ChatGPT à la place ». (Amateur Photographer)
Le problème de la sélectivité : ce qu'a trouvé une prépublication de 2026
La preuve publiée la plus directe que nous ayons trouvée est une prépublication de juin 2026 signée Sajjad Ghiasvand et quatre coauteurs, « Can MLLMs Critique Like Humans? », qui a évalué huit modèles à poids ouverts plus GPT-5.5 par rapport à des critiques humaines classées de 1 227 messages de r/photocritique. (arXiv:2606.29689, v2 31 août 2026) Deux résultats comptent ici.
Premièrement, les modèles de pointe ont remporté la préférence des évaluateurs : dans la condition principale, les 4 évaluateurs LLM « préfèrent les critiques des modèles de pointe aux critiques humaines ». Mais quand on leur a demandé à quel point chaque critique de modèle ressemblait sur le fond à la critique humaine, les évaluateurs et 2 annotateurs humains ont donné à chaque modèle entre 1,81 et 2,59 sur une échelle de 5 points, « proche de “majoritairement différent” ». (arXiv:2606.29689)
Deuxièmement, et c'est celui-là qu'il faut retenir : « les modèles divergent d'une manière que les scores ne font pas apparaître : ils couvrent presque tous les aspects esthétiques là où les humains sont sélectifs, et se répètent d'une critique à l'autre d'une même photo, même quand on leur demande d'écrire à longueur humaine ». Couvrir tous les aspects n'est pas trouver tous les problèmes : les auteurs ont aussi constaté que « retirer l'image ne change presque rien » aux scores de similarité automatiques, et que la mesure habituelle « récompense un style de critique fluide et exhaustif plutôt que la sélectivité et la précision de la critique humaine ». (arXiv:2606.29689) En clair : livré à lui-même, un modèle commente presque tout, et les scores automatiques de l'article ont à peine bougé quand le modèle n'avait jamais vu la photo. Un bon critique regarde d'abord, puis en laisse la plus grande partie de côté.
La conception de FinalFrame répond aux deux moitiés de ce constat, même si nous ne lui avons pas fait passer le test de l'article. La mesure décrite plus haut rattache les lectures techniques aux pixels. La moitié qui concerne la sélectivité est un choix pédagogique antérieur à l'article : la critique nomme un problème, choisi selon ce qu'il coûte à l'image dans votre contexte, et commence par celui-là, pour que la prochaine retouche ait une seule cible. Savoir si ce problème est celui que vous auriez nommé est une question légitime ; le bouton « Ne correspond pas à ma photo », juste en dessous, vous permet de le signaler quand ce n'est pas le cas.
La constance : la partie difficile, et ce que nous avons mesuré
La constance est l'une des parties difficiles de toute critique, humaine ou par IA. Dans une étude de 4 ans menée lors d'un grand concours de vins américain, des juges à qui l'on servait le même vin 3 fois au cours d'une même séance lui donnaient souvent des notes différentes, certains du bronze à l'or (Hodgson, Journal of Wine Economics, 2008) ; nous n'avons trouvé aucune étude de ce type sur les juges photo. Un modèle peut lui aussi lire la même photo différemment, le nôtre compris. Aucune source publiée que nous ayons trouvée ne l'a mesuré, ni pour un chatbot ni pour une application de critique, si bien que cette section porte sur le nôtre ; c'est aussi un test que vous pouvez faire sur l'outil que vous utilisez, nous compris : envoyez la même photo 3 fois et comparez. La page de FinalFrame sur la notation dit qu'« une nouvelle lecture de la même photo peut aboutir à un résultat légèrement différent », et cela reste vrai. Ce que nous avons fait, c'est mesurer de combien, puis le contenir.
Lors de la série d'octobre 2026, 77 critiques de 73 photographies, chacune lue 3 fois sur un ensemble chargé de cas limites, aucune n'a bougé de plus de 0,4 point sur les 3 lectures, et 47 des 77 ont obtenu le même Score FinalFrame aux 3 ; le palier en lettre était identique aux 3 lectures pour 71 des 77, l'avis « Mérite l'effort » pour 73, et la décision d'arrêt pour 75. Nous y sommes arrivés en mesurant d'abord : en août 2026, sur 10 photos lues 5 fois chacune, un changement dans la façon dont le modèle est exécuté a réduit de moitié l'écart médian entre le score potentiel le plus haut et le plus bas d'une photo (jusqu'où la retouche pourrait la mener), de 0,8 point à 0,4. Cet écart est désormais rapporté à chaque série de tests complète ; les chiffres d'octobre ci-dessus viennent de l'une de ces séries.
Une limite. Le problème nommé se répète moins fidèlement que le score : lors d'une série de septembre 2026 sur une version antérieure, 71 photos lues 5 fois chacune, le même problème venait en tête dans au moins 4 des 5 lectures pour 59 d'entre elles, et dans les 5 pour 40, si bien qu'une nouvelle lecture peut commencer par un autre problème.
Comment utiliser les deux
Traitez-les comme deux instruments différents plutôt que comme des rivaux. Utilisez la lecture par IA dans la boucle de retouche : corrigez la seule chose qu'elle nomme, téléversez la nouvelle version, regardez si la correction a porté, et arrêtez quand l'indicateur d'arrêt dit pourquoi. Sur la nouvelle version, la critique dit si le problème précédent est résolu, partiellement résolu ou toujours présent, et une variation de score de 0,1 ou moins est signalée comme « dans la variation normale » au lieu d'être présentée comme un progrès.
Faites appel aux gens là où l'IA vous a dit qu'elle était aveugle. Apportez la version finie à une soirée critique de club photo ou sur un forum comme r/photocritique, et posez une seule question : cette image dit-elle ce que je voulais dire ? Vous obtiendrez la lecture émotionnelle, la lecture du contexte, et parfois un « cette photo me laisse indifférent », qu'aucun modèle ne vous donnera. Quand les deux sont en désaccord sur un défaut technique, le fichier tranche, à 100 % et à la taille à laquelle il sera montré ; quand ils sont en désaccord sur le fait que l'image fonctionne, c'est l'humain qui répond à la question qui compte.
Si vous savez déjà nommer le symptôme (une image plate, un ciel blanc, un œil flou), allez directement à la page des diagnostics, qui oriente chacun vers sa leçon. Et si l'image est limitée par la prise de vue, aucune retouche ne lève cette limite : la question devient de savoir si elle fonctionne telle quelle ou mérite d'être refaite. Si vous cherchez la méthode que suit une critique plutôt qu'une comparaison de ceux qui la donnent, lisez la page Comment critiquer une photo.
Questions fréquentes sur la critique photo par IA
- ChatGPT peut-il critiquer mes photos ?
- Oui, et avec une requête détaillée, il s'en sort mieux. Peter Fenech, de TechRadar, a constaté qu'il risquait de « garder un retour générique » tant qu'il ne décrivait pas son intention, et soupçonnait encore qu'une grande partie venait de « réponses toutes faites ». (TechRadar, déc. 2025 ; Amateur Photographer, nov. 2025) OpenAI indique que lorsque Memory est activée, ChatGPT peut retenir des détails de vos conversations passées et s'en servir pour personnaliser ses réponses (OpenAI Help Center, « Memory in ChatGPT », consulté en octobre 2026). Si vous voulez un retour sur la photo qui ne soit pas façonné par ce que ChatGPT sait de vous, ouvrez une conversation temporaire et, là où le choix est proposé, sélectionnez « Unpersonalized » (non personnalisé). Aucun des deux articles de magazine ne l'a testé sur une photo au défaut connu, et aucun n'a mesuré s'il lit deux fois la même photo de la même façon. Ce qu'ajoute FinalFrame se trouve hors de la requête : une vérification de la mise au point sur le détail qui compte, menée comme une étape à part entière, des lectures testées sur des photos aux défauts connus, et une réponse mesurée à la question de savoir de combien varie une nouvelle lecture.
- La critique photo par IA est-elle exacte ?
- Cela dépend de ce qui a été mesuré, alors demandez les chiffres. Ceux de FinalFrame, issus de ses propres séries de tests étiquetées : flou signalé dans 75 des 80 lectures d'images nettement floues et à tort dans 0 des 100 lectures d'images nettes (septembre 2026, sur une version antérieure), et sur 77 critiques de 73 photographies, chacune lue 3 fois, le même palier aux 3 lectures pour 71 (octobre 2026). Côté intention, il connaît le contexte que vous choisissez : l'étalon au regard duquel il juge. Ce qu'il ne peut pas savoir, c'est qu'un choix à l'intérieur de l'image était délibéré, si bien qu'un ciel volontairement surexposé ou une inclinaison intentionnelle peuvent se lire comme un défaut ; accordez moins de poids à cette remarque. Ses Conditions d'utilisation qualifient le résultat d'« avis algorithmique », pas d'évaluation d'expert. Traitez-le comme un deuxième avis mesuré au regard d'un étalon nommé.
- Les retours de l'IA vont-ils rendre mes photos banales ?
- Cela peut arriver, si vous appliquez tout ce que dit un modèle généraliste : la prépublication de 2026 a constaté que les modèles « couvrent presque tous les aspects esthétiques là où les humains sont sélectifs », et que leur similarité avec les critiques humaines reflète « un style de critique stable plus qu'une observation propre à l'image » (arXiv:2606.29689) ; corriger 10 remarques d'un coup, c'est ainsi qu'une image singulière devient une image simplement correcte. FinalFrame nomme un seul problème par critique, choisi selon ce qu'il coûte à l'image dans le contexte que vous avez choisi. Corrigez-le, téléversez la nouvelle version et regardez si la correction a porté. Si la seule chose qu'il nomme est un choix que vous avez fait volontairement, gardez-le.
- Existe-t-il une critique photo par IA gratuite ?
- Oui. La page d'accueil de FinalFrame propose une critique de démonstration gratuite sans compte (le palier, les scores, le point bloquant nommé et le verdict ; les ajustements de retouche complets nécessitent un compte gratuit), et un compte gratuit donne droit à 3 critiques par mois, 1 crédit chacune, plus jusqu'à 2 crédits bonus, gagnés une seule fois quand vous téléversez une version retouchée.
Voyez une critique mesurée d'une image que vous connaissez bien
Téléversez une photographie sur laquelle vous avez déjà un avis. FinalFrame lit sa mise au point et vérifie si elle a une limite de prise de vue, nomme le problème qui lui coûte le plus, et dit si davantage de retouche en vaut la peine, et pourquoi quand il dit stop. Les valeurs de curseurs pour cette correction viennent avec un compte gratuit. Comparez avec ce que vous auriez dit ; les écarts dans les deux sens sont la partie utile.
Critiquer une photoChatGPT et OpenAI sont des marques d'OpenAI. FinalFrame n'est ni affilié à OpenAI ni approuvé par OpenAI.