AI बनाम इंसानी फ़ोटो समीक्षा: चैटबॉट, समीक्षा टूल और इंसान में से हर एक क्या पकड़ता है
AI फ़ोटो समीक्षा उतनी ही अच्छी होती है जितना मॉडल के इर्द-गिर्द बनाया और मापा गया ढाँचा। आम चैटबॉट उस सवाल का जवाब देता है जो आपने टाइप किया। FinalFrame पहले फ़ोटो को मापता है, हर बार उससे वही तय सवाल पूछता है, और अपनी रीडिंग को उन फ़ोटो पर परखता है जिनकी खामियाँ पहले से मालूम हैं। आपको मिलती है आपके चुने हुए मानक के मुक़ाबले एक मापी गई दूसरी राय: एक नामित समस्या, आपके एडिटर में उसके लिए स्लाइडर मान, और यह फ़ैसला कि और एडिटिंग सार्थक है या नहीं, ताकि अगले एडिट को एक दिशा मिले। इरादे पर, और तस्वीर असर छोड़ती है या नहीं, इस पर इंसानी समीक्षक अब भी आगे है।
अगर आपने कभी किसी चैटबॉट में फ़ोटो डालकर पूछा है “आपको क्या लगता है?”, तो आप शायद वह जवाब पहचानेंगे जो 2025 के आख़िर में ChatGPT को परखने वाले फ़ोटोग्राफ़र बताते हैं: एक गर्मजोशी भरी शुरुआत, जो काम कर रहा है उसकी एक सूची, और एक-दो हल्के-फुल्के सुझाव। इस पेज में समीक्षा शब्द जिस अर्थ में इस्तेमाल हुआ है, वैसी समीक्षा हर बार फ़ोटो से वही तय सवाल पूछती है, उसकी तकनीकी स्थिति मापती है, एक समस्या का नाम लेती है, और तय करती है कि आगे क्या करना है।
अगर आप तय कर रहे हैं कि अगली फ़ोटो कहाँ भेजें, तो यह पेज FinalFrame के मापे गए आँकड़े तारीख़ों के साथ देता है, दिखाता है कि उसी अनुरोध पर चैटबॉट का जवाब कैसा दिखता है, और बताता है कि कोई इंसान अब भी कहाँ बेहतर करता है।
AI फ़ोटो समीक्षा क्या है, और यह किसी चैटबॉट से पूछने से कैसे अलग है
आम चैटबॉट उसी प्रॉम्प्ट का जवाब देता है जो उसे मिलता है। उसे एक फ़ोटो और एक अस्पष्ट सवाल दें, और वह ख़ुद चुन लेता है कि किस बारे में बात करे। Digital Photographer के पूर्व संपादक, TechRadar के Peter Fenech ने दिसंबर 2025 में ठीक यही परीक्षण किया और पहले दौर का सार एक पंक्ति में दिया: “सामान्य प्रॉम्प्ट मिलने पर, यह फ़ीडबैक को भी शायद सामान्य ही रखेगा।” जिन लंबे प्रॉम्प्ट में उनका इरादा बताया गया, उनसे उन्हें ज़्यादा केंद्रित जवाब मिले। (TechRadar, 31 दिसंबर 2025)
बेहतर प्रॉम्प्ट से बेहतर ढाँचे वाला जवाब मिलता है; Fenech ने ठीक यही पाया। FinalFrame जो जोड़ता है, वह प्रॉम्प्ट में नहीं है। समीक्षा लिखे जाने से पहले वह फ़ोटो को मापता है: फ़ाइल में दर्ज कैमरा डेटा पढ़ता है, और जो डिटेल मायने रखती है उस पर फ़ोकस को, एक अलग चरण के रूप में, क़रीब से जाँचता है। फिर हर समीक्षा उन्हीं तय सवालों का, एक तय क्रम में, जवाब देती है, इसलिए रीडिंग किन बातों को छूती है, यह इस पर निर्भर नहीं करता कि आपने कितनी अच्छी तरह पूछा। FinalFrame एक OpenAI मॉडल पर चलता है, जैसा उसकी सेवा की शर्तें बताती हैं। मॉडल परिणाम का एक हिस्सा है। बाक़ी हिस्सा है मॉडल के लिखने से पहले का मापना, और वह जो लिखता है उसे उन फ़ोटो पर परखना जिनकी खामियाँ पहले से मालूम हैं; अगला खंड आँकड़े देता है।
यहाँ तीन सवाल सबसे ज़्यादा मायने रखते हैं। क्या फ़्रेम वहाँ शार्प है जहाँ ज़रूरी है, और समस्या दोबारा शूट की है या डेस्क पर ठीक होने वाली: ये वे 2 रीडिंग हैं जिन्हें हम सबसे कड़ाई से परखते हैं। कौन-सी एक समस्या फ़्रेम का सबसे ज़्यादा नुक़सान करती है, जिसका नाम एक तय सूची से लिया जाता है और जिसे इस हिसाब से चुना जाता है कि आपकी चुनी लेन में वह फ़्रेम का कितना नुक़सान करती है, और लेन वह पैमाना है जिस पर आप चाहते हैं कि आपकी फ़ोटो आँकी जाए (स्वच्छ & स्वाभाविक, मूड & स्टाइल, प्रिंट के लिए तैयार, प्रतियोगिता के लिए तैयार, सोशल या क्लाइंट डिलीवरी)। और क्या आपको एडिटिंग जारी रखनी चाहिए: कारण के साथ रुकने का संकेत, साथ में “सार्थक है या नहीं” का एक फ़ैसला जो हाँ या ना होता है। जवाब के साथ यह भी आता है कि क्या बदलना है: उस एक समस्या के लिए स्लाइडर मान, उस एडिटर में जिसे आपने अपनी प्राथमिकताओं में चुना है (Lightroom, Capture One, Photoshop और दूसरे); एडिट किया हुआ वर्ज़न अपलोड करें, और अगली समीक्षा बताती है कि वह समस्या हल हो गई, आंशिक रूप से हल हुई या अभी भी मौजूद है। ये सवाल आप किसी चैटबॉट में टाइप कर सकते हैं; जो आप टाइप नहीं कर सकते, वह है पहले सवाल के पीछे की फ़ोकस जाँच, जानी-पहचानी खामियों वाली फ़ोटो पर की गई वह परख जिसकी रिपोर्ट अगला खंड देता है, या इस बात का माप कि आपके एडिट ने क्या बदला: हर नया वर्ज़न पहले अपने आप में स्कोर होता है, फिर पिछले वर्ज़न के मुक़ाबले मापा जाता है, और उसी फ़ाइल को दोबारा अपलोड करने पर उसे “एक ही छवि” के रूप में चिह्नित किया जाता है।
AI समीक्षा कहाँ मज़बूत है, और हम यह कैसे जानते हैं
शुरुआत तकनीकी रीडिंग से करें। Fenech की आख़िरी राय यह थी कि “AI तकनीकी विश्लेषण में बहुत अच्छा है,” लेकिन उन्होंने अपने ही तैयार फ़्रेम परखे थे, और हमें मिले किसी भी लेख ने किसी जानी-पहचानी खामी वाली फ़ोटो को नहीं आज़माया। (TechRadar; Amateur Photographer, नवंबर 2025; Venture Photography, नवंबर 2025) इसलिए हमने अपनी समीक्षा को परखा। सितंबर 2026 में समीक्षा के एक पुराने वर्ज़न पर किए गए हमारे पिछले पूरे फ़ोकस टेस्ट में, साफ़ तौर पर नरम 16 फ़ोटो में से हर एक को 5 बार पढ़ा गया: उसने 80 में से 75 रीडिंग में नरमी पकड़ी, और 20 शार्प फ़ोटो की 100 रीडिंग में एक बार भी किसी को नरम नहीं कहा। अक्टूबर 2026 के एक रन में, उन फ़ाइलों पर जिनमें कैमरा डेटा मौजूद था, उसने कैप्चर की असली सीमा वाली 15 फ़ोटो की सभी 45 रीडिंग में वह सीमा पकड़ी, और उन 44 फ़ोटो की 132 रीडिंग में दोबारा शूट का 0 ग़लत फ़ैसला दिया जिनमें किसी स्टाइल के चुनाव या ठीक हो सकने वाली खामी को ऐसी सीमा नहीं पढ़ा जाना चाहिए। ये हमारी अपनी फ़ोटो और लेबल हैं, जिन्हें मुश्किल होने के लिए चुना गया; आपकी फ़ोटो इस सेट में नहीं हैं।
दूसरी बात है रुकना। पहली समीक्षा पर FinalFrame रुकने की शर्तों का एक तय सेट जाँचता है, और जब फ़्रेम में कैप्चर के स्तर की ऐसी सीमा हो, यानी शटर दबने के पल में तय हो चुकी कोई खामी, जैसे सब्जेक्ट से चूका हुआ फ़ोकस, जिसे कोई एडिट हटा नहीं सकता, तो वह पहले भी रुकने को कह सकता है; तब कारण उस सीमा का नाम लेता है और फ़्रेम को घंटा भर लगाने लायक़ नहीं माना जाता। कम ही दोस्त आपसे कहेंगे कि जिस फ़ोटो को एडिट करने में आपको साफ़ तौर पर मज़ा आ रहा है, उसकी एडिटिंग रोक दें, और जो मेंटर यह कहे, वह हमेशा पास नहीं होता; यह संकेत वह फ़ैसला हर समीक्षा में रख देता है। उस संकेत को पढ़ने वाला पाठ फ़ोटो की एडिटिंग कब रोकें है।
तीसरी बात है ख़ुद स्कोर: क्या वह खामी वाली फ़ोटो को दुरुस्त फ़ोटो से नीचे रखता है? अक्टूबर 2026 में हमने उन लेबल किए गए टेस्ट सेटों की 42 फ़ोटो को स्कोर किया जिन पर हम FinalFrame के हर नए वर्ज़न को परखते हैं: 16 जानी-पहचानी खामी वाली (उनमें से 15 में फ़ोकस की समस्या) और 26 बिना खामी वाली। दुरुस्त फ़ोटो और खामी वाली फ़ोटो की 416 जोड़ियों में से 412 में (99%), FinalFrame ने दुरुस्त फ़ोटो को ज़्यादा स्कोर दिया; दुरुस्त फ़ोटो का औसत 7.0 रहा, खामी वाली फ़ोटो का 5.4।
उन्हीं फ़ोटो पर, GPT-6.1 Sol ने, जिसे OpenAI के API के ज़रिए (ChatGPT ऐप से नहीं) सिर्फ़ फ़ोटो और समीक्षा व 1-10 के स्कोर का एक छोटा-सा अनुरोध दिया गया, कम रीज़निंग प्रयास वाली सेटिंग पर दुरुस्त फ़ोटो को औसतन 7.7 और खामी वाली फ़ोटो को 6.7 दिए (ज़्यादा रीज़निंग प्रयास वाली सेटिंग पर 7.7 और 6.6): दोनों समूहों के बीच लगभग 1 अंक, जबकि FinalFrame ने 1.6 का फ़ासला रखा। तरीक़ा, प्रॉम्प्ट और हर फ़ोटो के स्कोर: हमने कैसे परखा (अंग्रेज़ी में)।
सादा मॉडल एक सक्षम मॉडल है जिसे कुछ वाक्यों के निर्देश दिए गए हैं; उसके बगल में FinalFrame को रखें, तो जो दिखता है वह यह है कि मॉडल के इर्द-गिर्द क्या बनाया गया है, यह नहीं कि कौन-सा मॉडल बेहतर है। FinalFrame मॉडल के इर्द-गिर्द जो बनाता है, वह एक ऐसी समीक्षा है जिसे संदर्भ की तरह इस्तेमाल करने के लिए बनाया गया है: ऐसा स्कोर जो फ़ोटो में खामी होने पर गिरता है, एक नामित समस्या, यह फ़ैसला कि और एडिटिंग सार्थक है या फ़्रेम को दोबारा शूट की ज़रूरत है, वह बदलाव जो स्कोर को सबसे ज़्यादा बढ़ाएगा, और आपकी चुनी लेन में अगले एडिट के लिए स्लाइडर मान। नीचे की दो फ़ोटो दिखाती हैं कि एक सादा जवाब और उसका स्कोर कहाँ एक-दूसरे से अलग हो सकते हैं।
खामी वाली दो फ़ोटो: हर एक ने क्या लिखा, और कितना स्कोर दिया
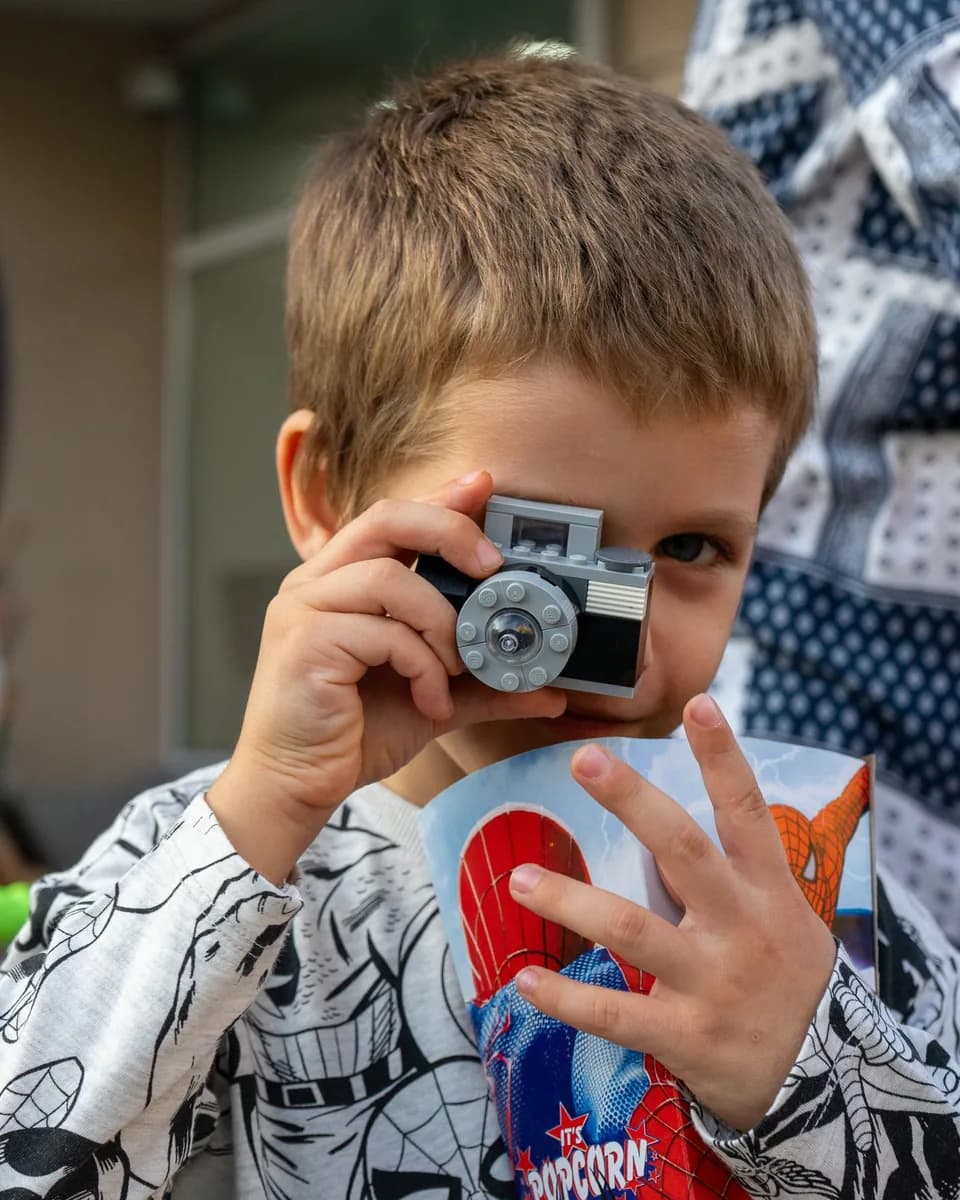
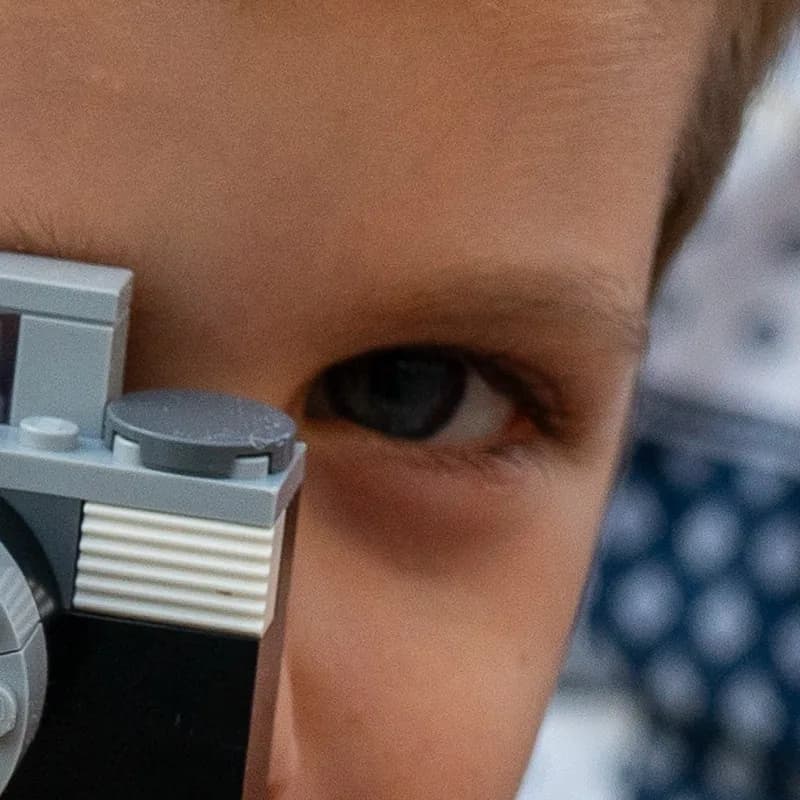
आँख, क़रीब से, उसी फ़ाइल से।
सादा GPT-6.1 Sol (OpenAI API, कम रीज़निंग प्रयास): 7.8/10। FinalFrame (स्वच्छ & स्वाभाविक लेन): 5.5/10। दोनों की एक-एक रीडिंग, अक्टूबर 2026।
GPT-6.1 Sol (OpenAI API, कम रीज़निंग प्रयास; अंग्रेज़ी से अनुवाद)
7.8/10
GPT-6.1 Sol: “जहाँ ज़रूरी है वहाँ फ़ोकस अच्छा है, बालों, आँख और हाथों में मनभावन डिटेल के साथ।” उसके हिसाब से सबसे बड़ी समस्या: “इसे पीछे रोकने वाली सबसे बड़ी अकेली चीज़ दाईं ओर पृष्ठभूमि में ध्यान भटकाने वाली आकृति है।”
FinalFrame (अंग्रेज़ी से अनुवाद)
5.5/10
FinalFrame: “दिखाई देने वाली अकेली आँख को पूरा पोर्ट्रेट सँभालना है, और वह साफ़-सुथरी पोर्टफ़ोलियो छवि के लिए पर्याप्त शार्प नहीं है।” और उसका आकलन: “मैं इस वर्ज़न की एडिटिंग में बहुत ज़्यादा और समय नहीं लगाऊँगा; यह विचार आँख पर सटीक फ़ोकस के साथ दोबारा शूट करने लायक़ है।”
सादे मॉडल ने फ़ोकस की तारीफ़ की और 7.8 दिया। FinalFrame ने नरम आँख को सीमा बताया, 5.5 दिया, और एडिटिंग जारी रखने के बजाय दोबारा शूट करने को कहा: उसके शब्द और उसका अंक एक ही बात कहते हैं।
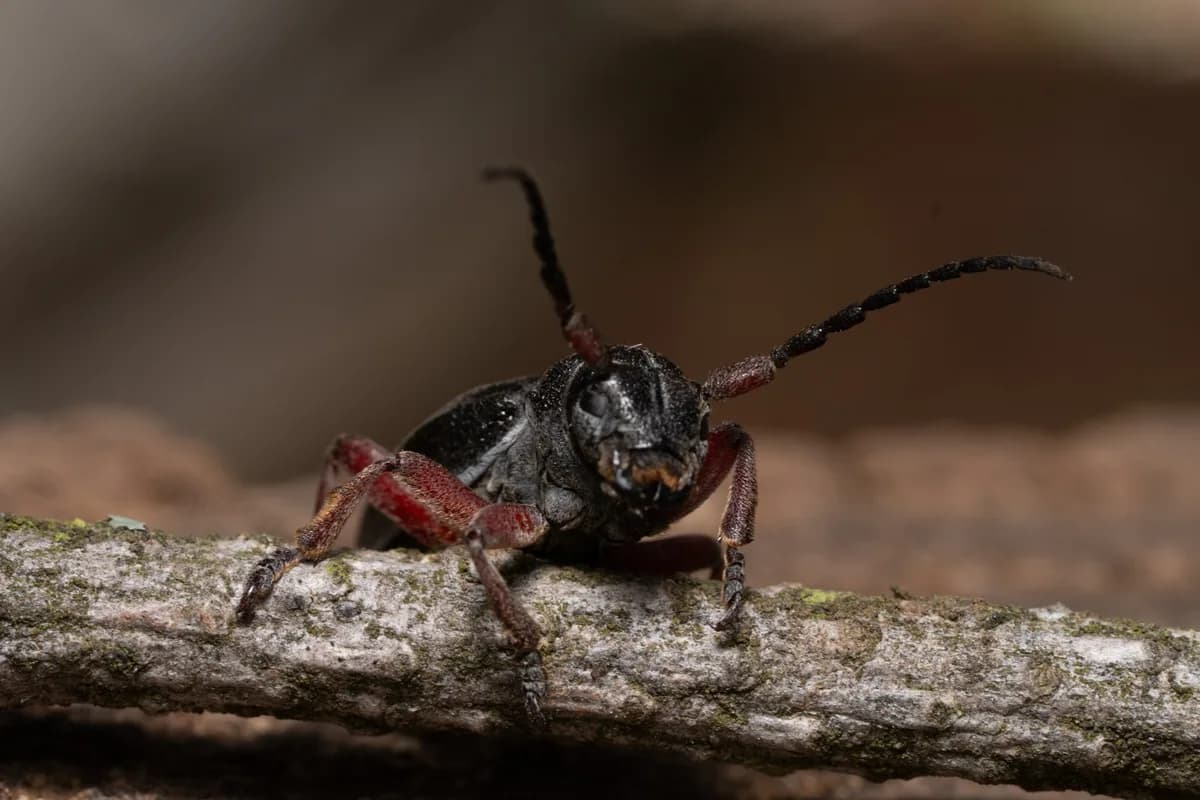
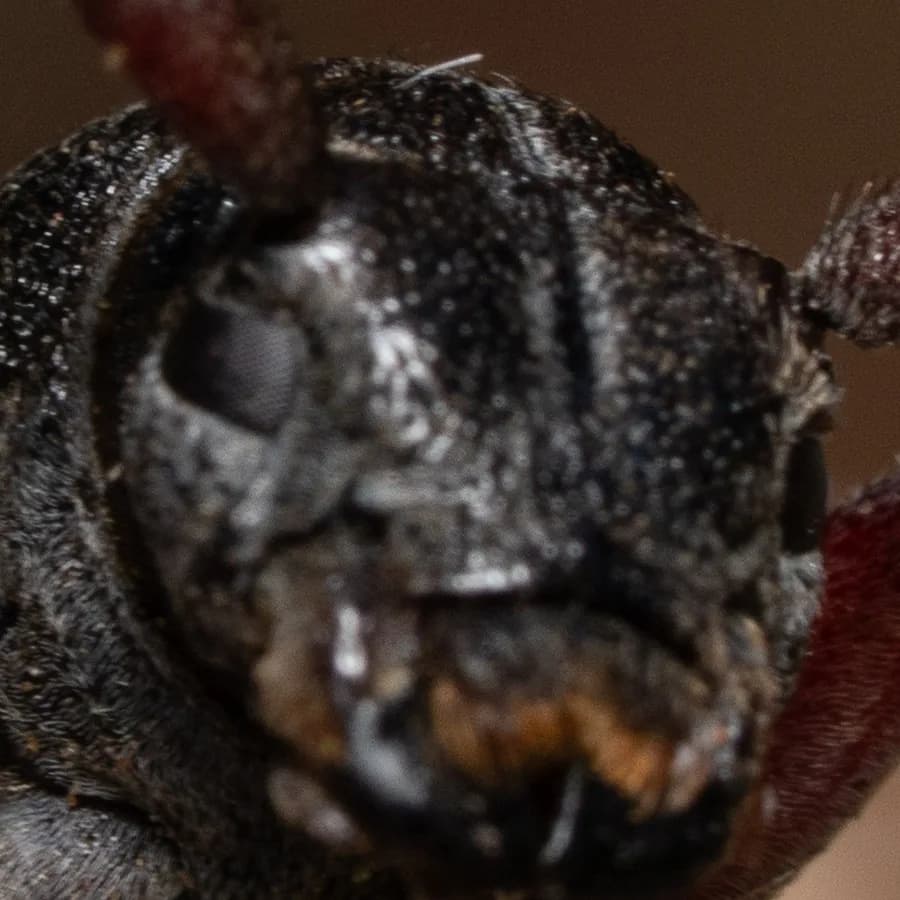
आँख, क़रीब से, उसी फ़ाइल से।
सादा GPT-6.1 Sol (OpenAI API, कम रीज़निंग प्रयास): 7.3/10। FinalFrame (स्वच्छ & स्वाभाविक लेन): 5.6/10। दोनों की एक-एक रीडिंग, अक्टूबर 2026।
GPT-6.1 Sol (OpenAI API, कम रीज़निंग प्रयास; अंग्रेज़ी से अनुवाद)
7.3/10
GPT-6.1 Sol: “इसे पीछे रोकने वाली सबसे बड़ी अकेली चीज़ आँखों और चेहरे के आसपास शार्प डिटेल की कमी है। वही स्वाभाविक फ़ोकल पॉइंट हैं, पर वे थोड़े नरम दिखते हैं…”
FinalFrame (अंग्रेज़ी से अनुवाद)
5.6/10
FinalFrame: “चेहरे/आँख वाला हिस्सा पर्याप्त सटीकता से उभरता नहीं।” और उसका आकलन: “शार्पनिंग और लोकल कंट्रास्ट इसे एक शार्प पोर्टफ़ोलियो फ़ोटो में नहीं बदलेंगे।”
यहाँ दोनों ने नरम चेहरे का नाम लिया। सादे मॉडल ने, जिसने खिलौना कैमरे वाली फ़ोटो के फ़ोकस को अच्छा कहा था, इस फ़ोटो को सिर्फ़ आधा अंक कम दिया: 7.8 के मुक़ाबले 7.3। FinalFrame का 5.6 वही कहता है जो उसके शब्द कहते हैं, और यह भी कि शार्पनिंग इसे ठीक नहीं करेगी।
इसे किसी ऐसी फ़ोटो पर आज़माएँ जिसके बारे में आप पहले ही ख़ुद फ़ैसला कर चुके हैं: एक नामित समस्या, और एडिटिंग सार्थक है या नहीं इस पर हाँ या ना, और रुकने को कहे तो उसका कारण। फिर उसकी तुलना उससे करें जो आप कहते।
किसी फ़ोटो की समीक्षा कराएँChatGPT ऐप में वही अनुरोध
ऊपर वाला टेस्ट OpenAI के API के ज़रिए हुआ। ज़्यादातर लोग इसके बजाय ChatGPT ऐप में पूछते हैं, अक्सर पीछे अपनी पिछली चैट और Memory फ़ीचर के साथ। इसलिए हमने वही अनुरोध हाथ से ऐप में टाइप किया, एक सशुल्क खाते पर जिसमें Memory चालू था, उसी मॉडल और सेटिंग के साथ जिनके साथ ऐप खुला (GPT-6, Medium)। हमने ऊपर की 2 उदाहरण फ़ोटो के बारे में पूछा, जिन्हें इसलिए चुना गया था क्योंकि API मॉडल का स्कोर हमारे स्कोर से सबसे ज़्यादा दूर वालों में था, और उसी सेट की 1 दुरुस्त फ़ोटो के बारे में, हर एक के बारे में 3 बार, हर बार एक नई चैट में।
ऐप के स्कोर एक चैट से दूसरी चैट तक मुश्किल से हिले: दुरुस्त फ़ोटो के लिए 7.6, 7.6 और 7.8, खिलौना कैमरे के लिए 7.2, 7.2 और 7.1, बीटल के लिए 7.2, 7.4 और 7.2। 3 दौरों में से हर एक में उसने दुरुस्त फ़ोटो को दोनों खामी वाली फ़ोटो से ऊपर रखा, 0.2 से 0.7 अंक के फ़ासले से। खिलौना कैमरे वाली फ़ोटो पर, जिसमें फ़ोकस आँख से चूक गया था, 3 में से किसी भी जवाब ने नरम आँख पर ध्यान नहीं दिया: 2 ने फ़ोकस को अच्छा कहा (“फ़ोकस काफ़ी हद तक शार्प है”, अंग्रेज़ी से अनुवाद), तीसरे ने बालों, हाथों और खिलौना कैमरे की डिटेल की तारीफ़ की, जहाँ असल में फ़ोकस पड़ा था, और सभी 3 ने अव्यवस्था को दोष दिया। बीटल पर उसके शब्द उसके अंकों से ज़्यादा बदले: 2 जवाबों ने चेहरे पर नरम फ़ोकस का नाम लिया, और तीसरे ने एक अलग समस्या का नाम लिया, “बीटल का चेहरा बहुत गहरा है” (अंग्रेज़ी से अनुवाद), और शैडो उठाने का सुझाव दिया; स्कोर दोनों ही सूरतों में 7.2 और 7.4 के बीच रहा।
चूँकि वे 2 उदाहरण बड़ी चूकों के लिए चुने गए थे, हमने 2 ऐसी फ़ोटो जोड़ीं जो वैसी नहीं थीं: हमारे अपने कैलिब्रेशन सेट से एक गधे का पोर्ट्रेट, एक आम खामी के साथ (सपाट, तेज़ रोशनी और लगभग उड़ा हुआ आसमान), और एक दूसरी दुरुस्त फ़ोटो, सूर्यास्त का एक पैनोरमा, हर एक पर 3 चैट। गधे वाली फ़ोटो पर ऐप ने 3 चैट में से हर एक में अलग मुख्य समस्या बताई: रोशनी, फिर ख़ाली जगह, फिर पीछे के पेड़ों के सामने गधे का सिर; हर एक इस फ़ोटो के बारे में एक जायज़ बात थी, और उनमें से 2 हमारे संस्थापक के अपने आकलन में भी हैं, पर हर बार एक अलग बात। उसी फ़ाइल पर 3 बार चलाए गए FinalFrame ने हर बार चेहरे पर भारी पड़ते चमकीले आसमान का नाम लिया, हर बार 7.0 दिया, और हर बार एडिटिंग की वही योजना दी। पैनोरमा पर ऐप के 3 जवाब और FinalFrame के 3 रन, सभी ने गहरे फ़ोरग्राउंड की ओर इशारा किया। इन 2 फ़ोटो पर ऐप के स्कोर FinalFrame के स्कोर से आधे अंक के भीतर रहे; खिलौना कैमरे और बीटल पर बड़े फ़ासले उन 2 फ़ोटो पर थे जिन्हें बड़ी चूकों के लिए चुना गया था।
API के ज़रिए GPT-6.1 Sol ने कम रीज़निंग प्रयास वाली सेटिंग पर पहली 3 फ़ोटो को 8.2, 7.8 और 7.3 दिए थे। ऐप वाला रन उससे सिर्फ़ Memory में नहीं, कई बातों में अलग है: एक अलग मॉडल (GPT-6, न कि GPT-6.1 Sol), एक अलग रीज़निंग प्रयास सेटिंग, और ऐप किसी चैट में जो कुछ भी जोड़ता है। यह एक ही खाता था, संस्थापक का, जिसमें Memory चालू था, इसलिए हो सकता है कि पिछली चैट ने बाद वाली चैट पर असर डाला हो। इसलिए यह दिखाता है कि ChatGPT को उसी तरह इस्तेमाल करने पर, जैसे आप करते, आपको क्या मिलता है, यह नहीं कि अकेला Memory किसी स्कोर को कितना हिलाता है। स्कोर हमने कैसे परखा पर हैं (अंग्रेज़ी में)।
फ़ोटो की समीक्षा पाने के तीन तरीक़े
हर पंक्ति के अपवाद हैं। चैटबॉट वाला कॉलम उन बातों का सार है जो फ़ोटोग्राफ़रों और एक शोध टीम ने नवंबर 2025 से अगस्त 2026 के बीच प्रकाशित कीं; ये किसी नियंत्रित टेस्ट के बजाय अलग-अलग अनुभव हैं, और चैटबॉट अक्सर बदलते रहते हैं। एक सादे मॉडल पर हमारे अपने टेस्ट, OpenAI के API के ज़रिए और ChatGPT ऐप में हाथ से, तालिका के ऊपर बताए गए हैं और इस कॉलम का हिस्सा नहीं हैं।
| चैटबॉट, जिससे यूँ ही पूछा गया | FinalFrame | इंसानी समीक्षक | |
|---|---|---|---|
| तकनीकी बुनियादी बातें | एक टेस्टर ने अपने ही तैयार फ़्रेम पर इसे अच्छा आँका; किसी जानी-पहचानी खामी वाली फ़ोटो पर नहीं परखा गया (TechRadar, दिसंबर 2025) | सितंबर 2026 में, एक पुराने वर्ज़न पर मापा गया: साफ़ तौर पर नरम फ़ोटो की 80 में से 75 रीडिंग में नरमी चिह्नित, शार्प फ़ोटो की 100 रीडिंग में 0 ग़लत चिह्न; आपकी मूल फ़ाइल से नहीं, आपकी फ़ोटो की एक सहेजी गई कॉपी से पढ़ा जाता है, और अहम डिटेल पर फ़ोकस की जाँच एक अलग चरण के रूप में चलती है | मज़बूत; कोई मेंटर पूरी फ़ाइल को 100% पर जाँच सकता है |
| इरादा और जान-बूझकर नियम तोड़ना | बताए बिना अंधा (Venture Photography, नवंबर 2025) | आपका लक्ष्य उस लेन के रूप में लेता है जिसे आप 6 में से चुनते हैं, और उसी के मुक़ाबले आँकता है; उसके आगे इरादा नहीं जान सकता, यह बात कहता है, और नामित समस्या को आपकी फ़ोटो से मेल न खाने वाली के रूप में चिह्नित करने देता है | यही उसका सबसे अच्छा काम है |
| वही फ़ोटो, दोबारा पढ़ी गई | जिन प्रकाशित लेखों पर यह कॉलम आधारित है, उनमें मापा नहीं गया; जवाब इस पर बदलता है कि आप कैसे पूछते हैं (TechRadar, दिसंबर 2025) | हर पूरे टेस्ट रन में मापा जाता है; अक्टूबर 2026, 3 बार पढ़ी गई 77 समीक्षाएँ: 3 रीडिंग में कभी 0.4 से ज़्यादा फ़र्क़ नहीं, 47 के लिए सभी 3 में एक ही FinalFrame स्कोर; 71 के लिए एक ही अक्षर Tier | थकान, मूड और प्रविष्टियों के क्रम से बदल सकता है, इसीलिए फ़ोटोग्राफ़ी सैलून एक पैनल बिठाते हैं |
| यह क्या तय करता है | 2026 के एक प्रीप्रिंट के परीक्षणों में लगभग हर पहलू पर टिप्पणी करता है; कोई तय फ़ैसला नहीं (arXiv:2606.29689) | तय सूची से एक समस्या; कारण के साथ रुकने का संकेत; “सार्थक है या नहीं” का हाँ/ना | जो उनके लिए सबसे ज़्यादा मायने रखता है; एक अच्छा समीक्षक बताएगा कि फ़्रेम कब पूरा हो गया, या कब वह और समय के लायक़ नहीं |
| रफ़्तार और उपलब्धता | कुछ सेकंड से कुछ मिनट, किसी भी समय | लगभग एक मिनट, किसी भी समय; ऊपर बताया गया मापना पहले चलता है | फ़ोरम पर कुछ घंटे; क्लब की शाम या मेंटर के लिए एक हफ़्ता या ज़्यादा |
FinalFrame वाले कॉलम को ऐसे मॉडल की तरह पढ़ें जिसके इर्द-गिर्द मापने की एक प्रक्रिया है। दाएँ कॉलम को वह कॉलम पढ़ें जिसके लिए आप तस्वीर तैयार कर रहे हैं।
इंसानी समीक्षक कहाँ अब भी आगे है
इरादा। इस पेज का हर स्रोत यहीं पहुँचता है। वर्कशॉप चलाने वाला स्कूल Venture Photography, नवंबर 2025 की एक पोस्ट में (बायलाइन: sengmah): “AI सिर्फ़ उसी का मूल्यांकन कर सकता है जो वह देखता है, इसका नहीं कि आपने अपना कलात्मक लक्ष्य हासिल किया या नहीं।” (Venture Photography, 24 नवंबर 2025) Amateur Photographer के Geoff Harris ने नवंबर 2025 में ChatGPT को Henri Cartier-Bresson का एक फ़्रेम दिया और सुधारों की एक सूची पाई, जिनमें से एक सुझाव, उन्होंने लिखा, “HCB को उनकी क़ब्र में करवटें बदलने पर मजबूर कर देता।” (Amateur Photographer, 17 नवंबर 2025) जो इंसानी समीक्षक आपको जानता है, या बस पूछ लेता है कि आप क्या चाहते थे, वह झुके हुए क्षितिज को विचार की तरह पढ़ता है। मॉडल उसे झुके हुए क्षितिज की तरह पढ़ता है; और अक्सर फ़ोटोग्राफ़ी सैलून का निर्णायक भी, जो तस्वीर को इस तरह देखता है कि उसे समझाने के लिए फ़ोटोग्राफ़र वहाँ मौजूद नहीं होता।
FinalFrame का स्कोरिंग पेज कहता है कि समीक्षा “आपका इरादा नहीं जान सकती”, और कि “झुका हुआ क्षितिज पूरा विचार हो सकता है”। हाँ, वह आपका लक्ष्य ज़रूर लेती है: आप एक लेन चुनते हैं (स्वच्छ & स्वाभाविक, मूड & स्टाइल, प्रिंट के लिए तैयार, प्रतियोगिता के लिए तैयार, सोशल या क्लाइंट डिलीवरी) और फ़ोटो को उसी के हिसाब से आँका जाता है। वही फ़ोटो, अलग लेन, अलग स्कोर, और यही तो पूरी बात है। लेबल किए गए सेट में जान-बूझकर स्टाइल वाली फ़ोटो रखी गई हैं (धूप के चश्मे या टोपी के किनारे के पीछे आँखें, जान-बूझकर दिया गया मोशन ब्लर), ताकि स्टाइल के किसी चुनाव को दोबारा शूट की वजह न पढ़ा जाए; ऊपर का 132 में 0 वाला आँकड़ा इन्हें भी शामिल करता है। समीक्षा फिर भी बता सकती है कि आपकी चुनी लेन में उस चुनाव की क्या क़ीमत है। पढ़ने का नियम स्कोरिंग पेज वाला ही है: जब कोई चिह्नित खामी जान-बूझकर लिया गया फ़ैसला हो, तो उसे कम महत्व दें। AI कहाँ ग़लत हो सकता है, इस पर ज़्यादा जानकारी FinalFrame स्कोर कैसे काम करता है पर है।
भावना और संदर्भ। इंसानी समीक्षक आपको बता सकता है कि तस्वीर ने उस पर असर किया या नहीं, और आपके बाक़ी काम के बगल में वह कैसी पढ़ी जाती है। FinalFrame के Tier अंतरराष्ट्रीय फ़ोटोग्राफ़ी सैलून के निर्णय (PSA और FIAP प्रदर्शनियाँ) के अनुसार कैलिब्रेट किए गए हैं, और ख़ुद को मापने के लिए यह एक उपयोगी मानक है; फिर भी यह एक मानक है, जूरी का कोई सदस्य नहीं। Harris का निष्कर्ष वही है जिसे ज़्यादातर फ़ोटोग्राफ़र पहचानेंगे: “कोई भी बड़ी फ़ोटोग्राफ़िक प्रतियोगिता, जिसकी कोई साख हो, कभी अपने निर्णायक पैनल को हटाकर उसकी जगह ChatGPT नहीं लाएगी।” (Amateur Photographer)
चयनशीलता की समस्या: 2026 के एक प्रीप्रिंट ने क्या पाया
हमें जो सबसे सीधा प्रकाशित सबूत मिला, वह Sajjad Ghiasvand और चार सह-लेखकों का जून 2026 का प्रीप्रिंट “Can MLLMs Critique Like Humans?” है, जिसने आठ ओपन-वेट मॉडल और GPT-5.5 को r/photocritique की 1,227 पोस्टों की रैंक की गई इंसानी समीक्षाओं के मुक़ाबले स्कोर किया। (arXiv:2606.29689, v2 31 अगस्त 2026) यहाँ दो निष्कर्ष मायने रखते हैं।
पहला, फ़्रंटियर मॉडलों ने जजों की पसंद जीत ली: मुख्य स्थिति में सभी 4 LLM जज “फ़्रंटियर मॉडलों की समीक्षाओं को इंसानी समीक्षाओं से ज़्यादा पसंद करते हैं”। लेकिन जब पूछा गया कि हर मॉडल की समीक्षा सार में इंसानी समीक्षा से कितनी मिलती-जुलती है, तो जजों और 2 इंसानी एनोटेटरों ने हर मॉडल को 5-अंकों के पैमाने पर 1.81 से 2.59 के बीच अंक दिए, “‘ज़्यादातर अलग’ के क़रीब”। (arXiv:2606.29689)
दूसरा, और याद रखने लायक़ यही है: “मॉडल ऐसे तरीक़ों से अलग पड़ते हैं जिन्हें स्कोर सामने नहीं लाते: जहाँ इंसान चयनशील होते हैं, वहाँ वे लगभग हर सौंदर्य पहलू को छू लेते हैं, और एक ही फ़ोटो की समीक्षाओं में ख़ुद को दोहराते हैं, तब भी जब उनसे इंसानी लंबाई में लिखने को कहा जाए।” हर पहलू को छूना हर समस्या को ढूँढना नहीं है: लेखकों ने यह भी पाया कि “छवि न दिखाने से” स्वचालित समानता स्कोर “मुश्किल से बदलते हैं”, और यह कि आम पैमाना “इंसानी समीक्षा की चयनशीलता और विशिष्टता के बजाय एक धाराप्रवाह, सब कुछ समेटने वाली समीक्षा शैली को पुरस्कृत करता है।” (arXiv:2606.29689) सीधे शब्दों में: अपने हाल पर छोड़ दिया जाए तो मॉडल लगभग हर चीज़ पर टिप्पणी कर देता है, और जब मॉडल ने फ़ोटो देखी ही नहीं, तब भी पेपर के स्वचालित स्कोर मुश्किल से हिले। अच्छा समीक्षक पहले देखता है, फिर उसमें से ज़्यादातर छोड़ देता है।
FinalFrame का डिज़ाइन उस निष्कर्ष के दोनों हिस्सों का जवाब देता है, हालाँकि हमने उस पर पेपर वाला टेस्ट नहीं चलाया है। ऊपर बताया गया मापना तकनीकी रीडिंग को पिक्सेल से बाँधता है। चयनशीलता वाला हिस्सा पेपर से पुराना एक शिक्षण-संबंधी चुनाव है: समीक्षा एक समस्या का नाम लेती है, जिसे इस हिसाब से चुना जाता है कि आपकी लेन में वह फ़्रेम का कितना नुक़सान करती है, और उसी से शुरुआत करती है, ताकि अगले एडिट का एक ही निशाना हो। क्या वह समस्या वही है जिसका नाम आप लेते, यह एक जायज़ सवाल है; उसके नीचे का “मेरी फ़ोटो से मेल नहीं खाता” कंट्रोल आपको उसे चिह्नित करने देता है, जब वह वैसी न हो।
स्थिरता: मुश्किल हिस्सा, और हमने क्या मापा
स्थिरता किसी भी समीक्षा का एक मुश्किल हिस्सा है, चाहे इंसानी हो या AI की। अमेरिका की एक बड़ी वाइन प्रतियोगिता में 4 साल चले एक अध्ययन में, जिन जजों को एक ही बैठक में एक ही वाइन 3 बार दी गई, उन्होंने अक्सर उसे अलग-अलग स्कोर दिए, कुछ ने तो कांस्य से स्वर्ण पदक तक (Hodgson, Journal of Wine Economics, 2008); फ़ोटोग्राफ़ी के निर्णायकों पर हमें ऐसा कोई अध्ययन नहीं मिला। मॉडल भी उसी फ़ोटो को अलग-अलग तरह से पढ़ सकता है, हमारा भी। हमें मिले किसी भी प्रकाशित स्रोत ने इसे न किसी चैटबॉट के लिए मापा, न किसी समीक्षा ऐप के लिए, इसलिए यह खंड हमारे बारे में है; यह एक ऐसा टेस्ट भी है जिसे आप जो भी इस्तेमाल करते हैं उस पर चला सकते हैं, हम पर भी: एक ही फ़ोटो 3 बार भेजें और तुलना करें। FinalFrame का स्कोरिंग पेज कहता है कि “उसी फ़ोटो को दोबारा पढ़ने पर परिणाम थोड़ा अलग आ सकता है”, और यह अब भी सच है। हमने यह मापा कि कितना अलग, और फिर उसे सीमित किया।
अक्टूबर 2026 के रन में, 73 फ़ोटो की 77 समीक्षाएँ, जिनमें से हर एक को सीमा पर खड़े मामलों से भरे एक सेट पर 3 बार पढ़ा गया, 3 रीडिंग में से किसी में भी 0.4 अंक से ज़्यादा नहीं हिलीं, और 77 में से 47 को सभी 3 रीडिंग में एक ही FinalFrame स्कोर मिला; अक्षर Tier सभी 3 में 77 में से 71 के लिए मेल खाया, “सार्थक है या नहीं” का फ़ैसला 73 के लिए, और रुकने का फ़ैसला 75 के लिए। हम यहाँ तक पहले मापकर पहुँचे: अगस्त 2026 में, 10 फ़ोटो पर जिनमें से हर एक को 5 बार पढ़ा गया, मॉडल को चलाने के तरीक़े में एक बदलाव ने किसी फ़ोटो के सबसे ऊँचे और सबसे निचले संभावित स्कोर (एडिटिंग उसे कहाँ तक ले जा सकती है) के बीच के मीडियन फ़ासले को आधा कर दिया, 0.8 अंक से 0.4 पर। यह फ़ासला अब हर पूरे टेस्ट रन में बताया जाता है; ऊपर के अक्टूबर के आँकड़े ऐसे ही एक रन से आते हैं।
एक सीमा। नामित समस्या स्कोर जितनी मज़बूती से नहीं दोहराई जाती: सितंबर 2026 में एक पुराने वर्ज़न पर किए गए एक रन में, 71 फ़ोटो जिनमें से हर एक को 5 बार पढ़ा गया, उनमें से 59 के लिए वही समस्या 5 में से कम से कम 4 रीडिंग में सबसे ऊपर रही, और 40 के लिए सभी 5 में, इसलिए दोबारा पढ़ने पर कोई और समस्या सबसे ऊपर आ सकती है।
दोनों का इस्तेमाल कैसे करें
दोनों को प्रतिद्वंद्वी नहीं, अलग-अलग औज़ार मानें। AI रीडिंग का इस्तेमाल एडिटिंग के चक्र के भीतर करें: जिस एक चीज़ का यह नाम ले उसे ठीक करें, नया वर्ज़न अपलोड करें, देखें कि सुधार काम आया या नहीं, और जब रुकने का संकेत वजह बताए, तो रुक जाएँ। नए वर्ज़न पर समीक्षा बताती है कि पहले वाली समस्या हल हो गई, आंशिक रूप से हल हुई या अभी भी मौजूद है, और 0.1 या उससे कम के स्कोर बदलाव को प्रगति के रूप में नहीं बताया जाता, बल्कि “सामान्य बदलाव के दायरे में” के रूप में दिखाया जाता है।
लोगों का इस्तेमाल वहाँ करें जहाँ AI ने आपको बता दिया है कि वह अंधा है। तैयार वर्ज़न किसी क्लब की समीक्षा वाली शाम या r/photocritique जैसे किसी फ़ोरम पर ले जाएँ और एक सवाल पूछें: क्या यह तस्वीर वही कहती है जो मैं कहना चाहता था? आपको भावनात्मक रीडिंग मिलेगी, संदर्भ वाली रीडिंग मिलेगी, और कभी-कभी “इस फ़ोटो से मुझे कोई फ़र्क़ नहीं पड़ता” भी, जो कोई मॉडल आपसे नहीं कहेगा। जहाँ दोनों किसी तकनीकी खामी पर असहमत हों, वहाँ फ़ाइल फ़ैसला करती है, 100% पर और उस आकार पर जिस पर उसे दिखाया जाएगा; जहाँ वे इस पर असहमत हों कि फ़्रेम काम करता है या नहीं, वहाँ इंसान उस सवाल का जवाब दे रहा है जो मायने रखता है।
अगर आप लक्षण का नाम पहले से ले सकते हैं (सपाट फ़्रेम, सफ़ेद आसमान, नरम आँख), तो सीधे निदान सूची पर जाएँ, जो हर लक्षण को उसके पाठ तक पहुँचाती है। और अगर फ़्रेम कैप्चर-सीमित है, तो कोई एडिट उस सीमा को नहीं हटाता: सवाल यह बन जाता है कि वह जैसा है वैसा काम करता है या दोबारा शूट का हक़दार है। अगर आप यह तुलना नहीं कि समीक्षा कौन देता है, बल्कि वह पद्धति चाहते हैं जिस पर समीक्षा चलती है, तो फ़ोटो की समीक्षा कैसे करें पढ़ें।
AI फ़ोटो समीक्षा के बारे में आम सवाल
- क्या ChatGPT मेरी फ़ोटो की समीक्षा कर सकता है?
- करेगा, और विस्तृत प्रॉम्प्ट के साथ बेहतर करता है। TechRadar के Peter Fenech ने पाया कि जब तक उन्होंने अपना इरादा नहीं बताया, यह “फ़ीडबैक को शायद सामान्य ही रखेगा”, और फिर भी उन्हें शक रहा कि इसका बड़ा हिस्सा “रटे-रटाए जवाबों से उठाया गया” था। (TechRadar, दिसंबर 2025; Amateur Photographer, नवंबर 2025) OpenAI के मुताबिक़, Memory चालू होने पर ChatGPT आपकी पिछली चैट की बातें याद रख सकता है और अपने जवाबों को आपके हिसाब से ढालने में उनका इस्तेमाल कर सकता है (OpenAI Help Center, “Memory in ChatGPT”, अक्टूबर 2026 में पढ़ा गया)। अगर आप फ़ोटो पर ऐसा फ़ीडबैक चाहते हैं जो इस बात से प्रभावित न हो कि ChatGPT आपके बारे में क्या जानता है, तो एक अस्थायी चैट (Temporary Chat) शुरू करें और जहाँ विकल्प मिले, Unpersonalized चुनें। दोनों पत्रिकाओं के लेखों में से किसी ने भी इसे जानी-पहचानी खामी वाली फ़ोटो पर नहीं परखा, और किसी ने यह नहीं मापा कि वह एक ही फ़ोटो को दो बार एक ही तरह पढ़ता है या नहीं। FinalFrame जो जोड़ता है, वह प्रॉम्प्ट से बाहर है: मायने रखने वाली डिटेल पर एक अलग चरण के रूप में चलने वाली फ़ोकस जाँच, जानी-पहचानी खामियों वाली फ़ोटो पर परखी गई रीडिंग, और इस बात का मापा हुआ जवाब कि दोबारा पढ़ने पर परिणाम कितना हिलता है।
- क्या AI फ़ोटो समीक्षा सटीक होती है?
- यह इस पर निर्भर है कि क्या मापा गया, इसलिए आँकड़े माँगें। FinalFrame के आँकड़े, उसके अपने लेबल किए गए टेस्ट रन से: साफ़ तौर पर नरम फ़्रेम की 80 में से 75 रीडिंग में नरमी चिह्नित, और शार्प फ़्रेम की 100 में से 0 रीडिंग में ग़लत चिह्न (सितंबर 2026, एक पुराने वर्ज़न पर), और 73 फ़ोटो की 77 समीक्षाओं में, जिनमें से हर एक को 3 बार पढ़ा गया, 71 के लिए सभी 3 रीडिंग में एक ही Tier (अक्टूबर 2026)। इरादे के मामले में, वह आपकी चुनी लेन जानता है: वह मानक जिसके मुक़ाबले वह आँकता है। जो वह नहीं जान सकता, वह यह कि फ़्रेम के भीतर कोई चुनाव जान-बूझकर किया गया था, इसलिए हाई-की आसमान या जान-बूझकर दिया गया झुकाव खामी की तरह पढ़ा जा सकता है; उस नोट को कम महत्व दें। FinalFrame की सेवा की शर्तें आउटपुट को “एल्गोरिद्मिक राय” कहती हैं, विशेषज्ञ मूल्यांकन नहीं। इसे किसी नामित मानक के मुक़ाबले एक मापी गई दूसरी राय मानें।
- क्या AI फ़ीडबैक मेरी तस्वीरों को घिसा-पिटा बना देगा?
- बना सकता है, अगर आप किसी आम मॉडल की हर बात पर अमल करें: 2026 के प्रीप्रिंट ने पाया कि मॉडल “जहाँ इंसान चयनशील होते हैं, वहाँ लगभग हर सौंदर्य पहलू को छू लेते हैं”, और यह कि इंसानी समीक्षाओं से उनकी समानता “छवि-विशेष अवलोकन से ज़्यादा एक स्थिर समीक्षा शैली” को दर्शाती है (arXiv:2606.29689); एक साथ 10 नोट्स ठीक करना ही वह तरीक़ा है जिससे एक अलग पहचान वाला फ़्रेम बस एक सही फ़्रेम बनकर रह जाता है। FinalFrame हर समीक्षा में एक समस्या का नाम लेता है, जिसे इस हिसाब से चुना जाता है कि आपकी चुनी लेन में वह फ़्रेम का कितना नुक़सान करती है। उसे ठीक करें, नया वर्ज़न अपलोड करें, और देखें कि सुधार काम आया या नहीं। अगर जिस एक चीज़ का वह नाम लेता है, वह आपका जान-बूझकर किया गया चुनाव है, तो उसे बनाए रखें।
- क्या कोई मुफ़्त AI फ़ोटो समीक्षा है?
- हाँ। FinalFrame का होमपेज बिना खाते के एक मुफ़्त डेमो समीक्षा चलाता है (Tier, स्कोर, नामित बाधा और नतीजा; एडिटर के पूरे बदलावों के लिए एक मुफ़्त खाता चाहिए), और एक मुफ़्त खाते को हर महीने 3 समीक्षाएँ मिलती हैं, हर एक 1 क्रेडिट की, साथ ही 2 बोनस क्रेडिट तक, जो एडिट किया हुआ वर्ज़न अपलोड करने पर एक बार कमाए जाते हैं।
किसी ऐसे फ़्रेम की मापी गई समीक्षा देखें जिसे आप अच्छी तरह जानते हैं
ऐसी फ़ोटो अपलोड करें जिसके बारे में आपकी पहले से एक राय है। FinalFrame उसका फ़ोकस पढ़ता है और यह कि उसमें कैप्चर की कोई सीमा है या नहीं, उस एक समस्या का नाम लेता है जो उसका सबसे ज़्यादा नुक़सान करती है, और बताता है कि और एडिटिंग सार्थक है या नहीं, और जब वह रुकने को कहता है, तो वजह भी। उस एक सुधार के लिए स्लाइडर मान एक मुफ़्त खाते के साथ मिलते हैं। इसकी तुलना उससे करें जो आप कहते; दोनों दिशाओं के फ़र्क़ ही काम का हिस्सा हैं।
किसी फ़ोटो की समीक्षा कराएँChatGPT और OpenAI, OpenAI के ट्रेडमार्क हैं। FinalFrame, OpenAI से संबद्ध नहीं है और न ही OpenAI उसका समर्थन करता है।