Critica fotografica AI o critica umana: cosa colgono un chatbot, uno strumento di critica e una persona
Una critica fotografica AI vale quanto ciò che viene costruito e misurato intorno al modello. Un chatbot generico risponde alla domanda che hai scritto. FinalFrame prima misura la foto, le pone ogni volta le stesse domande fisse e mette alla prova le sue letture su foto i cui difetti sono già noti. Quello che ottieni è un secondo parere misurato rispetto a un metro che scegli tu: un problema nominato, i valori degli slider per risolverlo nel tuo programma di ritocco e un giudizio su se valga la pena ritoccare ancora, così il prossimo intervento ha una direzione. Un critico umano vince ancora sull'intenzione e sul capire se l'immagine arriva.
Se ti è capitato di incollare una foto in un chatbot e chiedere «che ne pensi?», forse riconosci la risposta descritta dai fotografi che hanno testato ChatGPT a fine 2025: un'apertura calorosa, un elenco di ciò che funziona e uno o due suggerimenti delicati. Una critica nel senso in cui la intende questa pagina pone ogni volta domande fisse alla foto, ne misura lo stato tecnico, nomina un problema e decide cosa fare dopo.
Se stai scegliendo dove mandare la prossima foto, questa pagina ti dà i dati misurati di FinalFrame, con le date, com'è la risposta di un chatbot alla stessa richiesta, e dove una persona fa ancora meglio.
Cos'è una critica fotografica AI, e in cosa differisce dal chiedere a un chatbot
Un chatbot generico risponde al prompt che riceve. Dagli una foto e una domanda vaga, e sceglie lui di cosa parlare. Peter Fenech di TechRadar, già redattore di Digital Photographer, ha fatto esattamente questo test nel dicembre 2025 e ha riassunto il primo giro in una riga: «con un prompt generico, è probabile che il feedback resti generico». Prompt più lunghi che dichiaravano la sua intenzione gli hanno dato risposte più mirate. (TechRadar, 31 dic. 2025)
Un prompt migliore ti dà una risposta costruita meglio; Fenech ha trovato esattamente questo. Ciò che FinalFrame aggiunge non sta nel prompt. Misura la foto prima che la critica venga scritta: legge i dati della fotocamera nel file e controlla la messa a fuoco sul dettaglio che conta, da vicino, come passaggio a sé. Poi ogni critica risponde alle stesse domande fisse, in un ordine fisso, così ciò che la lettura copre non dipende da quanto bene hai chiesto. FinalFrame funziona su un modello OpenAI, come dicono i suoi Termini di servizio. Il modello è una parte del risultato. La misurazione prima che scriva, e la verifica di ciò che scrive su foto i cui difetti sono già noti, sono il resto; la prossima sezione dà i numeri.
Tre domande contano di più qui. L'inquadratura è nitida dove conta, e il problema richiede un nuovo scatto o si risolve alla scrivania: le 2 letture che mettiamo alla prova più duramente. Quale singolo problema costa di più all'inquadratura, nominato da un elenco fisso e scelto in base a quanto costa all'inquadratura nel contesto che scegli: il metro con cui chiedi di essere misurato (Sobrio & naturale, Atmosfera & stile, Pronto stampa, Da competizione, Social o Lavoro per clienti). E conviene continuare a ritoccare: un indicatore di stop con la sua motivazione, più un giudizio «Vale la pena» che è un sì o un no. Insieme alla risposta arriva cosa muovere: i valori degli slider per quel problema, nel programma di ritocco che hai impostato nelle tue preferenze (Lightroom, Capture One, Photoshop e altri); carica la versione ritoccata e la critica successiva ti dice se quel problema è risolto, parzialmente risolto o ancora presente. Queste domande puoi scriverle anche a un chatbot; quello che non puoi scrivere è il controllo della messa a fuoco dietro la prima, i test su foto con difetti noti di cui parla la prossima sezione, o una misura di cosa ha cambiato il tuo ritocco: ogni nuova versione riceve un punteggio a sé, poi viene misurata rispetto alla precedente, e se ricarichi lo stesso file viene segnalato come la stessa immagine.
Dove la critica AI è forte, e come lo sappiamo
Partiamo dalla lettura tecnica. Il giudizio finale di Fenech era che «l'AI è molto brava nelle analisi tecniche», ma ha testato le sue fotografie finite, e nessuno degli articoli che abbiamo trovato ha provato una foto con un difetto noto. (TechRadar; Amateur Photographer, nov. 2025; Venture Photography, nov. 2025) Così abbiamo testato le nostre. Nel nostro ultimo test completo sulla messa a fuoco, svolto nel settembre 2026 su una versione precedente della critica, 16 foto chiaramente morbide sono state lette 5 volte ciascuna: la critica ha colto la morbidezza in 75 delle 80 letture, e in 100 letture di 20 foto nitide non ne ha mai definita morbida una sola. In una serie dell'ottobre 2026, su file che conservavano i dati della fotocamera, ha rilevato un vero limite di ripresa in tutte le 45 letture delle 15 foto che ne avevano uno, e ha chiesto per errore un nuovo scatto 0 volte in 132 letture di 44 foto in cui una scelta di stile o un difetto correggibile non deve essere letto come un limite simile. Sono foto ed etichette nostre, scelte apposta difficili; le tue foto non fanno parte del set.
Il secondo punto è lo stop. Alla prima critica FinalFrame controlla un insieme fisso di condizioni di stop, e può dirti di fermarti presto quando l'inquadratura porta un limite di ripresa, un difetto fissato nel momento dello scatto, come una messa a fuoco che ha mancato il soggetto, che nessun ritocco può togliere; allora la motivazione nomina il limite e l'inquadratura viene segnata come una che non vale l'ora di lavoro. Pochi amici ti diranno di smettere di ritoccare una foto che ti stai visibilmente divertendo a ritoccare, e il mentore che lo farebbe non è sempre a portata di mano; l'indicatore mette quel giudizio in ogni critica. La lezione su come leggere quell'indicatore è Smettere di ritoccare.
Il terzo è il punteggio stesso: mette una foto difettosa sotto una senza difetti? Nell'ottobre 2026 abbiamo dato un punteggio a 42 foto dei set di test etichettati su cui verifichiamo ogni nuova versione di FinalFrame: 16 con un difetto noto (15 di queste un problema di messa a fuoco) e 26 senza. In 412 delle 416 coppie formate da una foto senza difetti e una difettosa (99%), FinalFrame ha dato il punteggio più alto alla foto senza difetti; le foto senza difetti hanno avuto in media 7,0, quelle difettose 5,4.
Sulle stesse foto, GPT-6.1 Sol con effort «low», a cui tramite l'API di OpenAI (non l'app ChatGPT) venivano dati solo la foto e una breve richiesta di critica e di punteggio da 1 a 10, ha dato in media 7,7 alle foto senza difetti e 6,7 a quelle difettose (7,7 e 6,6 con effort «high»): circa 1 punto tra i gruppi, dove FinalFrame ne metteva 1,6. Il metodo, il prompt e i punteggi di ogni foto: come abbiamo fatto il test (in inglese).
Il modello da solo è un modello capace a cui si danno poche frasi di istruzioni; mettigli accanto FinalFrame e quello che vedi è ciò che viene costruito intorno a un modello, non quale modello sia migliore. Ciò che FinalFrame costruisce intorno al modello è una critica pensata per fare da riferimento: un punteggio che scende quando la foto ha un difetto, un problema nominato, un giudizio su se valga la pena ritoccare ancora o se l'inquadratura richieda un nuovo scatto, la modifica che sposterebbe di più il punteggio, e i valori degli slider per il prossimo ritocco nel contesto che hai scelto. Le due foto qui sotto mostrano dove una risposta del modello da solo e il suo punteggio possono separarsi.
Due delle foto difettose: cosa ha scritto ciascuno, e che punteggio ha dato
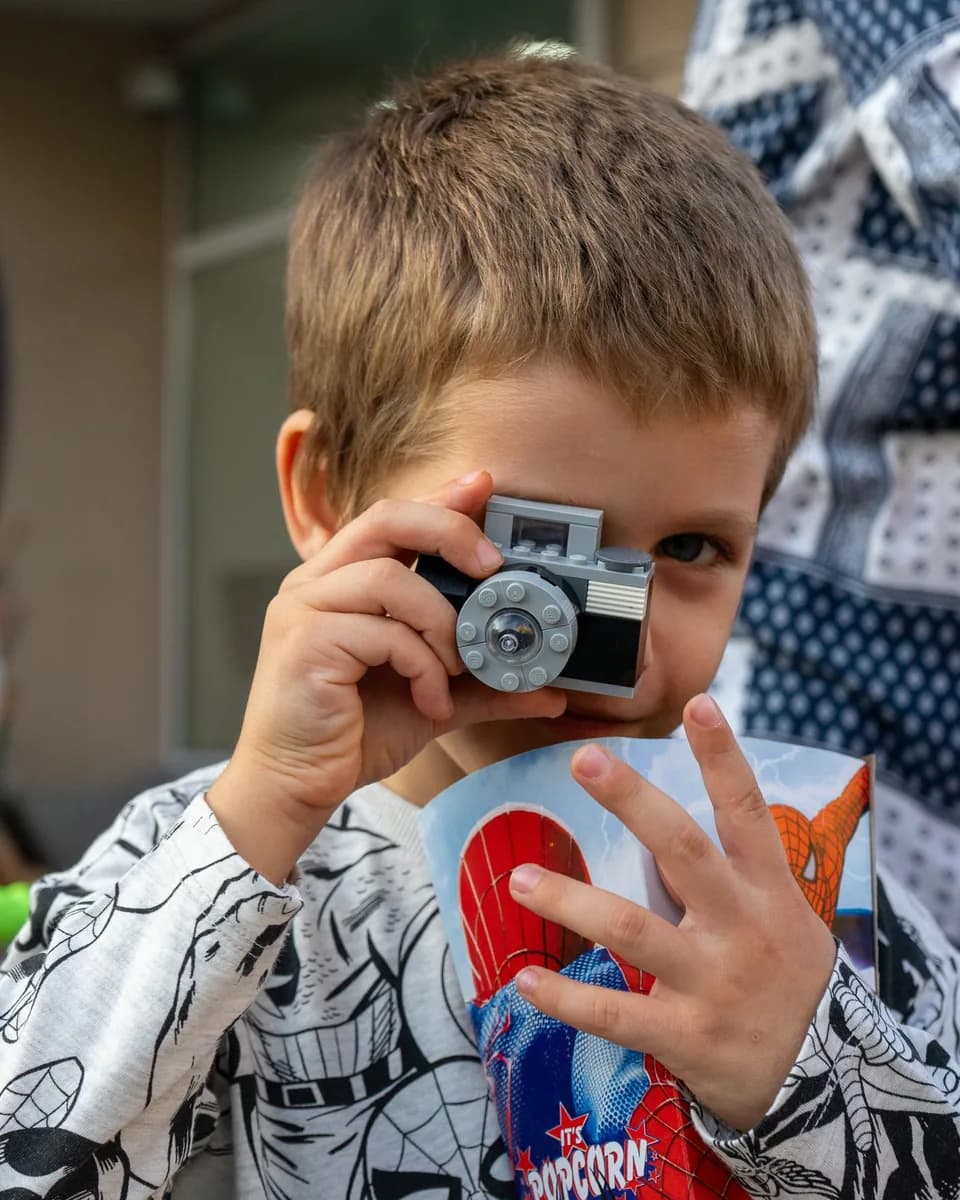
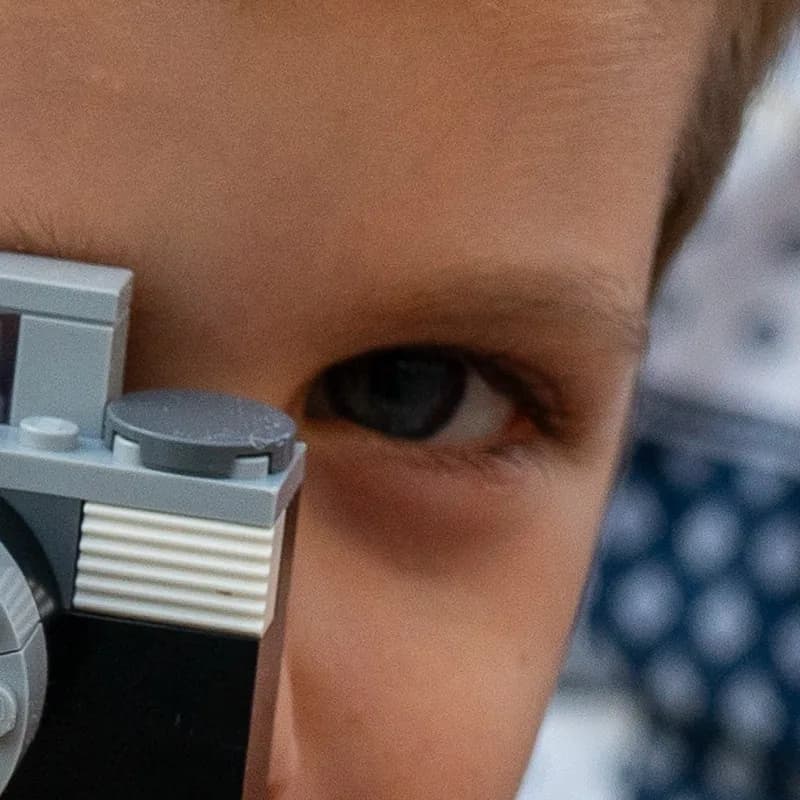
L'occhio, da vicino, dallo stesso file.
GPT-6.1 Sol da solo (API di OpenAI, effort «low»): 7,8/10. FinalFrame (contesto «Sobrio & naturale»): 5,5/10. Una lettura ciascuno, ottobre 2026.
GPT-6.1 Sol (API di OpenAI, effort «low»; tradotto dall'inglese)
7,8/10
GPT-6.1 Sol: «La messa a fuoco è buona dove conta, con dettagli piacevoli nei capelli, nell'occhio e nelle mani.» Il problema più grande che indica: «La cosa che più di tutte la frena è la figura che distrae sullo sfondo a destra.»
FinalFrame (tradotto dall'inglese)
5,5/10
FinalFrame: «l'unico occhio visibile deve reggere l'intero ritratto, e non è abbastanza incisivo per un'immagine pulita da portfolio.» E il suo verdetto: «Non dedicherei molto altro tempo a ritoccare questa versione; l'idea merita un nuovo scatto con l'occhio perfettamente a fuoco.»
Il modello da solo ha lodato la messa a fuoco e ha dato 7,8. FinalFrame ha nominato l'occhio morbido come limite, ha dato 5,5 e ha detto di rifare lo scatto invece di continuare a ritoccare: le sue parole e il suo numero dicono la stessa cosa.
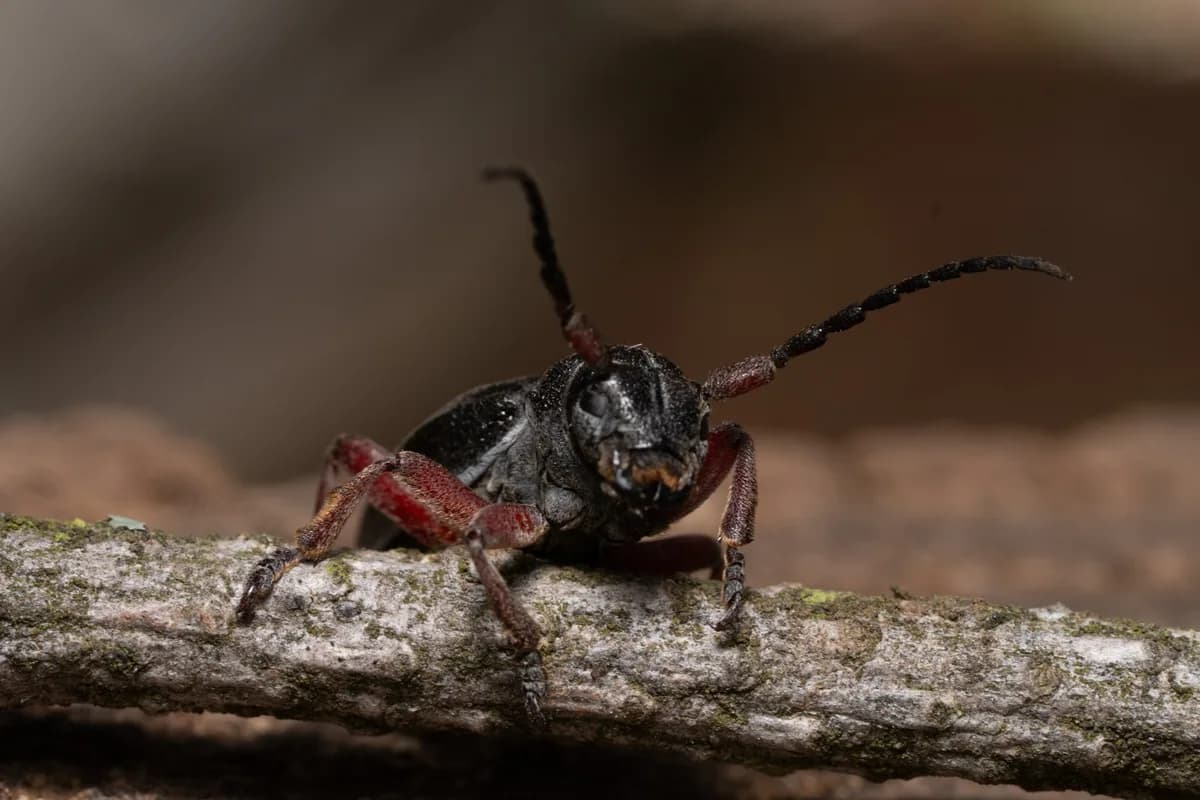
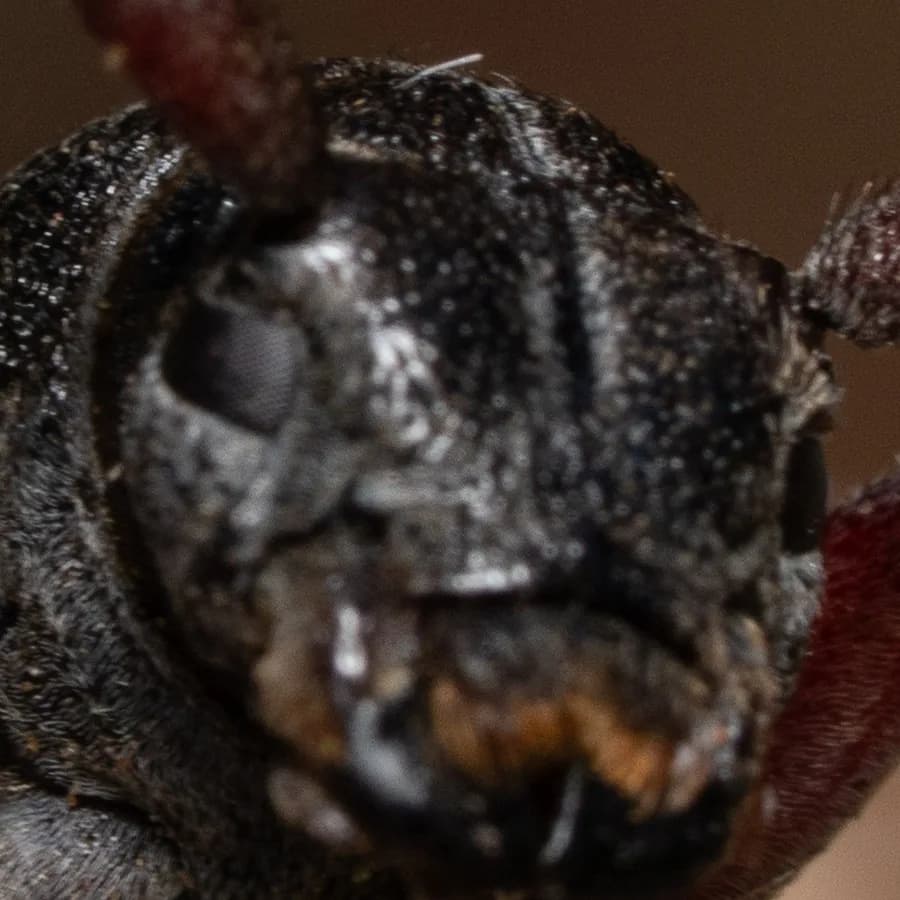
L'occhio, da vicino, dallo stesso file.
GPT-6.1 Sol da solo (API di OpenAI, effort «low»): 7,3/10. FinalFrame (contesto «Sobrio & naturale»): 5,6/10. Una lettura ciascuno, ottobre 2026.
GPT-6.1 Sol (API di OpenAI, effort «low»; tradotto dall'inglese)
7,3/10
GPT-6.1 Sol: «La cosa che più di tutte la frena è la mancanza di dettaglio incisivo intorno agli occhi e al viso. Sono i punti focali naturali, ma sembrano leggermente morbidi…»
FinalFrame (tradotto dall'inglese)
5,6/10
FinalFrame: «l'area viso/occhio non è resa con sufficiente precisione.» E il suo verdetto: «aumentare la nitidezza e il contrasto locale non la trasformerà in un pezzo da portfolio incisivo.»
Qui entrambi hanno nominato il viso morbido. Il modello da solo, che aveva definito buona la messa a fuoco della foto con la fotocamera giocattolo, ha dato a questa solo mezzo punto in meno: 7,3 contro 7,8. Il 5,6 di FinalFrame dice quello che dicono le sue parole, compreso che aumentare la nitidezza non lo risolverà.
Provalo su una foto che hai già giudicato tu: un problema nominato, un sì o un no su se valga la pena ritoccare ancora, e la motivazione quando dice stop. Poi confrontalo con quello che avresti detto tu.
Critica una fotoLa stessa richiesta nell'app ChatGPT
Il test qui sopra è passato dall'API di OpenAI. La maggior parte delle persone chiede invece nell'app ChatGPT, spesso con le chat precedenti e Memory alle spalle. Così abbiamo scritto a mano la stessa richiesta nell'app, su un account a pagamento con la funzione Memory attiva, usando il modello e l'impostazione con cui l'app si apriva (GPT-6, Medium). Abbiamo chiesto delle 2 foto d'esempio qui sopra, scelte perché il punteggio del modello via API era tra i più lontani dal nostro, e di 1 foto senza difetti dello stesso set, 3 volte ciascuna, in una nuova chat ogni volta.
I punteggi dell'app si sono mossi appena da una chat all'altra: 7,6, 7,6 e 7,8 per la foto senza difetti, 7,2, 7,2 e 7,1 per la fotocamera giocattolo, 7,2, 7,4 e 7,2 per il coleottero. In ciascuno dei 3 giri ha messo la foto senza difetti sopra entrambe le difettose, da 0,2 a 0,7 punti. Nessuna delle 3 risposte sulla fotocamera giocattolo, la foto in cui la messa a fuoco aveva mancato l'occhio, ha notato l'occhio morbido: 2 hanno definito buona la messa a fuoco («La messa a fuoco è ragionevolmente nitida», tradotto dall'inglese), la terza ha lodato il dettaglio nei capelli, nelle mani e nella fotocamera giocattolo, cioè proprio dove era caduta la messa a fuoco, e tutte e 3 hanno dato la colpa al disordine visivo. Sul coleottero le sue parole si sono mosse più dei suoi numeri: 2 risposte hanno indicato una messa a fuoco morbida sulla testa, e la terza ha indicato un problema diverso, «La testa del coleottero è troppo scura» (tradotto dall'inglese), e ha suggerito di alzare le ombre; il punteggio è rimasto comunque tra 7,2 e 7,4.
Poiché quei 2 esempi erano stati scelti per i grandi errori, abbiamo aggiunto 2 foto che non lo erano state: un ritratto di asino dal nostro set di calibrazione, con un difetto ordinario (luce piatta e forte e un cielo quasi bruciato), e una seconda foto senza difetti, un panorama al tramonto, 3 chat ciascuna. Sull'asino l'app ha indicato un problema principale diverso in ognuna delle 3 chat: la luce, poi lo spazio vuoto, poi la testa dell'asino contro gli alberi dietro; ognuno un rilievo giusto su questa foto, 2 dei quali coincidono con la valutazione del nostro fondatore, ma ogni volta uno diverso. FinalFrame, eseguito 3 volte sullo stesso file, ha indicato ogni volta il cielo luminoso che ruba la scena al muso, gli ha dato 7,0 ogni volta e ha proposto ogni volta lo stesso piano di ritocco. Sul panorama, le 3 risposte dell'app e le 3 esecuzioni di FinalFrame hanno indicato tutte il primo piano scuro. Su queste 2 foto i punteggi dell'app sono rimasti entro mezzo punto da quelli di FinalFrame; i grandi scarti sulla fotocamera giocattolo e sul coleottero riguardavano le 2 foto scelte per i grandi errori.
Tramite l'API, GPT-6.1 Sol aveva dato alle prime 3 foto 8,2, 7,8 e 7,3 con effort «low». La prova nell'app ne differisce per più della sola Memory: un modello diverso (GPT-6, non GPT-6.1 Sol), un'impostazione di effort diversa e tutto quello che l'app aggiunge a una chat. Era un solo account, quello del fondatore, con Memory attiva, quindi le chat precedenti possono aver influenzato quelle successive. Questo mostra quindi cosa ottieni da ChatGPT come lo useresti tu, non quanto Memory da sola sposti un punteggio. I punteggi sono in come abbiamo fatto il test (in inglese).
Tre modi per far criticare una foto
Ogni riga ha le sue eccezioni. La colonna del chatbot riassume ciò che fotografi e un gruppo di ricerca hanno pubblicato tra novembre 2025 e agosto 2026, esperienze singole e non un test controllato, e i chatbot cambiano spesso. I nostri test di un modello da solo, tramite l'API di OpenAI e a mano nell'app ChatGPT, sono riportati sopra la tabella e non fanno parte di questa colonna.
| Un chatbot, interpellato al momento | FinalFrame | Un critico umano | |
|---|---|---|---|
| Fondamentali tecnici | Giudicati bene da un tester sulle sue fotografie finite; non testati su una foto con un difetto noto (TechRadar, dic. 2025) | Misurati, set. 2026, su una versione precedente: morbidezza segnalata in 75 letture su 80 di foto chiaramente morbide, 0 falsi allarmi in 100 letture di foto nitide; letti da una copia archiviata della tua foto, non dal tuo file originale, con il controllo della messa a fuoco sul dettaglio chiave come passaggio a sé | Forte; un mentore può controllare l'intero file al 100% |
| Intenzione e regole infrante di proposito | Cieco se non glielo dici (Venture Photography, nov. 2025) | Prende il tuo obiettivo come il contesto che scegli tra 6 e giudica in base a quello; oltre, non può conoscere l'intenzione, lo dice e ti lascia segnalare che il problema nominato non corrisponde alla tua foto | Ciò che fa meglio |
| La stessa foto, riletta | Non misurato negli articoli pubblicati su cui si basa questa colonna; la risposta cambia in base a come chiedi (TechRadar, dic. 2025) | Misurato in ogni serie di test completa; ott. 2026, 77 critiche lette 3 volte: mai più di 0,4 punti di scarto nelle 3 letture, lo stesso Punteggio FinalFrame in tutte e 3 per 47; la stessa lettera di livello per 71 | Può variare con la stanchezza, l'umore e l'ordine delle opere, ed è per questo che i saloni schierano una giuria |
| Cosa decide | Commenta quasi ogni aspetto, nei test di un preprint del 2026; nessun verdetto fisso (arXiv:2606.29689) | Un problema da un elenco fisso; un indicatore di stop con la sua motivazione; un sì o un no su «Vale la pena» | Ciò che conta di più per lui; uno bravo ti dirà quando un'inquadratura è finita, o non vale altro tempo |
| Velocità e disponibilità | Da pochi secondi a qualche minuto, a qualsiasi ora | Circa un minuto, a qualsiasi ora, con le misurazioni descritte sopra fatte prima | Ore su un forum; una settimana o più per una serata al circolo o per un mentore |
Leggi la colonna di FinalFrame come un modello con un processo di misurazione intorno. Leggi la colonna di destra come quella per cui stai preparando la fotografia.
Dove un critico umano vince ancora
L'intenzione. Ogni fonte di questa pagina arriva qui. Venture Photography, una scuola di workshop, in un post del novembre 2025 (firma: sengmah): «l'AI può valutare solo ciò che vede visivamente, non se hai raggiunto il tuo obiettivo artistico». (Venture Photography, 24 nov. 2025) Geoff Harris di Amateur Photographer ha dato a ChatGPT un'immagine di Henri Cartier-Bresson nel novembre 2025 e ha ricevuto un elenco di miglioramenti, uno dei quali, ha scritto, «farebbe rivoltare HCB nella tomba». (Amateur Photographer, 17 nov. 2025) Un critico umano che ti conosce, o che semplicemente ti chiede cosa cercavi, legge l'orizzonte inclinato come l'idea. Un modello lo legge come un orizzonte inclinato; e spesso lo fa anche un giudice di salone, che vede l'immagine senza il suo autore lì a spiegarla.
La pagina di FinalFrame sul punteggio dice che la critica «non può conoscere la tua intenzione» e che «un orizzonte inclinato può essere l'idea intera». Quello che prende in considerazione è il tuo obiettivo: scegli un contesto (Sobrio & naturale, Atmosfera & stile, Pronto stampa, Da competizione, Social o Lavoro per clienti) e la foto viene giudicata rispetto a quello. Stessa foto, contesto diverso, punteggio diverso, ed è proprio questo il punto. Il set etichettato contiene foto con uno stile voluto (occhi dietro occhiali da sole o la tesa di un cappello, un mosso intenzionale) perché una scelta stilistica non venga letta come un motivo per rifare lo scatto; il dato di 0 su 132 citato sopra le include. La critica può comunque dire quanto costa quella scelta nel contesto che hai scelto. La regola di lettura è quella della pagina sul punteggio: dai meno peso a un difetto segnalato quando era una decisione deliberata. Di più su dove l'AI può sbagliare trovi in Come funziona il Punteggio FinalFrame.
L'emozione e il pubblico. Un critico umano può dirti se l'immagine gli è arrivata, e come si legge accanto al resto del tuo lavoro. I livelli di FinalFrame sono calibrati sul giudizio dei saloni internazionali (le mostre PSA e FIAP), ed è un metro utile con cui misurarsi; resta un metro, non un giurato. La conclusione di Harris è quella che la maggior parte dei fotografi riconoscerà: «nessun grande concorso fotografico degno di questo nome licenzierebbe mai la giuria per mettere al suo posto ChatGPT». (Amateur Photographer)
Il problema della selettività: cosa ha trovato un preprint del 2026
La prova pubblicata più diretta che abbiamo trovato è un preprint del giugno 2026 di Sajjad Ghiasvand e quattro coautori, «Can MLLMs Critique Like Humans?», che ha valutato otto modelli a pesi aperti più GPT-5.5 rispetto a critiche umane in classifica di 1.227 post di r/photocritique. (arXiv:2606.29689, v2 31 ago. 2026) Due risultati contano qui.
Primo, i modelli di frontiera hanno vinto la preferenza dei valutatori: nella condizione principale tutti e 4 i valutatori LLM «preferiscono le critiche dei modelli di frontiera a quelle umane». Ma alla domanda su quanto ogni critica del modello somigliasse nella sostanza a quella umana, i valutatori e 2 annotatori umani hanno dato a ogni modello tra 1,81 e 2,59 su una scala di 5 punti, «vicino a “per lo più diverso”». (arXiv:2606.29689)
Secondo, ed è questo da ricordare: «i modelli divergono in modi che i punteggi non fanno emergere: coprono quasi ogni aspetto estetico dove gli umani sono selettivi e si ripetono tra le critiche di una stessa foto, anche quando viene chiesto loro di scrivere a lunghezza umana». Coprire ogni aspetto non significa trovare ogni problema: gli autori hanno anche rilevato che «togliere l'immagine cambia appena» i punteggi automatici di somiglianza, e che la misura consueta «premia uno stile di critica fluente ed esaustivo anziché la selettività e la specificità della critica umana». (arXiv:2606.29689) In parole semplici: lasciato a se stesso, un modello commenta quasi tutto, e i punteggi automatici dell'articolo si sono mossi appena quando il modello non aveva mai visto la foto. Un buon critico prima guarda, poi ne lascia fuori la maggior parte.
Il progetto di FinalFrame risponde a entrambe le metà di questo risultato, anche se non lo abbiamo sottoposto al test dell'articolo. La misurazione descritta sopra lega le letture tecniche ai pixel. La metà sulla selettività è una scelta didattica più vecchia dell'articolo: la critica nomina un problema, scelto in base a quanto costa all'inquadratura nel tuo contesto, e parte da quello, così il prossimo ritocco ha un solo bersaglio. Se quel problema sia quello che avresti nominato tu è una domanda legittima; il comando «Non corrisponde alla mia foto», subito sotto, ti permette di segnalarlo quando non lo è.
Coerenza: la parte difficile, e cosa abbiamo misurato
La coerenza è una delle parti difficili di qualsiasi critica, umana o AI. In uno studio di 4 anni in un grande concorso enologico statunitense, i giudici a cui veniva servito lo stesso vino 3 volte nella stessa sessione spesso gli davano punteggi diversi, alcuni dal bronzo all'oro (Hodgson, Journal of Wine Economics, 2008); non abbiamo trovato uno studio simile sui giudici di fotografia. Anche un modello può leggere la stessa foto in modo diverso, il nostro compreso. Nessuna fonte pubblicata che abbiamo trovato lo ha misurato, né per un chatbot né per un'app di critica, quindi questa sezione riguarda il nostro; è anche un test che puoi fare su qualunque strumento usi, noi compresi: manda la stessa foto 3 volte e confronta. La pagina di FinalFrame sul punteggio dice che il punteggio «può variare leggermente in una seconda lettura della stessa foto», e resta vero. Quello che abbiamo fatto è misurare di quanto, e poi contenerlo.
Nella serie dell'ottobre 2026, 77 critiche di 73 fotografie, ciascuna letta 3 volte su un set pieno di casi limite, nessuna si è mossa di più di 0,4 punti nelle 3 letture e 47 delle 77 hanno avuto lo stesso Punteggio FinalFrame in tutte e 3; la lettera di livello coincideva in tutte e 3 per 71 delle 77, il giudizio «Vale la pena» per 73 e la decisione di stop per 75. Ci siamo arrivati misurando prima: nell'agosto 2026, su 10 foto lette 5 volte ciascuna, una modifica al modo in cui viene eseguito il modello ha dimezzato lo scarto mediano tra il punteggio potenziale più alto e quello più basso di una foto (fin dove potrebbe portarla il ritocco), da 0,8 a 0,4 punti. Lo scarto ora viene riportato in ogni serie di test completa; i dati di ottobre qui sopra vengono da una di quelle serie.
Un limite. Il problema nominato si ripete in modo meno stretto del punteggio: in una serie del settembre 2026 su una versione precedente, 71 foto lette 5 volte ciascuna, lo stesso problema veniva per primo in almeno 4 delle 5 letture per 59 di loro, e in tutte e 5 per 40, quindi una nuova lettura può partire da un problema diverso.
Come usarli entrambi
Tratta i due come strumenti diversi invece che come rivali. Usa la lettura AI dentro il ciclo di ritocco: correggi l'unica cosa che nomina, carica la nuova versione, guarda se la correzione è andata a segno, e fermati quando l'indicatore di stop ti dice perché. Sulla nuova versione la critica dice se il problema precedente è risolto, parzialmente risolto o ancora presente, e una variazione di punteggio di 0,1 o meno viene indicata come «nella norma» invece di essere presentata come un progresso.
Usa le persone dove l'AI ti ha detto di essere cieca. Porta la versione finita a una serata di critica di un circolo fotografico o su un forum come r/photocritique e fai una sola domanda: questa immagine dice ciò che intendevo? Avrai la lettura emotiva, la lettura del contesto, e a volte un «questa foto non mi dice niente», che nessun modello ti darà. Dove i due non sono d'accordo su un difetto tecnico, decide il file, al 100% e alle dimensioni a cui verrà mostrato; dove non sono d'accordo sul fatto che l'inquadratura funzioni, è l'umano a rispondere alla domanda che conta.
Se sai già nominare il sintomo (un'inquadratura piatta, un cielo bianco, un occhio morbido), vai dritto alla pagina delle diagnosi, che indirizza ciascuno alla sua lezione. E se l'inquadratura è limitata dalla ripresa, nessun ritocco toglie quel limite: la domanda diventa se funziona così com'è o merita un nuovo scatto. Se cerchi il metodo che una critica segue invece di un confronto su chi la fa, leggi come fare la critica di una foto.
Domande frequenti sulla critica fotografica AI
- ChatGPT può fare la critica delle mie foto?
- Sì, e con un prompt dettagliato fa meglio. Peter Fenech di TechRadar ha trovato «probabile che mantenga il feedback generico» a meno che non descrivesse la sua intenzione, e sospettava comunque che gran parte fosse «presa da risposte preconfezionate». (TechRadar, dic. 2025; Amateur Photographer, nov. 2025) OpenAI dice che, quando Memory è attiva, ChatGPT può ricordare dettagli delle tue chat passate e usarli per personalizzare le risposte (OpenAI Help Center, «Memory in ChatGPT», consultato a ottobre 2026). Se vuoi un feedback sulla foto che non sia influenzato da ciò che ChatGPT sa di te, avvia una chat temporanea e, dove ti viene data la scelta, seleziona «Unpersonalized» (non personalizzato). Nessuno dei due articoli delle riviste lo ha testato su una foto con un difetto noto, e nessuno dei due ha misurato se legge la stessa foto allo stesso modo due volte. Ciò che FinalFrame aggiunge sta fuori dal prompt: un controllo della messa a fuoco sul dettaglio che conta, eseguito come passaggio a sé, letture testate su foto con difetti noti, e una risposta misurata a quanto si sposta una lettura ripetuta.
- La critica fotografica AI è accurata?
- Dipende da cosa è stato misurato, quindi chiedi i numeri. Quelli di FinalFrame, dalle sue serie di test etichettate: morbidezza segnalata in 75 letture su 80 di inquadrature chiaramente morbide e per errore in 0 letture su 100 di quelle nitide (settembre 2026, su una versione precedente), e su 77 critiche di 73 fotografie, ciascuna letta 3 volte, lo stesso livello in tutte e 3 le letture per 71 (ottobre 2026). Sull'intenzione, conosce il contesto che scegli: il metro rispetto a cui giudica. Quello che non può sapere è che una scelta dentro l'inquadratura era deliberata, quindi un cielo deliberatamente in high-key o un'inclinazione voluta possono leggersi come un difetto; dai meno peso a quella nota. I suoi Termini di servizio definiscono il risultato «un'opinione algoritmica», non una valutazione esperta. Trattala come un secondo parere misurato rispetto a un metro dichiarato.
- Il feedback dell'AI renderà le mie foto banali?
- Può succedere, se applichi tutto quello che dice un modello generico: il preprint del 2026 ha rilevato che i modelli «coprono quasi ogni aspetto estetico dove gli umani sono selettivi» e che la loro somiglianza con le critiche umane riflette «uno stile di critica stabile più che un'osservazione specifica dell'immagine» (arXiv:2606.29689); correggere 10 note in una volta è il modo in cui un'inquadratura personale diventa un'inquadratura soltanto corretta. FinalFrame nomina un solo problema per critica, scelto in base a quanto costa all'inquadratura nel contesto che hai scelto. Correggilo, carica la nuova versione e guarda se la correzione è andata a segno. Se l'unica cosa che nomina è una scelta che hai fatto di proposito, tienila.
- Esiste una critica fotografica AI gratuita?
- Sì. La homepage di FinalFrame offre una critica dimostrativa gratuita senza account (il livello, i punteggi, il collo di bottiglia nominato e il verdetto; le regolazioni complete per il ritocco richiedono un account gratuito), e un account gratuito ottiene 3 critiche al mese, 1 credito ciascuna, più fino a 2 crediti bonus, guadagnati una sola volta quando carichi una versione ritoccata.
Guarda una critica misurata di un'inquadratura che conosci bene
Carica una fotografia su cui hai già un'opinione. FinalFrame legge la sua messa a fuoco e se ha un limite di ripresa, nomina l'unico problema che le costa di più e dice se vale la pena ritoccare ancora, e perché quando dice di fermarti. I valori degli slider per quell'unica correzione arrivano con un account gratuito. Confrontalo con quello che avresti detto tu; gli scarti in entrambe le direzioni sono la parte utile.
Critica una fotoChatGPT e OpenAI sono marchi di OpenAI. FinalFrame non è affiliato a OpenAI né approvato da OpenAI.