AI 사진 비평과 사람의 비평: 챗봇, 비평 도구, 사람이 각각 잡아내는 것
AI 사진 비평의 수준은 모델 주위에 무엇을 만들고 무엇을 측정하느냐에 달려 있습니다. 범용 챗봇은 당신이 입력한 질문에 답합니다. FinalFrame은 먼저 사진을 측정하고, 매번 같은 고정된 질문을 던지며, 결함이 이미 알려진 사진으로 자신의 읽기를 시험합니다. 당신이 얻는 것은 당신이 고른 기준에 비춰 측정된 세컨드 오피니언입니다. 지목된 문제 하나, 당신의 편집 프로그램에서 그 문제를 위한 슬라이더 값, 그리고 더 편집할 가치가 있는지에 대한 판정입니다. 그래서 다음 편집에 방향이 생깁니다. 의도와, 사진이 와닿는지에서는 여전히 사람 비평가가 앞섭니다.
사진을 챗봇에 붙여 넣고 “어떻게 생각해?”라고 물어본 적이 있다면, 2025년 말에 ChatGPT를 시험한 사진가들이 묘사한 답이 낯익을 수 있습니다. 따뜻한 첫마디, 잘된 점의 목록, 그리고 부드러운 제안 한두 가지. 이 페이지가 말하는 의미의 비평은 매번 같은 고정된 질문을 사진에 던지고, 사진의 기술적 상태를 측정하고, 문제 하나를 지목하고, 다음에 무엇을 할지 결정합니다.
다음 사진을 어디에 보낼지 고르고 있다면, 이 페이지에서 날짜가 적힌 FinalFrame의 측정치, 같은 요청에 챗봇의 답이 어떤 모습인지, 그리고 사람이 여전히 더 잘하는 곳을 볼 수 있습니다.
AI 사진 비평이란 무엇이며, 챗봇에게 묻는 것과 어떻게 다른가
범용 챗봇은 받은 프롬프트에 답합니다. 사진과 막연한 질문을 주면 무엇에 대해 말할지는 챗봇이 고릅니다. Digital Photographer의 전 편집자인 TechRadar의 Peter Fenech는 2025년 12월에 바로 이 테스트를 했고, 첫 라운드를 한 줄로 요약했습니다. “범용적인 프롬프트를 주면 피드백도 범용적으로 머물기 쉽다.” 그의 의도를 밝힌 더 긴 프롬프트에서는 더 구체적으로 짚는 답을 얻었습니다. (TechRadar, 2025년 12월 31일)
더 나은 프롬프트는 더 잘 짜인 답을 이끌어 냅니다. Fenech가 확인한 것도 바로 그것입니다. FinalFrame이 더하는 것은 프롬프트 안에 있지 않습니다. FinalFrame은 비평을 쓰기 전에 사진을 측정합니다. 파일에 담긴 카메라 데이터를 읽고, 중요한 디테일의 초점을 별도의 단계로 가까이 확대해 확인합니다. 그런 다음 모든 비평이 같은 고정된 질문에 정해진 순서로 답하므로, 읽기가 무엇을 다루는지가 당신이 얼마나 잘 물었는지에 달려 있지 않습니다. FinalFrame은 이용약관에 적힌 대로 OpenAI 모델로 작동합니다. 모델은 결과의 일부일 뿐입니다. 나머지는 쓰기 전의 측정, 그리고 쓴 내용을 결함이 이미 알려진 사진으로 검증하는 일입니다. 그 수치는 다음 절에서 제시합니다.
여기서 가장 중요한 것은 세 가지 질문입니다. 첫째, 프레임이 중요한 곳에서 선명한가, 그리고 그 문제가 다시 찍어야 하는 문제인가 책상 앞에서 고칠 수 있는 문제인가. 우리가 가장 엄격하게 시험하는 2가지 읽기입니다. 둘째, 프레임에 가장 큰 손실을 주는 문제 하나는 무엇인가. 고정된 목록에서 지목되며, 당신이 고르는 레인, 즉 당신이 측정받고 싶은 기준(클린 & 내추럴, 무드 & 스타일, 프린트용, 대회용, 소셜, 클라이언트 납품)에서 그 문제가 프레임에 얼마나 손실을 주는지에 따라 선택됩니다. 셋째, 편집을 계속해야 하는가. 이유가 붙은 편집 멈춤 플래그, 그리고 예 또는 아니요로 답하는 계속할 가치 판정입니다. 답과 함께 무엇을 움직일지도 나옵니다. 그 문제 하나를 위한 슬라이더 값이, 환경설정에서 정한 편집 프로그램(Lightroom, Capture One, Photoshop 등) 기준으로 제시됩니다. 편집한 버전을 업로드하면 다음 비평이 그 문제가 해결되었는지, 부분적으로 해결되었는지, 여전히 남아 있는지 알려 줍니다. 이런 질문은 챗봇에도 입력할 수 있습니다. 입력할 수 없는 것은 첫째 질문을 뒷받침하는 초점 확인, 다음 절에서 보고하는 결함이 알려진 사진에서의 시험, 그리고 편집이 무엇을 바꿨는지에 대한 측정입니다. 새 버전은 각각 따로 채점된 다음 이전 버전과 비교해 측정되며, 같은 파일을 다시 업로드하면 동일한 이미지로 표시됩니다.
AI 비평이 강한 곳, 그리고 그 근거
먼저 기술적 읽기입니다. Fenech의 결론은 “AI는 기술적 분석에 아주 능하다”였지만, 그가 시험한 것은 자신이 완성한 프레임이었고, 우리가 찾은 글 가운데 결함이 알려진 사진으로 시험한 것은 하나도 없었습니다. (TechRadar; Amateur Photographer, 2025년 11월; Venture Photography, 2025년 11월) 그래서 우리는 우리 것을 시험했습니다. 가장 최근의 전체 초점 테스트는 2026년 9월에 이전 버전의 비평으로 진행했으며, 확실히 흐릿한 사진 16장을 각각 5번 읽혔습니다. 80번의 읽기 중 75번에서 흐릿함을 잡아냈고, 선명한 사진 20장을 100번 읽는 동안 한 번도 흐릿하다고 판정하지 않았습니다. 2026년 10월 테스트에서는 카메라 데이터가 남아 있는 파일로, 실제 촬영 한계가 있는 사진 15장의 45번 읽기 모두에서 그 한계를 감지했고, 스타일 선택이나 고칠 수 있는 결함을 촬영 한계로 읽어서는 안 되는 사진 44장의 132번 읽기에서 잘못된 재촬영 판정은 0번이었습니다. 이것은 우리가 직접 고른 사진과 라벨이며, 일부러 어려운 것으로 골랐습니다. 당신의 사진은 이 세트에 들어 있지 않습니다.
둘째는 멈춤입니다. 첫 비평에서 FinalFrame은 고정된 멈춤 조건들을 확인하며, 어떤 편집으로도 끌어올릴 수 없는 촬영 단계의 한계, 즉 피사체를 놓친 초점처럼 셔터를 누른 순간에 굳어진 결함이 프레임에 있으면 일찍 멈추라고 할 수 있습니다. 그러면 이유가 그 한계를 지목하고, 프레임은 한 시간을 들일 가치가 없다고 표시됩니다. 당신이 눈에 띄게 즐기며 편집하고 있는 사진을 두고 이제 그만 편집하라고 말해 줄 친구는 많지 않고, 그렇게 말해 줄 멘토가 늘 곁에 있는 것도 아닙니다. 이 플래그는 그 판단을 모든 비평에 넣어 둡니다. 그 플래그를 읽는 법은 편집 멈춤 레슨에서 다룹니다.
셋째는 점수 자체입니다. 결함이 있는 사진을 문제없는 사진보다 아래에 두는가? 2026년 10월, 우리는 FinalFrame의 새 버전마다 확인에 쓰는 라벨이 붙은 테스트 세트에서 사진 42장을 채점했습니다. 결함이 알려진 사진 16장(그중 15장은 초점 문제)과 결함이 없는 사진 26장입니다. 문제없는 사진과 결함 있는 사진을 짝지은 416쌍 중 412쌍(99%)에서 FinalFrame은 문제없는 사진에 더 높은 점수를 주었습니다. 평균은 문제없는 사진이 7.0, 결함 있는 사진이 5.4였습니다.
같은 사진에 대해, 추론 강도를 낮게 설정한 GPT-6.1 Sol에 OpenAI의 API를 통해(ChatGPT 앱이 아니라) 사진과, 비평과 1~10점 점수를 요청하는 짧은 요청만 주었더니, 평균은 문제없는 사진 7.7, 결함 있는 사진 6.7이었습니다(추론 강도를 높게 설정하면 7.7과 6.6). 두 그룹 사이의 차이는 약 1점으로, FinalFrame은 1.6점 차이를 두었습니다. 방법, 프롬프트, 모든 사진의 점수는 테스트 방법(영어)에 있습니다.
기본 모델은 몇 문장의 지시를 받은 유능한 모델입니다. 그 옆에 FinalFrame을 두면 보이는 것은 어느 모델이 더 나은지가 아니라, 모델 주위에 무엇이 만들어져 있는지입니다. FinalFrame이 모델 주위에 만드는 것은 기준 삼아 참고할 수 있는 비평입니다. 사진에 결함이 있으면 내려가는 점수, 지목된 문제 하나, 더 편집할 가치가 있는지 아니면 다시 찍어야 하는지에 대한 판정, 점수를 가장 크게 움직일 변화, 그리고 당신이 고른 레인에서 다음 편집을 위한 슬라이더 값입니다. 아래 두 사진은 기본 모델의 답과 그 점수가 어디서 어긋날 수 있는지 보여 줍니다.
결함 있는 사진 중 2장: 각각이 쓴 것과 매긴 점수
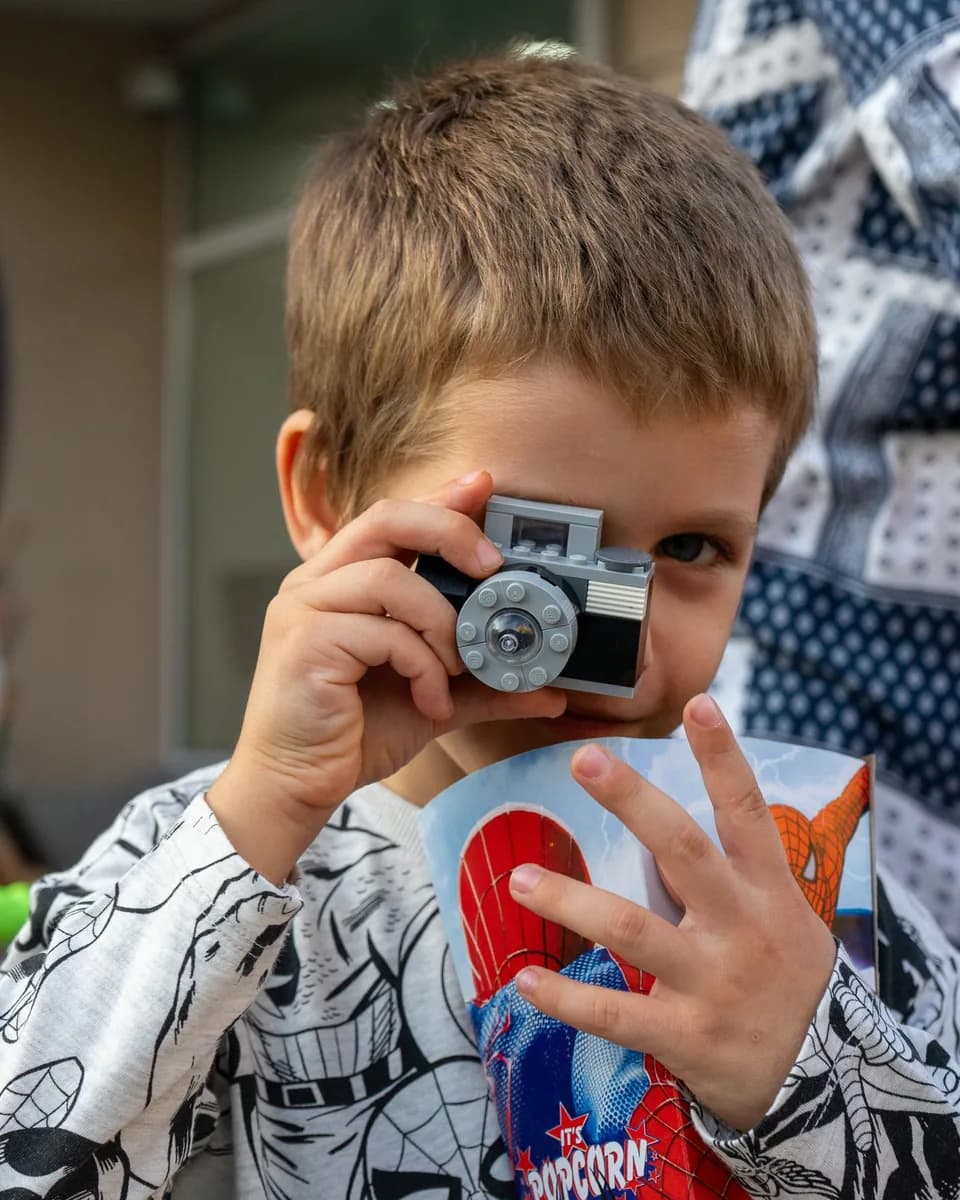
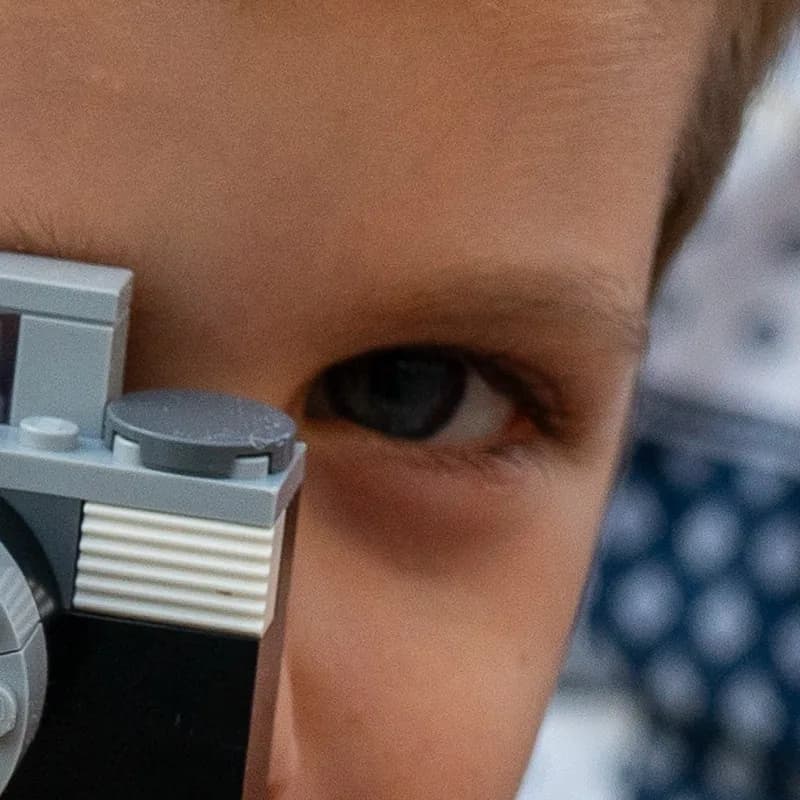
같은 파일에서 눈을 확대한 모습.
기본 GPT-6.1 Sol(OpenAI API, 낮은 추론 강도 설정): 7.8/10. FinalFrame(클린 & 내추럴 레인): 5.5/10. 각각 1번 읽기, 2026년 10월.
GPT-6.1 Sol(OpenAI API, 낮은 추론 강도 설정, 영어에서 번역됨)
7.8/10
GPT-6.1 Sol: “중요한 곳의 초점은 좋고, 머리카락, 눈, 손의 디테일이 보기 좋습니다.” 가장 큰 문제로는 “이 사진의 발목을 가장 크게 잡는 것은 오른쪽 배경에 있는, 시선을 빼앗는 인물입니다.”
FinalFrame(영어에서 번역됨)
5.5/10
FinalFrame: “보이는 한쪽 눈이 인물 사진 전체를 떠받쳐야 하는데, 깔끔한 포트폴리오 이미지로 쓰기에는 충분히 선명하지 않습니다.” 그리고 판정은 “저라면 이 버전의 편집에 시간을 더 많이 쓰지 않겠습니다. 눈에 초점을 정확히 맞춰 다시 찍을 가치가 있는 아이디어입니다.”
기본 모델은 초점을 칭찬하고 7.8점을 주었습니다. FinalFrame은 흐릿한 눈을 한계로 지목하고 5.5점을 주었으며, 편집을 계속하기보다 다시 찍으라고 했습니다. 말과 숫자가 같은 것을 말합니다.
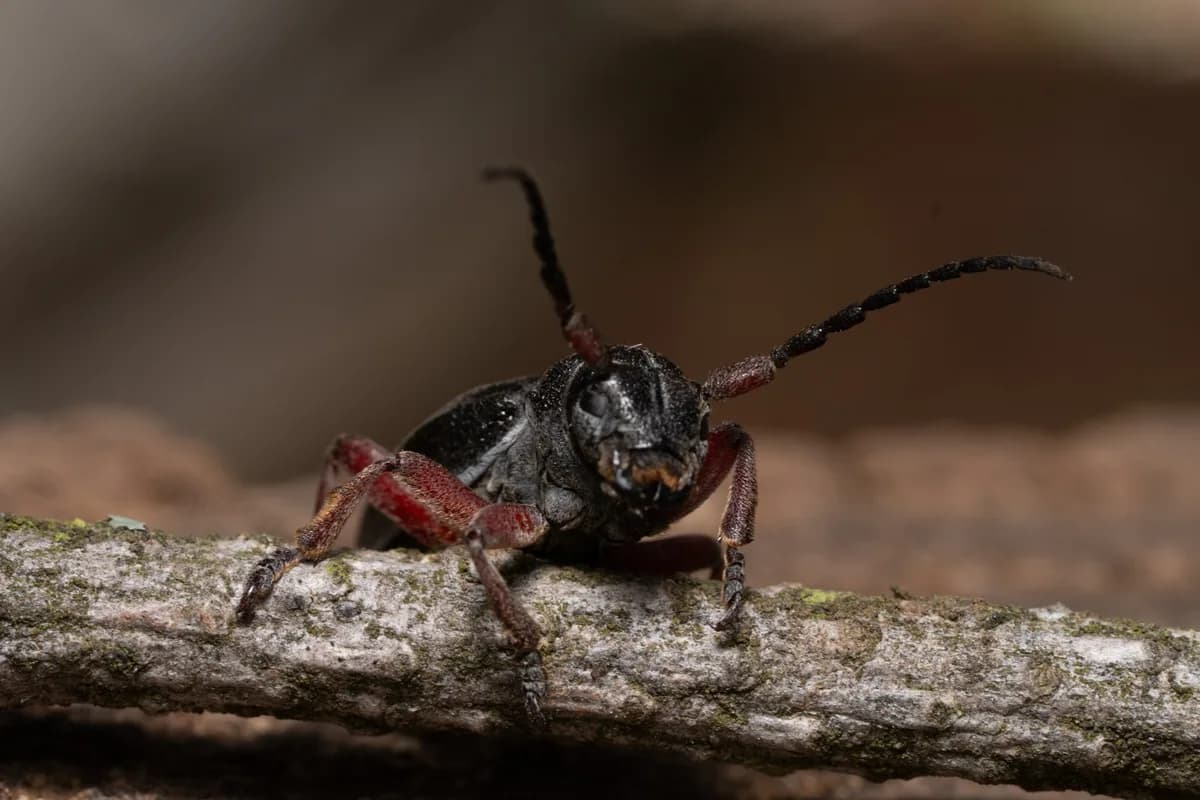
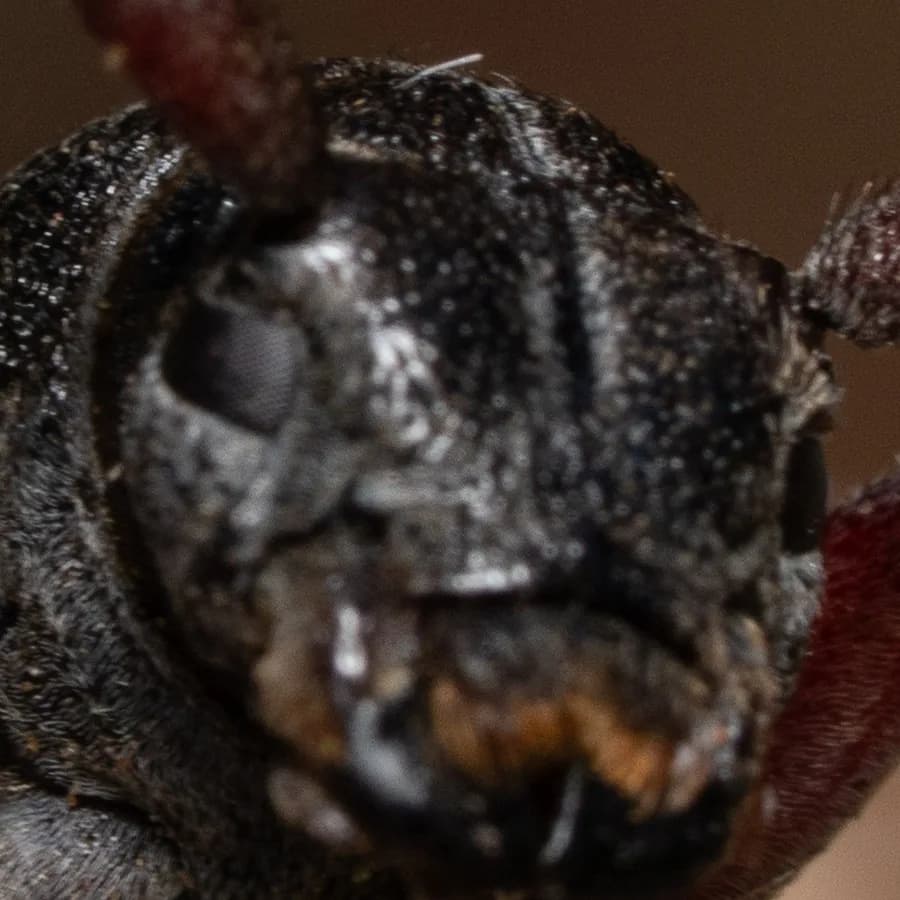
같은 파일에서 눈을 확대한 모습.
기본 GPT-6.1 Sol(OpenAI API, 낮은 추론 강도 설정): 7.3/10. FinalFrame(클린 & 내추럴 레인): 5.6/10. 각각 1번 읽기, 2026년 10월.
GPT-6.1 Sol(OpenAI API, 낮은 추론 강도 설정, 영어에서 번역됨)
7.3/10
GPT-6.1 Sol: “이 사진의 발목을 가장 크게 잡는 것은 눈과 얼굴 주변의 선명한 디테일이 부족하다는 점입니다. 그곳은 자연스럽게 시선이 모이는 곳이지만, 살짝 흐릿해 보입니다…”
FinalFrame(영어에서 번역됨)
5.6/10
FinalFrame: “얼굴/눈 부분이 충분한 정밀도로 해상되지 않습니다.” 그리고 판정은 “샤프닝과 로컬 대비로는 이 사진을 선명한 포트폴리오 작품으로 만들 수 없습니다.”
여기서는 둘 다 흐릿한 얼굴을 지목했습니다. 장난감 카메라 사진의 초점을 좋다고 했던 기본 모델은 이 사진에 겨우 0.5점 낮은 점수를 주었습니다. 7.8점 대비 7.3점입니다. FinalFrame의 5.6점은 그 말이 말하는 바를 그대로 말합니다. 그리고 그 말은 샤프닝으로는 고쳐지지 않는다는 것도 전합니다.
이미 스스로 판단해 본 사진으로 시험해 보세요. 지목된 문제 하나, 더 편집할 가치가 있는지에 대한 예 또는 아니요, 그리고 멈추라고 할 때의 이유가 나옵니다. 그런 다음 당신이라면 했을 말과 비교해 보세요.
사진 비평받기ChatGPT 앱에서 같은 요청
위의 테스트는 OpenAI의 API를 거쳤습니다. 하지만 대부분의 사람은 ChatGPT 앱에서 묻고, 흔히 이전 채팅과 메모리가 뒤에 깔린 상태입니다. 그래서 우리는 메모리를 켠 유료 계정에서, 앱을 열었을 때의 모델과 설정(GPT-6, Medium) 그대로 같은 요청을 앱에 직접 입력했습니다. 대상은 API 모델의 점수가 우리 점수와 가장 크게 벌어진 사진 중 하나라서 고른 위의 예시 사진 2장과, 같은 세트의 문제없는 사진 1장이었고, 각각 3번씩, 매번 새 채팅에서 물었습니다.
앱의 점수는 채팅마다 거의 움직이지 않았습니다. 문제없는 사진은 7.6, 7.6, 7.8, 장난감 카메라 사진은 7.2, 7.2, 7.1, 딱정벌레 사진은 7.2, 7.4, 7.2였습니다. 3번의 라운드마다 문제없는 사진을 결함 있는 두 사진보다 0.2~0.7점 높게 채점했습니다. 초점이 눈을 놓친 장난감 카메라 사진에 대한 3번의 답 중 어느 것도 흐릿한 눈을 알아채지 못했습니다. 2번은 초점이 좋다고 했고(“초점은 꽤 선명합니다”, 영어에서 번역됨), 세 번째는 머리카락, 손, 장난감 카메라의 디테일을 칭찬했는데, 그곳이 바로 초점이 맞은 곳입니다. 그리고 3번 모두 어수선함을 탓했습니다. 딱정벌레 사진에서는 숫자보다 말이 더 크게 움직였습니다. 2번의 답은 얼굴의 흐릿한 초점을 지목했고, 세 번째는 “딱정벌레의 얼굴이 너무 어둡습니다”(영어에서 번역됨)라는 다른 문제를 지목하며 섀도를 끌어올리라고 제안했습니다. 어느 쪽이든 점수는 7.2와 7.4 사이에 머물렀습니다.
그 2장은 크게 빗나간 사례로 골랐기 때문에, 그렇지 않은 사진 2장을 더했습니다. 우리 보정 세트에서 가져온, 흔한 결함(밋밋하고 밝은 빛과 거의 날아간 하늘)이 있는 당나귀 초상 사진, 그리고 문제없는 사진 한 장 더, 해 질 녘 파노라마입니다. 각각 3번의 채팅으로 물었습니다. 당나귀 사진에서 앱은 3번의 채팅마다 다른 주요 문제를 지목했습니다. 빛, 다음은 빈 공간, 다음은 뒤쪽 나무들에 겹친 당나귀의 머리입니다. 모두 이 사진에 대한 타당한 지적이고 그중 2개는 창업자 자신의 채점에도 들어 있지만, 매번 다른 것이었습니다. FinalFrame은 같은 파일로 3번 실행했을 때 매번 밝은 하늘이 얼굴보다 두드러진다는 점을 지목했고, 매번 7.0점을 주었으며, 매번 같은 편집 계획을 내놓았습니다. 파노라마에서는 앱의 3번의 답과 FinalFrame의 3번의 실행 모두 어두운 전경을 가리켰습니다. 이 2장에서 앱의 점수는 FinalFrame의 점수와 0.5점 이내였습니다. 장난감 카메라와 딱정벌레의 큰 차이는 크게 빗나간 사례로 고른 2장에서 나온 것이었습니다.
API를 통해서는 GPT-6.1 Sol이 추론 강도를 낮게 설정한 상태에서 처음 3장에 8.2, 7.8, 7.3점을 주었습니다. 앱 실행은 메모리 말고도 여러 면에서 그것과 다릅니다. 모델이 다르고(GPT-6.1 Sol이 아니라 GPT-6), 추론 강도 설정이 다르며, 앱이 채팅에 더하는 무언가가 있습니다. 창업자의 계정 하나로, 메모리를 켠 채 진행했으므로 앞선 채팅이 뒤의 채팅에 영향을 주었을 수 있습니다. 그러므로 이것이 보여 주는 것은 당신이 평소처럼 ChatGPT를 쓸 때 얻는 결과이지, 메모리만으로 점수가 얼마나 움직이는지가 아닙니다. 점수는 테스트 방법(영어)에 있습니다.
사진 비평을 받는 세 가지 방법
모든 행에는 예외가 있습니다. 챗봇 열은 2025년 11월부터 2026년 8월 사이에 사진가들과 한 연구팀이 발표한 내용을 요약한 것으로, 통제된 테스트가 아니라 개별 경험이며, 챗봇은 자주 바뀝니다. 기본 모델에 대한 우리 자체 테스트는 OpenAI의 API를 통한 것과 ChatGPT 앱에 직접 입력한 것 모두 표 앞에서 보고했으며, 이 열에는 포함하지 않았습니다.
| 즉석에서 묻는 챗봇 | FinalFrame | 사람 비평가 | |
|---|---|---|---|
| 기술적 기본기 | 테스터 한 명이 자신의 완성작으로 좋게 평가함. 결함이 알려진 사진으로는 시험하지 않음(TechRadar, 2025년 12월) | 2026년 9월, 이전 버전으로 측정: 확실히 흐릿한 사진의 80번 읽기 중 75번에서 흐릿함을 지적, 선명한 사진의 100번 읽기에서 잘못된 지적 0번. 원본 파일이 아니라 저장된 사진 사본에서 읽으며, 핵심 디테일의 초점 확인을 별도 단계로 실행 | 강함. 멘토는 파일 전체를 100%로 확인할 수 있음 |
| 의도와 의도적인 규칙 깨기 | 말해 주지 않으면 보지 못함(Venture Photography, 2025년 11월) | 6개 중 당신이 고른 레인을 목표로 받아 그에 비춰 판정. 그 너머의 의도는 알 수 없고, 그 사실을 밝히며, 지목된 문제를 사진과 맞지 않는다고 표시하게 해 줌 | 가장 잘하는 일 |
| 같은 사진을 다시 읽으면 | 이 열이 근거로 삼는 공개 글에서는 측정되지 않음. 묻는 방식에 따라 답이 달라짐(TechRadar, 2025년 12월) | 모든 전체 테스트에서 측정. 2026년 10월, 비평 77건을 3번씩 읽힌 결과: 3번의 읽기 사이 차이는 최대 0.4점, 47건은 3번 모두 같은 FinalFrame 점수, 71건은 같은 등급 | 피로, 기분, 출품작 순서에 따라 흔들릴 수 있음. 그래서 살롱은 심사위원단을 둠 |
| 무엇을 결정하는가 | 2026년 프리프린트의 테스트에서 거의 모든 측면에 의견을 냄. 고정된 판정은 없음(arXiv:2606.29689) | 고정된 목록에서 고른 문제 하나. 이유가 붙은 편집 멈춤 플래그. 계속할 가치 예/아니요 | 그 사람에게 가장 중요한 것. 좋은 비평가라면 프레임이 완성되었을 때, 또는 더 시간을 들일 가치가 없을 때 알려 줌 |
| 속도와 이용 가능성 | 몇 초에서 몇 분, 언제든 | 약 1분, 언제든. 앞서 말한 측정을 먼저 실행 | 포럼에서는 몇 시간. 동호회 합평회나 멘토라면 1주 이상 |
FinalFrame 열은 측정 과정에 둘러싸인 모델로 읽으세요. 오른쪽 열은 당신이 사진을 준비해서 보여 줄 상대로 읽으세요.
사람 비평가가 여전히 앞서는 곳
의도입니다. 이 페이지의 모든 출처가 여기에 이릅니다. 워크숍을 운영하는 사진 학교 Venture Photography는 2025년 11월 글(작성자: sengmah)에서 이렇게 씁니다. “AI는 눈에 보이는 것만 평가할 수 있을 뿐, 당신이 예술적 목표를 이뤘는지는 평가할 수 없다.” (Venture Photography, 2025년 11월 24일) Amateur Photographer의 Geoff Harris는 2025년 11월 앙리 카르티에브레송의 사진 한 장을 ChatGPT에 넣었다가 개선점 목록을 받았는데, 그중 하나는 그의 말대로라면 “HCB가 무덤에서 벌떡 일어날” 만한 것이었습니다. (Amateur Photographer, 2025년 11월 17일) 당신을 아는 사람 비평가, 혹은 그저 무엇을 노렸는지 물어봐 주는 비평가는 기울어진 수평선을 아이디어로 읽습니다. 모델은 그것을 기울어진 수평선으로 읽습니다. 살롱 심사위원도 흔히 그렇게 읽는데, 심사위원은 설명해 줄 작가가 없는 상태에서 사진을 보기 때문입니다.
FinalFrame의 채점 페이지는 비평이 “당신의 의도를 알 수 없습니다”라고, 그리고 “기울어진 수평선은 아이디어 그 자체일 수 있습니다”라고 말합니다. 대신 FinalFrame이 받는 것은 당신의 목표입니다. 당신이 레인(클린 & 내추럴, 무드 & 스타일, 프린트용, 대회용, 소셜, 클라이언트 납품)을 고르면 사진은 그에 비춰 판정됩니다. 같은 사진이라도 레인이 다르면 점수가 다르고, 바로 그것이 핵심입니다. 라벨이 붙은 세트에는 의도된 스타일의 사진(선글라스나 모자 챙에 가려진 눈, 의도적인 모션 블러)이 들어 있어, 스타일 선택이 재촬영의 이유로 읽히지 않게 합니다. 위의 132번 중 0번이라는 수치에도 이 사진들이 포함됩니다. 그래도 비평은 그 선택이 당신이 고른 레인에서 어떤 손실이 되는지 말할 수 있습니다. 읽는 규칙은 채점 페이지의 것입니다. 지적된 결함이 의도된 결정이었다면 그 비중을 낮추세요. AI가 어디서 틀릴 수 있는지는 FinalFrame 점수의 작동 방식에서 더 자세히 다룹니다.
감정과, 사진이 놓이는 자리. 사람 비평가는 사진이 자신에게 와닿았는지, 그리고 당신의 다른 작업 곁에서 어떻게 읽히는지 말해 줄 수 있습니다. FinalFrame의 등급은 국제 살롱 심사(PSA와 FIAP 전시)에 맞춰 보정되어 있고, 그것은 자신을 견주어 볼 유용한 기준입니다. 그래도 그것은 기준이지 심사위원이 아닙니다. Harris의 결론은 대부분의 사진가가 공감할 것입니다. “이름값을 하는 큰 사진 공모전이라면 심사위원단을 해고하고 대신 ChatGPT를 들이는 일은 절대 없을 것이다.” (Amateur Photographer)
선택성의 문제: 2026년 프리프린트가 발견한 것
우리가 찾은 공개 증거 가운데 가장 직접적인 것은 Sajjad Ghiasvand와 공저자 네 명이 2026년 6월에 낸 프리프린트 “Can MLLMs Critique Like Humans?”입니다. 이들은 오픈 웨이트 모델 여덟 개와 GPT-5.5를, r/photocritique 게시물 1,227개에 대해 순위가 매겨진 사람의 비평과 견주어 채점했습니다. (arXiv:2606.29689, v2 2026년 8월 31일) 여기서 중요한 발견은 두 가지입니다.
첫째, 프런티어 모델이 심사자들의 선호를 얻었습니다. 주 조건에서 4개의 LLM 심사자 모두 “사람의 비평보다 프런티어 모델의 비평을 선호”했습니다. 그런데 각 모델의 비평이 내용 면에서 사람의 비평과 얼마나 비슷한지 묻자, 심사자들과 사람 주석자 2명은 모든 모델에 5점 척도에서 1.81에서 2.59 사이의 점수를 매겼습니다. “‘대체로 다름’에 가까운” 수준입니다. (arXiv:2606.29689)
둘째, 그리고 기억해야 할 것은 이쪽입니다. “모델은 점수가 드러내지 않는 방식으로 어긋난다. 사람이 선별하는 곳에서 모델은 거의 모든 미적 측면을 다루고, 사람과 같은 길이로 쓰라고 지시받아도 한 사진에 대한 여러 비평에 걸쳐 같은 말을 반복한다.” 모든 측면을 다루는 것이 모든 문제를 찾는 것은 아닙니다. 저자들은 또한 이미지를 주지 않아도 자동 유사도 점수가 “거의 바뀌지 않는다”는 것, 그리고 흔히 쓰는 척도가 “사람 비평의 선별성과 구체성이 아니라 유창하고 포괄적인 비평 스타일에 보상한다”는 것을 발견했습니다. (arXiv:2606.29689) 쉽게 말해, 내버려 두면 모델은 거의 모든 것에 대해 말하고, 모델이 사진을 한 번도 보지 않았을 때도 논문의 자동 점수는 거의 움직이지 않았습니다. 좋은 비평가는 먼저 보고, 그다음 그 대부분을 빼 버립니다.
FinalFrame의 설계는 그 발견의 두 측면 모두에 답합니다. 다만 우리가 FinalFrame에 논문의 테스트를 돌려 본 것은 아닙니다. 앞에서 설명한 측정이 기술적 읽기를 픽셀에 묶어 둡니다. 선별성 측면은 논문보다 오래된 가르침의 선택입니다. 비평은 당신의 레인에서 프레임에 주는 손실에 따라 고른 문제 하나를 지목하고 그것을 맨 앞에 두므로, 다음 편집의 목표는 하나가 됩니다. 그 문제가 당신이라면 지목했을 문제와 같은지는 정당한 질문입니다. 그렇지 않을 때는 그 아래의 “내 사진과 맞지 않아요”로 표시할 수 있습니다.
일관성: 어려운 부분, 그리고 우리가 측정한 것
일관성은 사람이든 AI든 모든 비평에서 어려운 부분 중 하나입니다. 미국의 한 주요 와인 대회에서 4년 동안 진행된 연구에서, 한 번의 심사 자리에서 같은 와인을 3번 받은 심사위원들은 자주 다른 점수를 주었고, 일부는 동상에서 금상까지 오갔습니다(Hodgson, Journal of Wine Economics, 2008). 사진 심사위원에 대한 그런 연구는 찾지 못했습니다. 모델도 같은 사진을 다르게 읽을 수 있고, 우리 것도 예외가 아닙니다. 챗봇이든 어떤 비평 앱이든 그것을 측정한 공개 자료는 찾지 못했기 때문에, 이 절은 우리 것에 관한 이야기입니다. 이것은 우리를 포함해 당신이 쓰는 어떤 도구에든 해 볼 수 있는 테스트이기도 합니다. 같은 사진을 3번 보내고 비교해 보세요. FinalFrame의 채점 페이지는 “같은 사진을 다시 읽으면 결과가 조금 다르게 나올 수 있”다고 말하며, 그 말은 여전히 사실입니다. 우리가 한 일은 그 폭이 얼마나 되는지 측정하고, 그다음 그것을 억제한 것입니다.
2026년 10월 테스트에서, 경계 사례를 많이 담은 세트로 사진 73장에 대한 비평 77건을 각각 3번 읽혔더니, 3번의 읽기 사이에서 0.4점을 넘게 움직인 것은 하나도 없었고 77건 중 47건은 3번 모두 같은 FinalFrame 점수를 받았습니다. 등급은 77건 중 71건, 계속할 가치 판정은 73건, 멈춤 판정은 75건에서 3번 모두 일치했습니다. 여기에 이르기까지 먼저 측정했습니다. 2026년 8월, 사진 10장을 각각 5번 읽힌 테스트에서 모델을 실행하는 방식을 하나 바꾸자, 한 사진의 잠재 점수(편집으로 어디까지 끌어올릴 수 있는지) 최고치와 최저치 사이 폭의 중앙값이 0.8점에서 0.4점으로 절반이 되었습니다. 이 폭은 이제 모든 전체 테스트에서 보고되며, 위의 10월 수치도 그런 테스트 중 하나에서 나온 것입니다.
한계가 하나 있습니다. 지목된 문제는 점수만큼 촘촘하게 반복되지 않습니다. 2026년 9월에 이전 버전으로 사진 71장을 각각 5번 읽힌 테스트에서, 5번 중 적어도 4번 같은 문제가 맨 앞에 온 사진이 59장, 5번 모두 같은 문제가 맨 앞에 온 사진이 40장이었습니다. 그러므로 다시 읽으면 다른 문제가 맨 앞에 올 수 있습니다.
둘 다 쓰는 법
둘을 경쟁자가 아니라 서로 다른 도구로 다루세요. AI의 읽기는 편집 루프 안에서 쓰세요. 지목된 한 가지를 고치고, 새 버전을 업로드하고, 그 수정이 먹혔는지 확인하고, 편집 멈춤 플래그가 이유를 말하면 멈추세요. 새 버전에서는 비평이 이전 문제가 해결되었는지, 부분적으로 해결되었는지, 여전히 남아 있는지 말해 주며, 0.1점 이하의 점수 변화는 진전으로 보고되지 않고 오차 범위 내로 표시됩니다.
AI가 스스로 못 본다고 말한 곳에서는 사람을 쓰세요. 완성본을 사진 동호회 합평회나 r/photocritique 같은 포럼에 가져가서 한 가지만 물으세요. 이 사진은 내가 뜻한 바를 말하고 있는가? 감정적인 읽기, 맥락의 읽기, 그리고 때로는 “이 사진엔 관심이 안 가요”라는 답이 돌아올 텐데, 어떤 모델도 그런 답은 주지 않습니다. 둘이 기술적 결함을 두고 엇갈리면 파일이 결론을 내줍니다. 100%로, 그리고 실제로 보여 줄 크기로 확인하세요. 프레임이 통하는지를 두고 엇갈리면, 중요한 질문에 답하고 있는 쪽은 사람입니다.
증상을 이미 말할 수 있다면(밋밋한 프레임, 하얗게 날아간 하늘, 흐릿한 눈) 곧장 진단 페이지로 가세요. 각 증상을 해당 레슨으로 안내합니다. 그리고 프레임에 촬영으로 인한 한계가 있다면 어떤 편집도 그 한계를 끌어올리지 못합니다. 이제 질문은 그 상태 그대로 통하는지, 아니면 다시 찍을 만한지가 됩니다. 누가 비평하는지의 비교가 아니라 비평이 따르는 방법을 원한다면 사진을 비평하는 법을 읽으세요.
AI 사진 비평에 관해 자주 묻는 질문
- ChatGPT가 내 사진을 비평할 수 있을까?
- 할 수 있습니다. 그리고 자세한 프롬프트를 주면 더 잘합니다. TechRadar의 Peter Fenech는 자신의 의도를 설명하지 않는 한 “피드백도 범용적으로 머물기 쉽다”는 것을 알았고, 그럼에도 그 상당 부분이 “기성 답변에서 가져온” 것이라고 의심했습니다. (TechRadar, 2025년 12월; Amateur Photographer, 2025년 11월) OpenAI에 따르면 메모리가 켜져 있으면 ChatGPT는 과거 채팅의 세부 내용을 기억하고 그것을 답을 개인화하는 데 쓸 수 있습니다(OpenAI 도움말 센터, “Memory in ChatGPT”, 2026년 10월 열람). ChatGPT가 당신에 대해 아는 것에 좌우되지 않는 사진 피드백을 원한다면 임시 채팅을 시작하고, 선택지가 있으면 “개인화 없음(Unpersonalized)”을 고르세요. 두 잡지 기사 모두 결함이 알려진 사진으로 시험하지 않았고, 같은 사진을 두 번 같은 방식으로 읽는지도 측정하지 않았습니다. FinalFrame이 더하는 것은 프롬프트 밖에 있습니다. 중요한 디테일의 초점 확인을 별도 단계로 실행하는 것, 결함이 알려진 사진으로 시험한 읽기, 그리고 다시 읽을 때 얼마나 움직이는지에 대한 측정된 답입니다.
- AI 사진 비평은 정확할까?
- 무엇을 측정했느냐에 달려 있으니, 숫자를 요구하세요. FinalFrame의 숫자는 자체 라벨 테스트에서 나온 것입니다. 확실히 흐릿한 프레임의 80번 읽기 중 75번에서 흐릿함을 지적했고, 선명한 프레임의 100번 읽기에서 잘못 지적한 것은 0번이었습니다(2026년 9월, 이전 버전). 또한 사진 73장에 대한 비평 77건을 각각 3번 읽혔을 때, 71건이 3번 모두 같은 등급이었습니다(2026년 10월). 의도에 관해서는, 당신이 고른 레인, 즉 판정의 기준을 압니다. 알 수 없는 것은 프레임 안의 어떤 선택이 의도된 것이었다는 사실이므로, 하이키 하늘이나 일부러 기울인 구도가 결함으로 읽힐 수 있습니다. 그런 지적은 비중을 낮추세요. 이용약관은 그 출력을 전문가 평가가 아니라 “알고리즘에 의한 의견”이라고 부릅니다. 이름 붙은 기준에 비춰 측정된 세컨드 오피니언으로 다루세요.
- AI 피드백이 내 사진을 뻔하게 만들까?
- 범용 모델이 말하는 모든 것을 따른다면 그럴 수 있습니다. 2026년 프리프린트는 모델이 “사람이 선별하는 곳에서 거의 모든 미적 측면을 다룬다”는 것, 그리고 사람의 비평과의 유사성이 “이미지에 고유한 관찰보다 안정된 비평 스타일”을 반영한다는 것을 발견했습니다(arXiv:2606.29689). 지적 10개를 한꺼번에 고치는 것이야말로 개성 있는 프레임이 그저 올바르기만 한 프레임이 되는 길입니다. FinalFrame은 비평 한 번에 문제 하나를, 당신이 고른 레인에서 프레임에 주는 손실에 따라 골라 지목합니다. 그것을 고치고, 새 버전을 업로드하고, 수정이 먹혔는지 확인하세요. 지목된 한 가지가 당신이 일부러 내린 선택이라면 그대로 두세요.
- 무료 AI 사진 비평이 있을까?
- 있습니다. FinalFrame 홈페이지에서는 계정 없이 무료 데모 비평을 받을 수 있고(등급, 점수, 지목된 병목, 판정. 편집 프로그램 조정 전체를 보려면 무료 계정이 필요합니다), 무료 계정으로는 한 달에 비평 3회(회당 1크레딧)를 받을 수 있으며, 편집한 버전을 업로드할 때 한 번만 획득하는 보너스 크레딧도 최대 2개 받을 수 있습니다.
잘 아는 프레임에 대한 측정된 비평을 보세요
이미 나름의 의견이 있는 사진을 업로드하세요. FinalFrame은 사진의 초점과 촬영 한계가 있는지를 읽고, 가장 큰 손실을 주는 문제 하나를 지목하고, 더 편집할 가치가 있는지 말해 주며, 멈추라고 할 때는 그 이유를 말합니다. 그 수정 하나를 위한 슬라이더 값은 무료 계정과 함께 제공됩니다. 당신이라면 했을 말과 비교해 보세요. 양쪽 방향의 간극이 바로 쓸모 있는 부분입니다.
사진 비평받기ChatGPT와 OpenAI는 OpenAI의 상표입니다. FinalFrame은 OpenAI와 제휴 관계가 아니며 OpenAI의 보증을 받지 않습니다.