Crítica de foto com IA ou humana: o que um chatbot, uma ferramenta de crítica e um crítico humano percebem
Uma crítica de foto com IA é tão boa quanto o que é construído e medido em volta do modelo. Um chatbot genérico responde à pergunta que você digitou. O FinalFrame mede a foto primeiro, faz a ela as mesmas perguntas fixas toda vez e testa as leituras dele em fotos cujos defeitos já são conhecidos. O que você recebe é uma segunda opinião medida em relação a um padrão que você escolhe: um problema apontado, os valores de slider para ele no seu editor e um parecer sobre se vale a pena continuar editando, para que a próxima edição tenha uma direção. Um crítico humano ainda ganha na intenção e em saber se a imagem toca quem a vê.
Se você já colou uma foto num chatbot e perguntou “o que você acha?”, talvez reconheça a resposta que os fotógrafos que testaram o ChatGPT no fim de 2025 descrevem: uma abertura calorosa, uma lista do que funciona e uma ou duas sugestões gentis. Uma crítica, no sentido que esta página usa, faz perguntas fixas à foto toda vez, mede o estado técnico dela, aponta um problema e decide o que fazer em seguida.
Se você está escolhendo para onde mandar a próxima foto, esta página traz os números medidos do FinalFrame, com data, como fica a resposta de um chatbot ao mesmo pedido e onde uma pessoa ainda se sai melhor.
O que é uma crítica de foto com IA e como ela difere de perguntar a um chatbot
Um chatbot genérico responde ao prompt que recebe. Dê a ele uma foto e uma pergunta vaga, e ele escolhe sobre o que falar. Peter Fenech, da TechRadar, ex-editor da Digital Photographer, fez exatamente esse teste em dezembro de 2025 e resumiu a primeira rodada em uma linha: “com um prompt genérico, a tendência é que o retorno continue genérico.” Prompts mais longos, que nomeavam a intenção dele, renderam respostas mais direcionadas. (TechRadar, 31 dez. 2025)
Um prompt melhor rende uma resposta com um formato melhor; foi exatamente isso que Fenech encontrou. O que o FinalFrame acrescenta não está no prompt. Ele mede a foto antes de a crítica ser escrita: lê os dados da câmera no arquivo e confere o foco no detalhe que importa, de perto, como uma etapa própria. Depois, toda crítica responde às mesmas perguntas fixas, numa ordem fixa, então o que a leitura cobre não depende de quão bem você perguntou. O FinalFrame funciona com um modelo da OpenAI, como dizem os Termos dele. O modelo é uma parte do resultado. A medição antes de ele escrever, e o teste do que ele escreve em fotos cujos defeitos já são conhecidos, são o resto; a próxima seção traz os números.
Três perguntas importam mais aqui. Se o quadro está nítido onde importa, e se o problema pede uma nova foto ou se resolve na mesa de edição: as 2 leituras que mais testamos. Qual é o único problema que mais custa ao quadro, apontado a partir de uma lista fixa e escolhido pelo que custa ao quadro no modo que você escolher: o padrão em relação ao qual você pede para ser medido (Limpo & natural, Clima & estilo, Pronto para imprimir, Pronto para competir, Social ou Entrega ao cliente). E se você deve continuar editando: um sinal de parar com o motivo, além de um parecer de vale a pena que é um sim ou um não. Junto com a resposta vem o que mexer: valores de slider para esse único problema, no editor que você definiu nas suas preferências (Lightroom, Capture One, Photoshop e outros); envie a versão editada e a próxima crítica diz se esse problema foi resolvido, parcialmente resolvido ou continua lá. Você pode digitar essas perguntas num chatbot; o que você não pode digitar é a checagem de foco por trás da primeira, o teste em fotos com defeitos conhecidos que a próxima seção relata, ou uma medição do que a sua edição mudou: cada nova versão é pontuada por conta própria e depois medida em relação à anterior, e enviar de novo o mesmo arquivo é sinalizado como a mesma imagem.
Onde a crítica com IA é forte, e como sabemos
Primeiro, a leitura técnica. A conclusão final de Fenech foi que “a IA é muito boa em análises técnicas”, mas ele testou os próprios quadros finalizados, e nenhum dos relatos que encontramos testou uma foto com um defeito conhecido. (TechRadar; Amateur Photographer, nov. 2025; Venture Photography, nov. 2025) Então testamos os nossos. No nosso último teste completo de foco, feito em setembro de 2026 com uma versão anterior da crítica, 16 fotos claramente sem nitidez foram lidas 5 vezes cada: a crítica detectou a falta de nitidez em 75 das 80 leituras, e em 100 leituras de 20 fotos nítidas nunca disse que uma delas estava sem nitidez. Numa rodada de outubro de 2026, com arquivos que mantinham os dados da câmera, ela detectou um limite de captura real em todas as 45 leituras das 15 fotos que tinham um, e fez 0 indicações falsas de nova foto em 132 leituras de 44 fotos em que uma escolha de estilo ou um defeito corrigível não pode ser lido como um. São fotos e rótulos nossos, escolhidos por serem difíceis; as suas fotos não estão no conjunto.
O segundo é a parada. Numa primeira crítica, o FinalFrame confere um conjunto fixo de condições de parada, e pode mandar parar mais cedo quando o quadro carrega um limite de captura, um defeito fixado no momento do disparo, como um foco que não caiu no sujeito, que nenhuma edição consegue levantar; aí o motivo nomeia o limite e o quadro é marcado como não valendo a hora. Poucos amigos vão dizer para você parar de editar uma fotografia que você visivelmente está gostando, e o mentor que diria nem sempre está por perto; o sinal coloca essa decisão em toda crítica. A lição sobre como ler esse sinal é parar de editar.
O terceiro é a própria pontuação: ela coloca uma foto com defeito abaixo de uma sem defeito? Em outubro de 2026, pontuamos 42 fotos dos conjuntos de teste rotulados com que verificamos cada nova versão do FinalFrame: 16 com um defeito conhecido (15 delas com um problema de foco) e 26 sem. Em 412 dos 416 pareamentos de uma foto sem defeito com uma com defeito (99%), o FinalFrame deu a pontuação mais alta à foto sem defeito; as fotos sem defeito tiveram média de 7,0, e as com defeito, 5,4.
Nas mesmas fotos, o GPT-6.1 Sol com esforço baixo, recebendo só a foto e um pedido curto de crítica e de uma pontuação de 1 a 10 pela API da OpenAI (não o app do ChatGPT), teve média de 7,7 nas fotos sem defeito e 6,7 nas com defeito (7,7 e 6,6 com esforço alto): cerca de 1 ponto entre os grupos, onde o FinalFrame pôs 1,6. O método, o prompt e as pontuações de cada foto: como testamos (em inglês).
O modelo puro é um modelo capaz que recebeu algumas frases de instrução; coloque o FinalFrame ao lado dele e o que você vê é o que é construído em volta de um modelo, não qual modelo é melhor. O que ele constrói em volta do modelo é uma crítica feita para ser usada como referência: uma pontuação que cai quando a foto tem um defeito, um problema apontado, um parecer sobre se vale a pena continuar editando ou se o quadro precisa de uma nova foto, a mudança que mais moveria a pontuação e valores de slider para a próxima edição no modo que você escolheu. As duas fotos abaixo mostram onde a resposta do modelo puro e a pontuação dela podem se descolar.
Duas das fotos com defeito: o que cada um escreveu e que pontuação deu
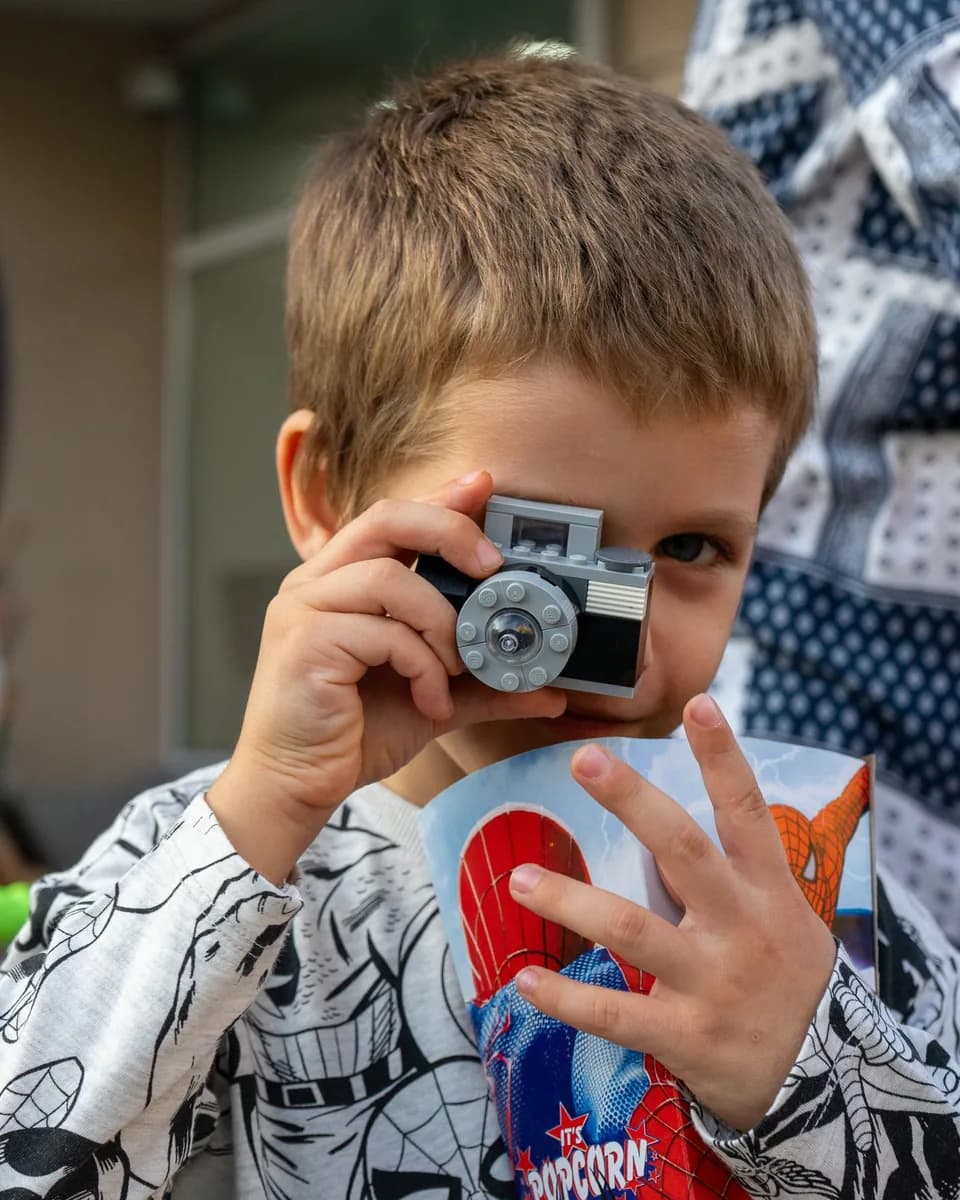
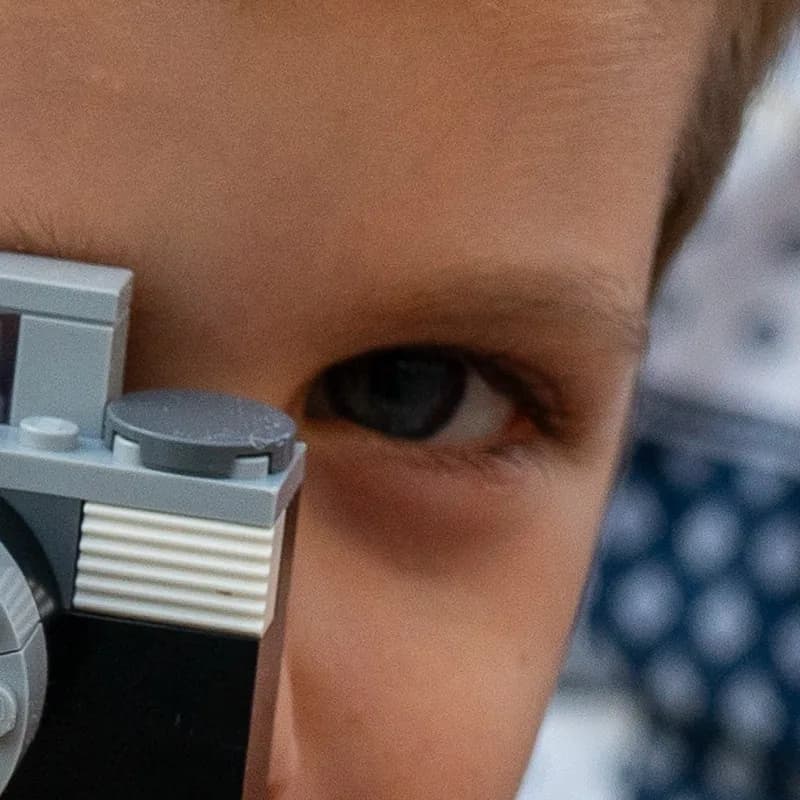
O olho, de perto, do mesmo arquivo.
GPT-6.1 Sol puro (API da OpenAI, esforço baixo): 7,8/10. FinalFrame (modo Limpo & natural): 5,5/10. Uma leitura de cada, outubro de 2026.
GPT-6.1 Sol (API da OpenAI, esforço baixo; traduzido do inglês)
7,8/10
GPT-6.1 Sol: “O foco está bom onde importa, com um detalhe agradável no cabelo, no olho e nas mãos.” O maior problema, segundo ele: “O que mais a está segurando é a figura no fundo, à direita, que distrai.”
FinalFrame (traduzido do inglês)
5,5/10
FinalFrame: “o único olho visível precisa sustentar o retrato inteiro, e não está nítido o bastante para uma imagem limpa de portfólio.” E o veredito: “Eu não gastaria muito mais tempo editando esta versão; a ideia vale uma nova foto com o foco cravado no olho.”
O modelo puro elogiou o foco e deu 7,8. O FinalFrame apontou o olho sem nitidez como o limite, deu 5,5 e disse para fazer uma nova foto em vez de continuar editando: as palavras e o número dele dizem a mesma coisa.
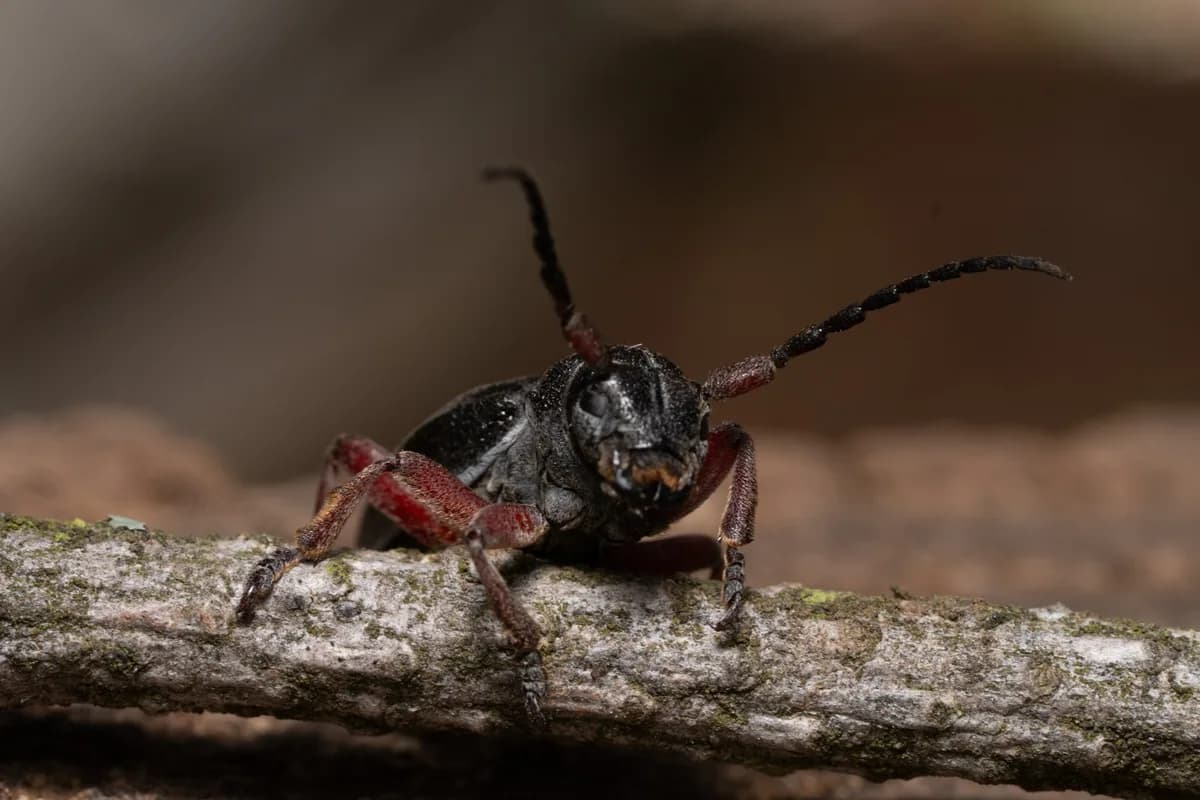
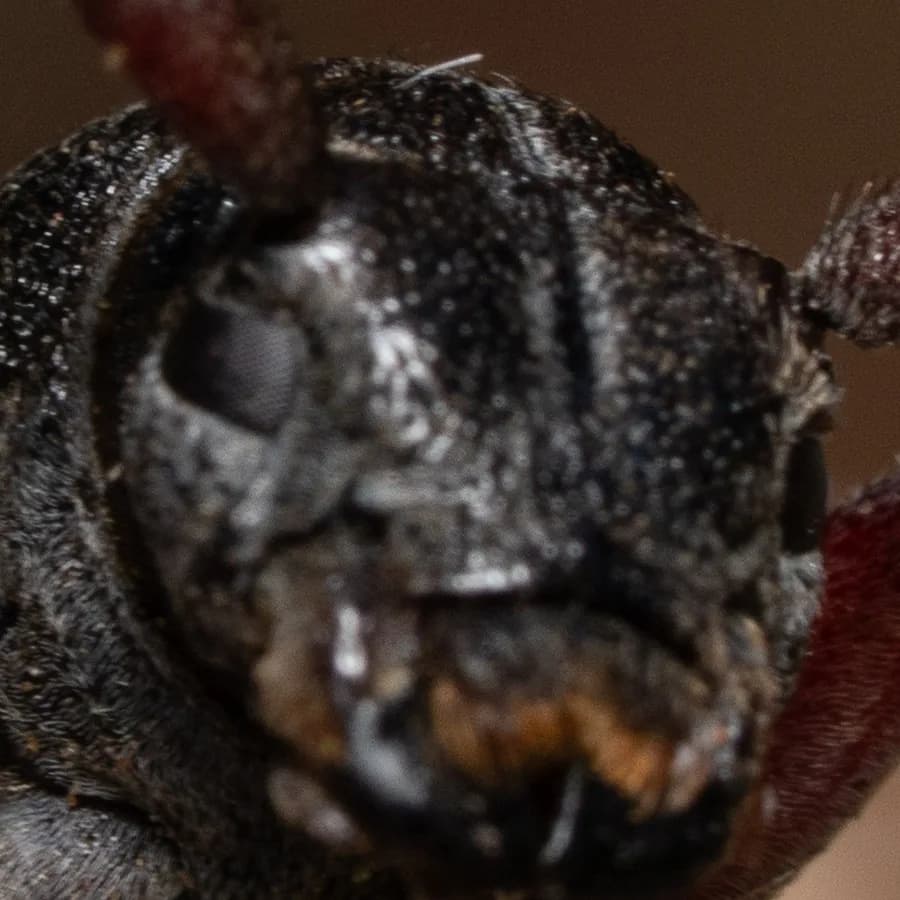
O olho, de perto, do mesmo arquivo.
GPT-6.1 Sol puro (API da OpenAI, esforço baixo): 7,3/10. FinalFrame (modo Limpo & natural): 5,6/10. Uma leitura de cada, outubro de 2026.
GPT-6.1 Sol (API da OpenAI, esforço baixo; traduzido do inglês)
7,3/10
GPT-6.1 Sol: “O que mais a está segurando é a falta de detalhe nítido em volta dos olhos e do rosto. Esses são os pontos focais naturais, mas parecem levemente desfocados…”
FinalFrame (traduzido do inglês)
5,6/10
FinalFrame: “a área do rosto/olho não é definida com precisão suficiente.” E o veredito: “aumento de nitidez e contraste local não vão transformar isto numa peça de portfólio nítida.”
Aqui os dois apontaram o rosto sem nitidez. O modelo puro, que tinha chamado de bom o foco da câmera de brinquedo, deu a esta apenas meio ponto a menos: 7,3 contra 7,8. O 5,6 do FinalFrame diz o que as palavras dele dizem, e que o aumento de nitidez não vai resolver.
Teste numa foto que você já avaliou por conta própria: um problema apontado, um sim ou não sobre se vale a pena continuar editando, e o motivo quando ele manda parar. Depois compare com o que você teria dito.
Criticar uma fotoO mesmo pedido no app do ChatGPT
O teste acima passou pela API da OpenAI. A maioria das pessoas pergunta no app do ChatGPT, muitas vezes com as conversas anteriores e a Memória por trás. Então digitamos o mesmo pedido à mão no app, numa conta paga com a Memória ativada, usando o modelo e a configuração com que o app abriu (GPT-6, Medium). Perguntamos sobre as 2 fotos de exemplo acima, escolhidas porque a pontuação do modelo da API estava entre as mais distantes da nossa, e sobre 1 foto sem defeito do mesmo conjunto, 3 vezes cada, numa conversa nova a cada vez.
As pontuações do app quase não se mexeram de uma conversa para outra: 7,6, 7,6 e 7,8 para a foto sem defeito; 7,2, 7,2 e 7,1 para a câmera de brinquedo; 7,2, 7,4 e 7,2 para o besouro. Em cada uma das 3 rodadas ele pôs a foto sem defeito acima das duas com defeito, por 0,2 a 0,7 ponto. Nenhuma das 3 respostas sobre a câmera de brinquedo, a foto cujo foco tinha errado o olho, percebeu o olho sem nitidez: 2 disseram que o foco estava bom (“O foco está razoavelmente nítido”, traduzido do inglês), a terceira elogiou o detalhe no cabelo, nas mãos e na câmera de brinquedo, que é onde o foco caiu, e as 3 culparam a poluição visual. No besouro, as palavras se mexeram mais que os números: 2 respostas apontaram falta de nitidez no rosto, e a terceira apontou um problema diferente, “O rosto do besouro está escuro demais” (traduzido do inglês), e sugeriu levantar as sombras; a pontuação ficou entre 7,2 e 7,4 de todo jeito.
Como esses 2 exemplos foram escolhidos por erros grandes, acrescentamos 2 fotos que não foram: um retrato de um burro do nosso próprio conjunto de calibração, com um defeito comum (luz chapada e forte e um céu quase estourado), e uma segunda foto sem defeito, uma panorâmica de pôr do sol, 3 conversas cada. No burro, o app apontou um problema principal diferente em cada uma das 3 conversas: a luz, depois o espaço vazio, depois a cabeça do burro contra as árvores atrás dele; cada um, uma observação justa sobre esta foto, 2 deles presentes na própria avaliação do nosso fundador, mas um diferente a cada vez. O FinalFrame, rodado 3 vezes no mesmo arquivo, apontou todas as vezes o céu claro chamando mais atenção que o rosto, deu 7,0 todas as vezes e deu o mesmo plano de edição todas as vezes. Na panorâmica, as 3 respostas do app e as 3 rodadas do FinalFrame apontaram o primeiro plano escuro. Nessas 2 fotos, as pontuações do app ficaram a menos de meio ponto das do FinalFrame; as grandes diferenças na câmera de brinquedo e no besouro foram nas 2 fotos escolhidas por erros grandes.
Pela API, o GPT-6.1 Sol tinha dado às 3 primeiras fotos 8,2, 7,8 e 7,3 com esforço baixo. A rodada no app difere disso em mais do que a Memória: outro modelo (GPT-6, não GPT-6.1 Sol), outra configuração de esforço e o que mais o app acrescenta a uma conversa. Foi uma única conta, a do fundador, com a Memória ativada, então as conversas anteriores podem ter influenciado as seguintes. Por isso, isto mostra o que você recebe do ChatGPT do jeito que você o usaria, não quanto a Memória sozinha move uma pontuação. As pontuações estão em como testamos (em inglês).
Três jeitos de ter uma foto criticada
Toda linha tem exceções. A coluna do chatbot resume o que fotógrafos e uma equipe de pesquisa publicaram entre novembro de 2025 e agosto de 2026, experiências individuais e não um teste controlado, e os chatbots mudam com frequência. Os nossos próprios testes de um modelo puro, pela API da OpenAI e à mão no app do ChatGPT, estão relatados antes da tabela e não fazem parte desta coluna.
| Um chatbot, consultado de improviso | FinalFrame | Um crítico humano | |
|---|---|---|---|
| Fundamentos técnicos | Bem avaliado por um testador nos próprios quadros finalizados; não testado numa foto com defeito conhecido (TechRadar, dez. 2025) | Medido, set. 2026, numa versão anterior: falta de nitidez apontada em 75 de 80 leituras de fotos claramente sem nitidez, 0 alertas falsos em 100 leituras de fotos nítidas; lido numa cópia armazenada da sua foto, não no seu arquivo original, com a checagem de foco feita no detalhe principal como uma etapa própria | Forte; um mentor pode conferir o arquivo inteiro a 100% |
| Intenção e quebra deliberada de regras | Cego, a menos que seja avisado (Venture Photography, nov. 2025) | Toma o seu objetivo como o modo que você escolhe, entre 6, e julga em relação a ele; além disso, não consegue conhecer a intenção, diz isso e deixa você marcar o problema apontado como não correspondente à sua foto | O que ele faz melhor |
| A mesma foto, lida de novo | Não medido nos textos publicados em que esta coluna se baseia; a resposta muda conforme você pergunta (TechRadar, dez. 2025) | Medido em todo teste completo; out. 2026, 77 críticas lidas 3 vezes: nunca mais de 0,4 de diferença entre as 3 leituras, a mesma Pontuação FinalFrame nas 3 para 47; a mesma letra de nível para 71 | Pode variar com cansaço, humor e a ordem das obras inscritas, e é por isso que os salões montam um júri |
| O que decide | Comenta quase todo aspecto, nos testes de um preprint de 2026; sem veredito fixo (arXiv:2606.29689) | Um problema de uma lista fixa; um sinal de parar com o motivo; um sim/não de vale a pena | O que mais importa para ele; um bom crítico vai dizer quando um quadro está pronto, ou não vale mais tempo |
| Velocidade e disponibilidade | De segundos a minutos, a qualquer hora | Cerca de um minuto, a qualquer hora, com a medição acima feita primeiro | Horas num fórum; uma semana ou mais para uma noite de clube ou um mentor |
Leia a coluna do FinalFrame como um modelo com um processo de medição em volta. Leia a coluna da direita como aquela para a qual você está preparando a fotografia.
Onde um crítico humano ainda ganha
Na intenção. Todas as fontes desta página chegam aqui. A Venture Photography, uma escola de workshops, num post de novembro de 2025 (assinatura: sengmah): “a IA só consegue avaliar o que vê visualmente, não se você atingiu o seu objetivo artístico.” (Venture Photography, 24 nov. 2025) Geoff Harris, da Amateur Photographer, deu ao ChatGPT um quadro de Henri Cartier-Bresson em novembro de 2025 e recebeu uma lista de melhorias, uma das quais, escreveu ele, “faria HCB se revirar no túmulo.” (Amateur Photographer, 17 nov. 2025) Um crítico humano que conhece você, ou que simplesmente pergunta o que você queria, lê o horizonte inclinado como a ideia. Um modelo o lê como um horizonte inclinado; e muitas vezes um juiz de salão também, que vê a imagem sem o autor ali para explicá-la.
A página de pontuação do FinalFrame diz que a crítica “não pode conhecer sua intenção” e que “um horizonte inclinado pode ser a ideia inteira”. O que ela leva em conta é o seu objetivo: você escolhe um modo (Limpo & natural, Clima & estilo, Pronto para imprimir, Pronto para competir, Social ou Entrega ao cliente) e a foto é julgada em relação a ele. Mesma foto, outro modo, outra pontuação, e é justamente isso. O conjunto rotulado inclui fotos de estilo deliberado (olhos atrás de óculos de sol ou da aba de um chapéu, um desfoque de movimento deliberado) para que uma escolha de estilo não seja lida como motivo para uma nova foto; o número de 0 em 132 acima inclui essas fotos. A crítica ainda pode dizer o que a escolha custa no modo que você escolheu. A regra de leitura é a da página de pontuação: dê menos peso a um defeito sinalizado quando ele foi uma decisão deliberada. Há mais sobre onde a IA pode errar em como funciona a Pontuação FinalFrame.
A emoção e a sala. Um crítico humano pode dizer se a imagem tocou nele, e como ela se lê ao lado do resto do seu trabalho. Os níveis do FinalFrame são calibrados pelo julgamento dos salões internacionais (as exposições PSA e FIAP), e esse é um padrão útil para se medir; ainda assim é um padrão, não um jurado. A conclusão de Harris é a que a maioria dos fotógrafos vai reconhecer: “nenhum grande concurso de fotografia que se preze demitiria o júri para colocar o ChatGPT no lugar.” (Amateur Photographer)
O problema da seletividade: o que um preprint de 2026 encontrou
A evidência publicada mais direta que encontramos é um preprint de junho de 2026 de Sajjad Ghiasvand e quatro coautores, “Can MLLMs Critique Like Humans?”, que avaliou oito modelos de pesos abertos mais o GPT-5.5 em comparação com críticas humanas classificadas de 1.227 posts do r/photocritique. (arXiv:2606.29689, v2 31 ago. 2026) Duas conclusões importam aqui.
Primeiro, os modelos de fronteira ganharam a preferência dos juízes: na condição principal, os 4 juízes LLM “preferem as críticas dos modelos de fronteira às humanas”. Mas, quando foram perguntados sobre quão parecida, em substância, cada crítica de modelo era da humana, os juízes e 2 anotadores humanos deram a todos os modelos entre 1,81 e 2,59 numa escala de 5 pontos, “perto de ‘majoritariamente diferente’”. (arXiv:2606.29689)
Segundo, e esta é a que vale guardar: “os modelos divergem de maneiras que as pontuações não revelam: cobrem quase todo aspecto estético em que os humanos são seletivos e se repetem entre críticas de uma mesma foto, mesmo quando instruídos a escrever com extensão humana.” Cobrir todo aspecto não é encontrar todo problema: os autores também constataram que “ocultar a imagem quase não muda” as pontuações automáticas de similaridade, e que a medida usual “premia um estilo de crítica fluente e abrangente, em vez da seletividade e da especificidade da crítica humana.” (arXiv:2606.29689) Em termos simples: deixado por conta própria, um modelo comenta quase tudo, e as pontuações automáticas do artigo quase não se mexeram quando o modelo nem viu a foto. Um bom crítico olha primeiro e depois deixa a maior parte de fora.
O design do FinalFrame responde às duas metades dessa conclusão, embora não tenhamos rodado o teste do artigo nele. A medição descrita acima amarra as leituras técnicas aos pixels. A metade da seletividade é uma escolha didática mais antiga que o artigo: a crítica aponta um problema, escolhido pelo que custa ao quadro no seu modo, e começa por ele, para que a próxima edição tenha um único alvo. Se esse problema é o que você teria apontado é uma pergunta justa; um controle “Não corresponde à minha foto” logo abaixo dele permite marcar quando não é.
Consistência: a parte difícil, e o que medimos
A consistência é uma das partes difíceis de qualquer crítica, humana ou de IA. Num estudo de 4 anos num grande concurso de vinhos dos Estados Unidos, juízes que receberam o mesmo vinho 3 vezes numa mesma sessão muitas vezes deram notas diferentes, alguns de Bronze a Ouro (Hodgson, Journal of Wine Economics, 2008); não encontramos nenhum estudo assim com juízes de fotografia. Um modelo também pode ler a mesma foto de formas diferentes, o nosso inclusive. Nenhuma fonte publicada que encontramos mediu isso, nem para um chatbot nem para qualquer app de crítica, então esta seção trata do nosso; é também um teste que você pode fazer com o que usar, nós inclusive: envie a mesma foto 3 vezes e compare. A página de pontuação do FinalFrame diz que a pontuação “pode variar um pouco quando a mesma foto é avaliada de novo”, e isso continua verdadeiro. O que fizemos foi medir quanto, e depois conter isso.
Na rodada de outubro de 2026, 77 críticas de 73 fotografias, cada uma lida 3 vezes, num conjunto cheio de casos-limite: nenhuma se moveu mais de 0,4 ponto entre as 3 leituras, e 47 das 77 tiveram a mesma Pontuação FinalFrame nas 3; a letra de nível coincidiu nas 3 em 71 das 77, o parecer de vale a pena em 73 e o sinal de parar em 75. Chegamos lá medindo primeiro: em agosto de 2026, com 10 fotos lidas 5 vezes cada, uma mudança na forma de rodar o modelo cortou pela metade a dispersão mediana entre a pontuação potencial mais alta e a mais baixa de uma foto (até onde a edição poderia levá-la), de 0,8 para 0,4 ponto. A dispersão agora é informada em todo teste completo; os números de outubro acima vêm de um desses testes.
Um limite. O problema apontado se repete com menos firmeza que a pontuação: numa rodada de setembro de 2026 com uma versão anterior, 71 fotos lidas 5 vezes cada, o mesmo problema ficou em primeiro em pelo menos 4 das 5 leituras para 59 delas, e nas 5 para 40, então uma nova leitura pode começar por um problema diferente.
Como usar os dois
Trate os dois como instrumentos diferentes, e não como rivais. Use a leitura da IA dentro do ciclo de edição: conserte a única coisa que ela aponta, envie a nova versão, veja se o conserto deu certo e pare quando o sinal de parar disser por quê. Na nova versão, a crítica diz se o problema anterior foi resolvido, parcialmente resolvido ou continua lá, e uma mudança de 0,1 ou menos na pontuação é rotulada como dentro da variação normal, em vez de ser apresentada como progresso.
Use pessoas onde a IA disse a você que é cega. Leve a versão final a uma noite de crítica num clube ou a um fórum como o r/photocritique e faça uma única pergunta: esta imagem diz o que eu quis dizer? Você vai receber a leitura emocional, a leitura do contexto e, às vezes, “não ligo para esta fotografia”, o que nenhum modelo vai dar a você. Quando os dois discordam sobre um defeito técnico, quem resolve é o arquivo, a 100% e no tamanho em que vai ser exibido; quando discordam sobre se o quadro funciona, o humano está respondendo à pergunta que importa.
Se você já consegue nomear o sintoma (um quadro chapado, um céu branco, um olho sem nitidez), vá direto ao índice de diagnóstico, que encaminha cada um para a sua lição. E se o quadro é limitado pela captura, nenhuma edição levanta esse limite: a pergunta passa a ser se ele funciona como está ou merece uma nova foto. Se você quer o método que uma crítica segue, e não uma comparação de quem a faz, leia como criticar uma foto.
Perguntas frequentes sobre crítica de foto com IA
- O ChatGPT consegue criticar as minhas fotos?
- Consegue, e com um prompt detalhado ele se sai melhor. Peter Fenech, da TechRadar, achou que “a tendência é que o retorno continue genérico”, a menos que descrevesse a intenção dele, e ainda assim suspeitou que boa parte vinha de “respostas prontas”. (TechRadar, dez. 2025; Amateur Photographer, nov. 2025) A OpenAI diz que, quando a Memória está ativada, o ChatGPT pode lembrar detalhes das suas conversas anteriores e usá-los para personalizar as respostas (OpenAI Help Center, “Memory in ChatGPT”, consultado em outubro de 2026). Se você quer um retorno sobre a foto que não seja moldado pelo que o ChatGPT sabe de você, abra um chat temporário e, onde houver a opção, escolha Unpersonalized (sem personalização). Nenhuma das duas matérias de revista o testou numa foto com defeito conhecido, e nenhuma mediu se ele lê a mesma foto do mesmo jeito duas vezes. O que o FinalFrame acrescenta fica fora do prompt: uma checagem de foco no detalhe que importa, feita como uma etapa própria, leituras testadas em fotos com defeitos conhecidos e uma resposta medida a quanto uma leitura repetida se move.
- A crítica de foto com IA é precisa?
- Depende do que foi medido, então peça os números. Os do FinalFrame, dos próprios testes rotulados: falta de nitidez apontada em 75 de 80 leituras de quadros claramente sem nitidez e, por engano, em 0 de 100 leituras de quadros nítidos (setembro de 2026, numa versão anterior), e, em 77 críticas de 73 fotografias, cada uma lida 3 vezes, o mesmo nível nas 3 leituras para 71 (outubro de 2026). Na intenção, ele conhece o modo que você escolhe: o padrão em relação ao qual julga. O que ele não consegue saber é que uma escolha dentro do quadro foi deliberada, então um céu em high-key ou uma inclinação intencional podem ser lidos como defeito; dê menos peso a essa observação. Os Termos dele chamam o resultado de “opinião algorítmica”, não avaliação especializada. Trate-o como uma segunda opinião medida em relação a um padrão declarado.
- O retorno da IA vai deixar as minhas fotos genéricas?
- Pode, se você agir em cima de tudo o que um modelo genérico diz: o preprint de 2026 constatou que os modelos “cobrem quase todo aspecto estético em que os humanos são seletivos”, e que a semelhança deles com as críticas humanas reflete “um estilo de crítica estável, mais do que uma observação específica da imagem” (arXiv:2606.29689); consertar 10 observações de uma vez é como um quadro com personalidade vira um quadro apenas correto. O FinalFrame aponta um problema por crítica, escolhido pelo que custa ao quadro no modo que você escolheu. Conserte, envie a nova versão e veja se o conserto deu certo. Se a única coisa que ele aponta é uma escolha que você fez de propósito, mantenha.
- Existe crítica de foto com IA grátis?
- Sim. A página inicial do FinalFrame oferece uma crítica de demonstração grátis, sem conta (o nível, as pontuações, o gargalo apontado e o veredito; os ajustes completos do editor exigem uma conta gratuita), e uma conta gratuita recebe 3 críticas por mês, 1 crédito cada, mais até 2 créditos bônus, ganhos uma única vez quando você envia uma versão editada.
Veja uma crítica medida de um quadro que você conhece bem
Envie uma fotografia sobre a qual você já tem uma opinião. O FinalFrame lê o foco dela e se ela tem um limite de captura, aponta o único problema que mais custa a ela e diz se vale a pena continuar editando, e por quê, quando manda parar. Os valores de slider para esse único conserto vêm com uma conta gratuita. Compare com o que você teria dito; as diferenças nos dois sentidos são a parte útil.
Criticar uma fotoChatGPT e OpenAI são marcas comerciais da OpenAI. O FinalFrame não é afiliado à OpenAI nem endossado por ela.