Yapay zeka ve insan fotoğraf eleştirisi: bir sohbet botu, bir eleştiri aracı ve bir insan neyi yakalar
Bir yapay zeka fotoğraf eleştirisi, modelin çevresine kurulan ve ölçülen şey kadar iyidir. Genel bir sohbet botu, yazdığın soruya cevap verir. FinalFrame önce fotoğrafı ölçer, ona her seferinde aynı sabit soruları sorar ve okumalarını kusurları önceden bilinen fotoğraflar üzerinde test eder. Elde ettiğin şey, seçtiğin bir standarda karşı ölçülmüş bir ikinci görüştür: adı konmuş tek bir sorun, düzenleme programında onun için kaydırıcı değerleri ve daha fazla düzenlemenin zahmete değip değmediğine dair bir karar; böylece bir sonraki düzenlemenin bir yönü olur. Niyette ve resmin etkisini gösterip göstermediğinde ise insan eleştirmen hâlâ üstündür.
Bir fotoğrafı bir sohbet botuna yapıştırıp “ne düşünüyorsun?” diye sorduysan, 2025'in sonlarında ChatGPT'yi test eden fotoğrafçıların anlattığı cevabı tanıyabilirsin: sıcak bir açılış, işe yarayanların bir listesi ve bir iki nazik öneri. Bu sayfanın kullandığı anlamda bir eleştiri ise fotoğrafa her seferinde aynı sabit soruları sorar, teknik durumunu ölçer, tek bir sorunun adını koyar ve sırada ne yapılacağına karar verir.
Bir sonraki fotoğrafı nereye göndereceğini seçiyorsan, bu sayfa sana FinalFrame'in ölçülmüş, tarihli rakamlarını, aynı isteğe bir sohbet botunun verdiği cevabın neye benzediğini ve bir insanın hâlâ nerede daha iyi olduğunu gösterir.
Yapay zeka fotoğraf eleştirisi nedir ve bir sohbet botuna sormaktan farkı ne
Genel bir sohbet botu aldığı isteme cevap verir. Ona bir fotoğraf ve belirsiz bir soru ver, neyden bahsedeceğini kendisi seçer. Digital Photographer'ın eski editörü, TechRadar'dan Peter Fenech, Aralık 2025'te tam olarak bu testi yaptı ve ilk turu tek bir satırla özetledi: “genel bir istem verildiğinde, geri bildirimi muhtemelen genel tutacaktır.” Niyetini adlandıran daha uzun istemler ona daha hedefli cevaplar getirdi. (TechRadar, 31 Aralık 2025)
Daha iyi bir istem, daha iyi biçimlenmiş bir cevap getirir; Fenech de tam olarak bunu buldu. FinalFrame'in eklediği şey istemde değil. Eleştiri yazılmadan önce fotoğrafı ölçer: dosyadaki kamera verilerini okur ve önemli olan detaydaki odağı, ayrı bir adım olarak, yakından kontrol eder. Ardından her eleştiri aynı sabit soruları sabit bir sırayla cevaplar; böylece okumanın neyi kapsadığı, ne kadar iyi sorduğuna bağlı olmaz. FinalFrame, Hizmet Koşulları'nda da yazdığı gibi bir OpenAI modeliyle çalışır. Model, sonucun bir parçasıdır. Geri kalanı, model yazmadan önce yapılan ölçüm ve yazdıklarının kusurları önceden bilinen fotoğraflar üzerinde test edilmesidir; bir sonraki bölüm rakamları veriyor.
Burada en önemli olan üç soru var. Kare önemli olan yerde keskin mi ve sorun yeniden çekim gerektiren bir sorun mu, yoksa masada düzeltilecek bir sorun mu: en sıkı test ettiğimiz 2 okuma bunlar. Kareye en çok hangi tek sorun mal oluyor; bu sorun sabit bir listeden adlandırılır ve seçtiğin kanalda kareye neye mal olduğuna göre seçilir, kanal da ölçülmek istediğin standarttır (Temiz & Doğal, Ruh Hali & Stil, Baskıya Hazır, Yarışmaya Hazır, Sosyal ya da Müşteri Teslimatı). Ve düzenlemeye devam etmeli misin: gerekçesiyle birlikte bir durma işareti, artı evet ya da hayır olan bir “zahmete değer mi” cevabı. Cevapla birlikte neyi oynatacağın da gelir: tercihlerinde seçtiğin düzenleme programında (Lightroom, Capture One, Photoshop ve diğerleri) o tek sorun için kaydırıcı değerleri; düzenlenmiş sürümü yükle, bir sonraki eleştiri o sorunun çözüldüğünü, kısmen çözüldüğünü ya da hâlâ mevcut olduğunu söyler. Bu soruları bir sohbet botuna yazabilirsin; yazamayacağın şeyler ise ilk sorunun arkasındaki odak kontrolü, bir sonraki bölümün aktardığı, kusurları bilinen fotoğraflar üzerindeki testler ya da düzenlemenin neyi değiştirdiğinin ölçümüdür: her yeni sürüm önce kendi başına puanlanır, sonra bir öncekine göre ölçülür, aynı dosyayı yeniden yüklemek ise aynı görsel olarak işaretlenir.
Yapay zeka eleştirisinin güçlü olduğu yerler ve bunu nereden biliyoruz
Teknik okumayla başla. Fenech'in kapanış görüşü “Yapay zeka teknik analizlerde çok iyi” şeklindeydi, ama o kendi bitmiş karelerini test etti ve bulduğumuz yazıların hiçbiri kusuru bilinen bir fotoğrafı denemedi. (TechRadar; Amateur Photographer, Kasım 2025; Venture Photography, Kasım 2025) Biz de kendi eleştirimizi test ettik. Eylül 2026'da eleştirinin daha önceki bir sürümüyle yaptığımız son tam odak testinde, açıkça yumuşak 16 fotoğrafın her biri 5 kez okundu: yumuşaklığı 80 okumanın 75'inde yakaladı ve 20 keskin fotoğrafın 100 okumasında hiçbirine bir kez bile yumuşak demedi. Ekim 2026'daki bir çalıştırmada, kamera verilerini taşıyan dosyalarda, gerçek bir çekim sınırı olan 15 fotoğrafın 45 okumasının hepsinde bu sınırı tespit etti ve bir stil tercihinin ya da düzeltilebilir bir kusurun öyle okunmaması gereken 44 fotoğrafın 132 okumasında 0 yanlış yeniden çekim kararı verdi. Bunlar zor olsun diye seçilmiş kendi fotoğraflarımız ve etiketlerimiz; senin fotoğrafların bu sette yok.
İkincisi durmak. İlk eleştiride FinalFrame sabit bir durma koşulları setini kontrol eder ve kare, hiçbir düzenlemenin kaldıramayacağı çekim düzeyinde bir sınır taşıyorsa, yani deklanşöre basıldığı anda oluşmuş, konuyu ıskalayan bir odak gibi bir kusur varsa, erkenden de dur diyebilir; bu durumda gerekçe o sınırı adlandırır ve kare, harcanacak bir saate değmez olarak işaretlenir. Düzenlerken açıkça keyif aldığın bir fotoğrafı düzenlemeyi bırakmanı söyleyecek pek az arkadaş vardır ve bunu söyleyecek mentor her zaman yanında olmaz; işaret, bu kararı her eleştiriye koyar. O işareti okumayla ilgili ders düzenlemeyi ne zaman bırakmalı.
Üçüncüsü puanın kendisi: kusurlu bir fotoğrafı sağlam bir fotoğrafın altına koyuyor mu? Ekim 2026'da, FinalFrame'in her yeni sürümünü karşılarında kontrol ettiğimiz etiketli test setlerinden 42 fotoğrafı puanladık: bilinen bir kusuru olan 16 (bunların 15'inde odak sorunu) ve kusuru olmayan 26. Sağlam bir fotoğrafla kusurlu bir fotoğrafın 416 eşleşmesinin 412'sinde (%99) FinalFrame sağlam fotoğrafa daha yüksek puan verdi; sağlam fotoğrafların ortalaması 7,0, kusurlu fotoğrafların ortalaması 5,4 oldu.
Aynı fotoğraflarda, yalnızca fotoğraf ve bir eleştiri ile 1-10 arası bir puan için kısa bir istek verilen GPT-6.1 Sol, OpenAI'ın API'si üzerinden (ChatGPT uygulaması değil) düşük efor ayarında sağlam fotoğraflara ortalama 7,7, kusurlu olanlara 6,7 verdi (yüksek eforda 7,7 ve 6,6): gruplar arasında yaklaşık 1 puan; FinalFrame'de bu fark 1,6'ydı. Yöntem, istem ve her fotoğrafın puanları: nasıl test ettik (İngilizce).
Yalın model, birkaç cümlelik talimat verilmiş yetenekli bir modeldir; FinalFrame'i yanına koyduğunda gördüğün şey, hangi modelin daha iyi olduğu değil, bir modelin çevresine ne kurulduğudur. FinalFrame'in modelin çevresine kurduğu şey, referans olarak kullanılmak üzere tasarlanmış bir eleştiridir: fotoğrafta bir kusur olduğunda düşen bir puan, adı konmuş tek bir sorun, daha fazla düzenlemenin zahmete değip değmediğine ya da karenin yeniden çekilmesi gerekip gerekmediğine dair bir karar, puanı en çok yükseltecek değişiklik ve seçtiğin kanalda bir sonraki düzenleme için kaydırıcı değerleri. Aşağıdaki iki fotoğraf, yalın bir cevabın ve puanının nerede birbirinden ayrılabileceğini gösteriyor.
Kusurlu fotoğraflardan ikisi: her biri ne yazdı ve kaç puan verdi
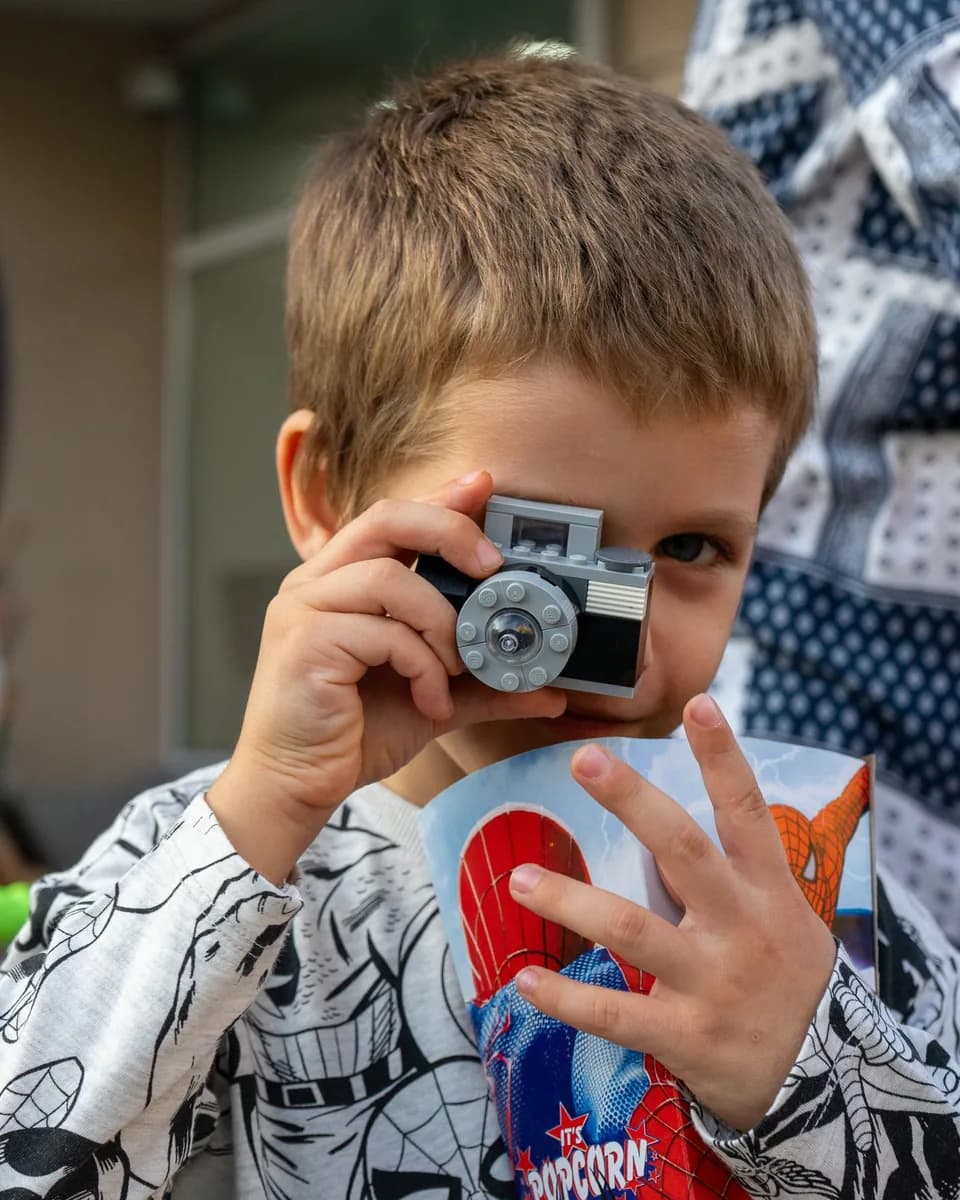
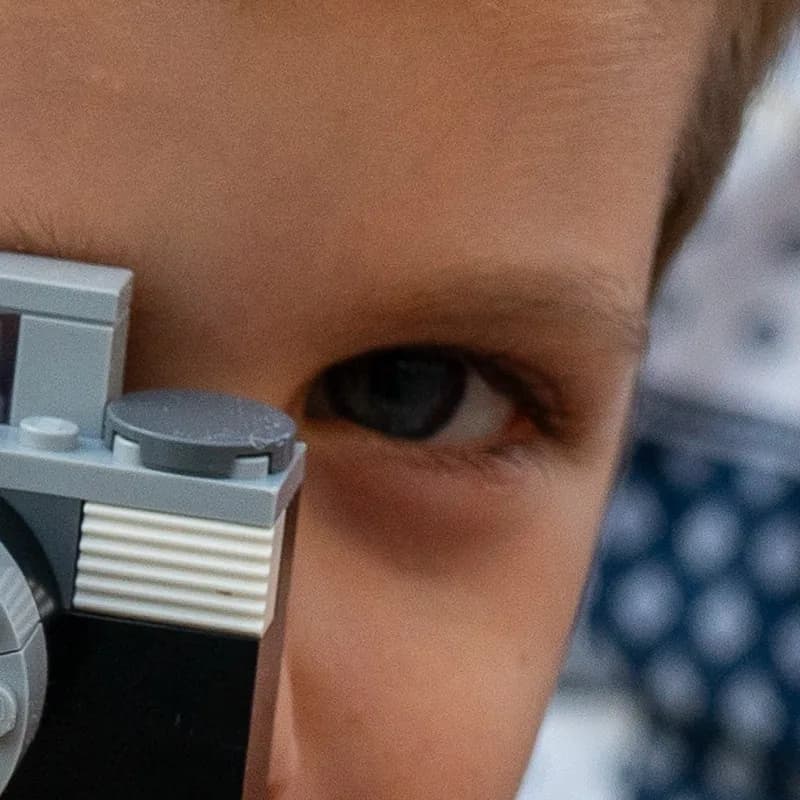
Göz, yakından, aynı dosyadan.
Yalın GPT-6.1 Sol (OpenAI API, düşük efor): 7,8/10. FinalFrame (Temiz & Doğal kanalı): 5,5/10. Her biri tek okuma, Ekim 2026.
GPT-6.1 Sol (OpenAI API, düşük efor; İngilizceden çevrildi)
7,8/10
GPT-6.1 Sol: “Odak, önemli olan yerde iyi; saçta, gözde ve ellerde hoş detaylar var.” En büyük sorun olarak gördüğü: “Onu geride tutan en büyük tek şey, sağdaki dikkat dağıtıcı arka plan figürü.”
FinalFrame (İngilizceden çevrildi)
5,5/10
FinalFrame: “görünen tek göz tüm portreyi taşımak zorunda ve temiz bir portfolyo görseli için yeterince keskin değil.” Ve kararı: “Bu sürümü düzenlemeye çok daha fazla zaman harcamazdım; fikir, göz tam isabetle odaklanmış olarak yeniden çekilmeye değer.”
Yalın model odağı övdü ve 7,8 verdi. FinalFrame yumuşak gözü sınır olarak adlandırdı, 5,5 verdi ve düzenlemeye devam etmek yerine yeniden çekmeyi söyledi: sözleri ve rakamı aynı şeyi söylüyor.
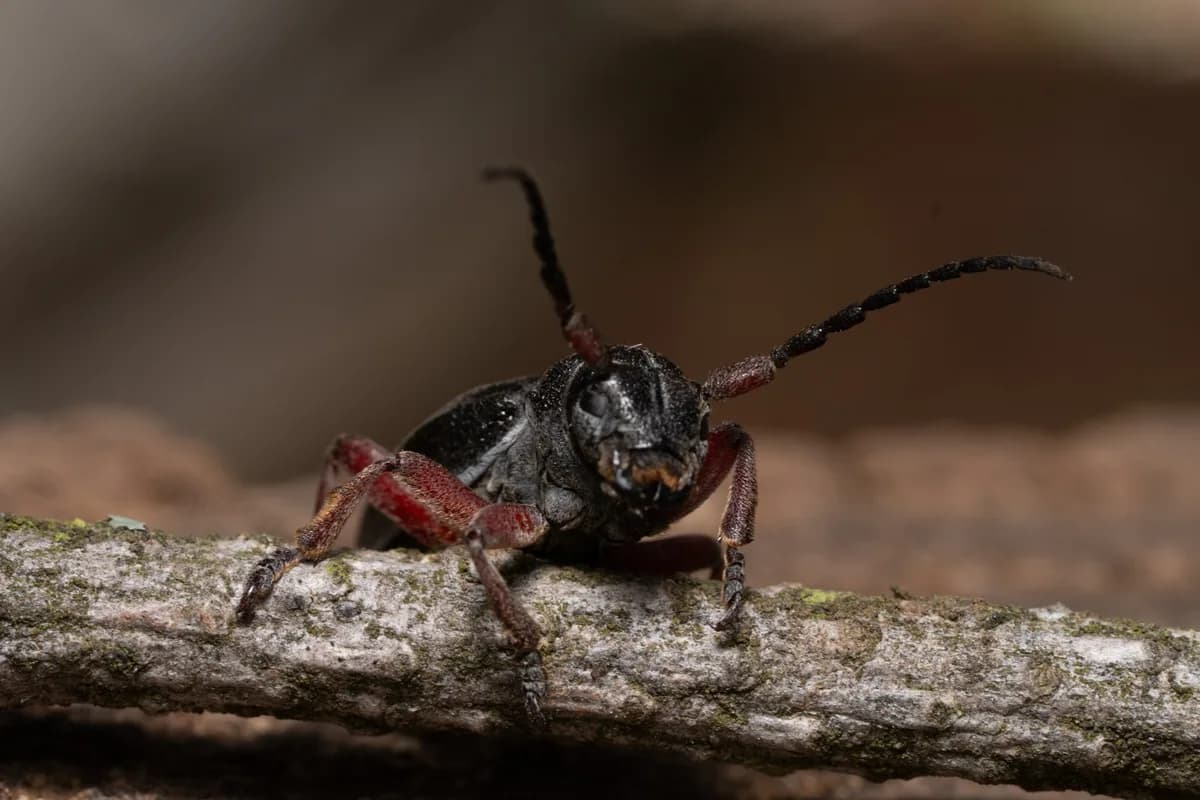
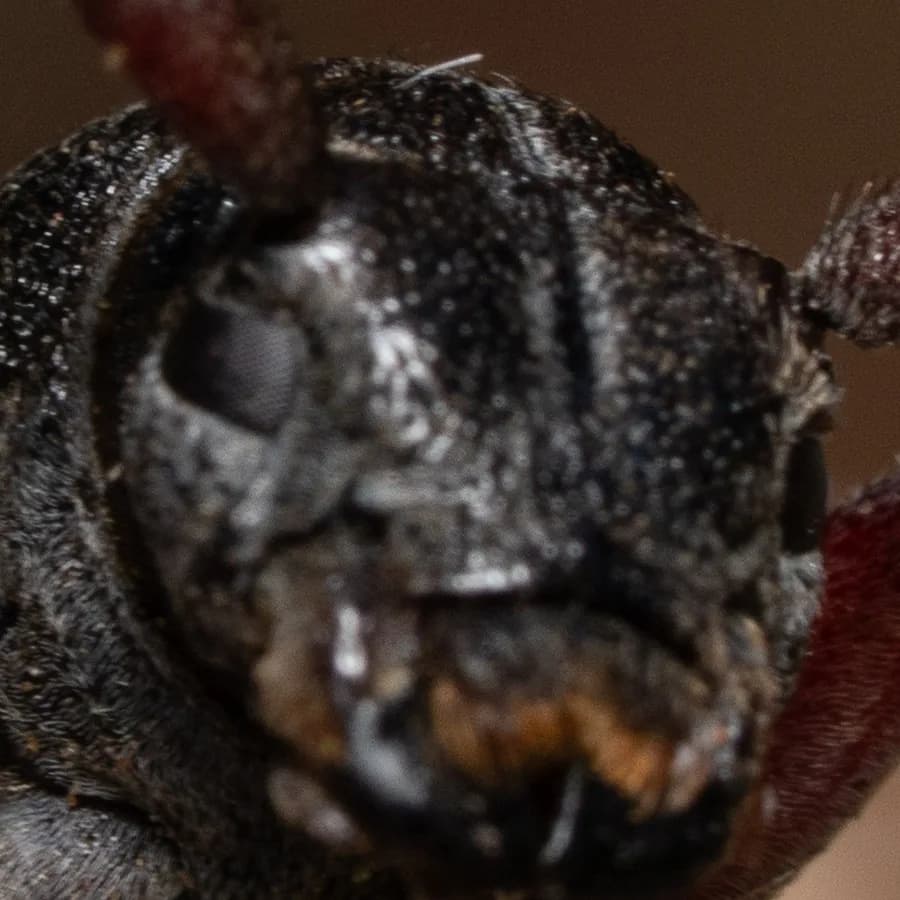
Göz, yakından, aynı dosyadan.
Yalın GPT-6.1 Sol (OpenAI API, düşük efor): 7,3/10. FinalFrame (Temiz & Doğal kanalı): 5,6/10. Her biri tek okuma, Ekim 2026.
GPT-6.1 Sol (OpenAI API, düşük efor; İngilizceden çevrildi)
7,3/10
GPT-6.1 Sol: “Onu geride tutan en büyük tek şey, gözlerin ve yüzün çevresinde keskin detay eksikliği. Bunlar doğal odak noktaları, ama biraz yumuşak görünüyorlar…”
FinalFrame (İngilizceden çevrildi)
5,6/10
FinalFrame: “yüz/göz bölgesi yeterli hassasiyetle seçilmiyor.” Ve kararı: “keskinleştirme ve yerel kontrast bunu keskin bir portfolyo işine dönüştürmeyecek.”
Burada ikisi de yumuşak yüzü adlandırdı. Oyuncak fotoğraf makinesindeki odağa iyi diyen yalın model, bunu yalnızca yarım puan düşük puanladı: 7,8'e karşı 7,3. FinalFrame'in 5,6'sı, sözlerinin söylediğini ve keskinleştirmenin bunu düzeltmeyeceğini söylüyor.
Hakkında zaten kendi kararını verdiğin bir fotoğrafta dene: adı konmuş tek bir sorun, daha fazla düzenlemenin zahmete değip değmediğine dair bir evet ya da hayır ve dur dediğinde gerekçesi. Sonra bunu senin söyleyeceğinle karşılaştır.
Bir fotoğrafı eleştirChatGPT uygulamasında aynı istek
Yukarıdaki test OpenAI'ın API'si üzerinden yapıldı. Çoğu insan ise ChatGPT uygulamasında sorar, çoğu zaman da arkasında önceki sohbetleri ve Memory özelliği vardır. Bu yüzden aynı isteği uygulamaya elle yazdık; Memory özelliği açık, ücretli bir hesapta, uygulamanın açıldığı model ve ayarla (GPT-6, Medium). Yukarıdaki 2 örnek fotoğrafı (API modelinin puanı bizimkinden en uzak olanlar arasında olduğu için seçilmişlerdi) ve aynı setten 1 sağlam fotoğrafı sorduk; her birini 3 kez, her seferinde yeni bir sohbette.
Uygulamanın puanları bir sohbetten diğerine neredeyse hiç değişmedi: sağlam fotoğraf için 7,6, 7,6 ve 7,8; oyuncak fotoğraf makinesi için 7,2, 7,2 ve 7,1; böcek için 7,2, 7,4 ve 7,2. 3 turun her birinde sağlam fotoğrafı iki kusurlu fotoğrafın da üstünde, 0,2 ile 0,7 puan farkla puanladı. Odağın gözü ıskaladığı fotoğraf olan oyuncak fotoğraf makinesi için verilen 3 cevabın hiçbiri yumuşak gözü fark etmedi: 2'si odağa iyi dedi (“Odak makul ölçüde keskin”, İngilizceden çevrildi), üçüncüsü odağın düştüğü yer olan saçtaki, ellerdeki ve oyuncak fotoğraf makinesindeki detayı övdü ve 3'ü de suçu görsel karmaşaya attı. Böcekte sözleri rakamlarından daha çok değişti: 2 cevap yüzdeki yumuşak odağı adlandırdı, üçüncüsü “Böceğin yüzü fazla karanlık” (İngilizceden çevrildi) diyerek farklı bir sorunu adlandırdı ve gölgeleri açmayı önerdi; puan her durumda 7,2 ile 7,4 arasında kaldı.
O 2 örnek büyük ıskalar için seçildiğinden, öyle olmayan 2 fotoğraf ekledik: kendi kalibrasyon setimizden, sıradan bir kusuru olan (düz, parlak ışık ve neredeyse patlamış bir gökyüzü) bir eşek portresi ve ikinci bir sağlam fotoğraf olarak bir gün batımı panoraması; her biri için 3 sohbet. Eşekte uygulama 3 sohbetin her birinde farklı bir ana sorun adlandırdı: önce ışık, sonra boş alan, sonra eşeğin başının arkadaki ağaçların önünde kalması; her biri bu fotoğraf hakkında yerinde bir tespit ve 2'si kurucumuzun kendi değerlendirmesinde de var, ama her seferinde farklı biri. Aynı dosya üzerinde 3 kez çalıştırılan FinalFrame ise her seferinde parlak gökyüzünün yüzün önüne geçtiğini adlandırdı, her seferinde 7,0 verdi ve her seferinde aynı düzenleme planını sundu. Panoramada uygulamanın 3 cevabı da FinalFrame'in 3 çalıştırması da karanlık ön plana işaret etti. Bu 2 fotoğrafta uygulamanın puanları FinalFrame'inkilerin yarım puan yakınındaydı; oyuncak fotoğraf makinesi ve böcekteki büyük farklar, büyük ıskalar için seçilmiş 2 fotoğraftaydı.
API üzerinden GPT-6.1 Sol, ilk 3 fotoğrafa düşük eforda 8,2, 7,8 ve 7,3 vermişti. Uygulamadaki çalıştırma bundan Memory'den daha fazlasıyla ayrılıyor: farklı bir model (GPT-6.1 Sol değil, GPT-6), farklı bir efor ayarı ve uygulamanın bir sohbete eklediği her şey. Tek bir hesaptı, kurucunun hesabı, Memory de açıktı; yani önceki sohbetler sonrakileri etkilemiş olabilir. Bu yüzden bu, tek başına Memory'nin bir puanı ne kadar oynattığını değil, ChatGPT'yi senin kullanacağın şekilde kullandığında ne aldığını gösteriyor. Puanlar nasıl test ettik sayfasında (İngilizce).
Bir fotoğrafı eleştirtmenin üç yolu
Her satırın istisnaları var. Sohbet botu sütunu, fotoğrafçıların ve bir araştırma ekibinin Kasım 2025 ile Ağustos 2026 arasında yayımladıklarını özetler; bunlar kontrollü bir test değil, tek tek deneyimlerdir ve sohbet botları sık sık değişir. Yalın bir modelle OpenAI'ın API'si üzerinden ve ChatGPT uygulamasında elle yaptığımız kendi testlerimiz tablonun üstünde aktarıldı ve bu sütunun parçası değil.
| Gelişigüzel sorulan bir sohbet botu | FinalFrame | Bir insan eleştirmen | |
|---|---|---|---|
| Teknik temeller | Bir test eden onu kendi bitmiş karelerinde iyi değerlendirdi; kusuru bilinen bir fotoğrafta test edilmedi (TechRadar, Aralık 2025) | Eylül 2026'da, daha önceki bir sürümde ölçüldü: açıkça yumuşak fotoğrafların 80 okumasının 75'inde yumuşaklık işaretlendi, keskin fotoğrafların 100 okumasında 0 yanlış işaret; orijinal dosyandan değil, fotoğrafının saklanan bir kopyasından okunur ve odak kontrolü ana detayda ayrı bir adım olarak yapılır | Güçlü; bir mentor dosyanın tamamını %100'de kontrol edebilir |
| Niyet ve kuralları bilinçli olarak çiğnemek | Söylenmedikçe kör (Venture Photography, Kasım 2025) | Hedefini, 6 kanal arasından seçtiğin kanal olarak alır ve ona göre değerlendirir; bunun ötesinde niyeti bilemez, bunu söyler ve adı konan sorunu fotoğrafınla uyuşmuyor diye işaretlemene izin verir | En iyi yaptığı iş |
| Aynı fotoğraf, yeniden okunduğunda | Bu sütunun dayandığı yayımlanmış yazılarda ölçülmedi; cevap, nasıl sorduğuna göre değişir (TechRadar, Aralık 2025) | Her tam test çalıştırmasında ölçülür; Ekim 2026, 3 kez okunan 77 eleştiri: 3 okuma boyunca fark hiçbir zaman 0,4'ü aşmadı, 47'sinde 3 okumada da aynı FinalFrame Puanı; 71'inde aynı harf kademesi | Yorgunluk, ruh hâli ve eserlerin sırasıyla kayabilir; salonların tek kişi yerine bir jüri kurulu oluşturmasının nedeni de bu |
| Neye karar verir | 2026 tarihli bir ön baskının testlerinde neredeyse her yöne yorum yapar; sabit bir karar yok (arXiv:2606.29689) | Sabit bir listeden tek bir sorun; gerekçesiyle bir durma işareti; evet/hayır bir “zahmete değer mi” cevabı | Onun için en önemli olan; iyi bir eleştirmen bir karenin ne zaman bittiğini ya da daha fazla zamana değmediğini sana söyler |
| Hız ve erişilebilirlik | Saniyelerden dakikalara, günün her saati | Yaklaşık bir dakika, günün her saati; yukarıdaki ölçüm önce yapılır | Bir forumda saatler; bir kulüp gecesi ya da bir mentor için bir hafta veya daha fazla |
FinalFrame sütununu, çevresinde bir ölçüm süreci olan bir model olarak oku. Sağdaki sütunu da fotoğrafı kimin için hazırladığının sütunu olarak oku.
İnsan eleştirmenin hâlâ üstün olduğu yerler
Niyet. Bu sayfadaki her kaynak buraya varıyor. Bir atölye okulu olan Venture Photography, Kasım 2025 tarihli bir yazısında (imza: sengmah): “Yapay zeka yalnızca görsel olarak gördüğünü değerlendirebilir, sanatsal hedefine ulaşıp ulaşmadığını değil.” (Venture Photography, 24 Kasım 2025) Amateur Photographer'dan Geoff Harris, Kasım 2025'te ChatGPT'ye bir Henri Cartier-Bresson karesi verdi ve bir iyileştirme listesi aldı; yazdığına göre bunlardan biri “HCB'yi mezarında ters döndürürdü.” (Amateur Photographer, 17 Kasım 2025) Seni tanıyan ya da sadece neyin peşinde olduğunu soran bir insan eleştirmen, eğik ufku fikrin kendisi olarak okur. Model onu eğik bir ufuk olarak okur; çoğu zaman bir salon jüri üyesi de öyle okur, çünkü resmi, onu açıklayacak sahibi yanında olmadan görür.
FinalFrame'in puanlama sayfası, eleştirinin “niyetini bilemez” olduğunu ve “eğik bir ufuk fikrin ta kendisi olabilir” diyor. Eleştirinin hesaba kattığı şey ise hedefindir: bir kanal seçersin (Temiz & Doğal, Ruh Hali & Stil, Baskıya Hazır, Yarışmaya Hazır, Sosyal ya da Müşteri Teslimatı) ve fotoğraf ona göre değerlendirilir. Aynı fotoğraf, farklı kanal, farklı puan; mesele tam da bu. Etiketli set bilinçli stil içeren fotoğraflar barındırır (güneş gözlüğünün ya da şapka siperliğinin arkasındaki gözler, kasıtlı bir hareket bulanıklığı), böylece bir stil tercihi yeniden çekim için bir gerekçe olarak okunmaz; yukarıdaki 132'de 0 rakamı bunları da kapsar. Eleştiri yine de bu tercihin seçtiğin kanalda neye mal olduğunu söyleyebilir. Okuma kuralı puanlama sayfasınınkidir: işaretlenen bir kusur bilinçli bir karar idiyse ona daha az ağırlık ver. Yapay zekanın nerede yanılabileceği hakkında daha fazlası FinalFrame Puanı nasıl çalışır sayfasında.
Duygu ve bağlam. Bir insan eleştirmen resmin onda bir etki bırakıp bırakmadığını ve işlerinin geri kalanının yanında nasıl okunduğunu sana söyleyebilir. FinalFrame'in kademeleri uluslararası salon jürilerine (PSA ve FIAP sergileri) göre kalibre edilmiştir ve bu, kendini ölçmek için yararlı bir standarttır; ama yine de bir standarttır, bir jüri üyesi değil. Harris'in vardığı sonuç, çoğu fotoğrafçının tanıyacağı sonuçtur: “adı sanı olan hiçbir büyük fotoğraf yarışması jüriyi kovup yerine ChatGPT'yi getirmez.” (Amateur Photographer)
Seçicilik sorunu: 2026 tarihli bir ön baskının bulguları
Bulduğumuz en doğrudan yayımlanmış kanıt, Sajjad Ghiasvand ve dört ortak yazarının Haziran 2026 tarihli “Can MLLMs Critique Like Humans?” başlıklı ön baskısı; bu çalışma sekiz açık ağırlıklı model ile GPT-5.5'i, 1.227 r/photocritique gönderisinin sıralanmış insan eleştirilerine karşı puanladı. (arXiv:2606.29689, v2 31 Ağustos 2026) Burada iki bulgu önemli.
Birincisi, en ileri (frontier) modeller jürilerin tercihini kazandı: ana koşulda 4 LLM jürisinin hepsi “en ileri modellerin eleştirilerini insanlarınkine tercih ediyor”. Ama her model eleştirisinin özünde insanınkine ne kadar benzediği sorulduğunda, jüriler ve 2 insan işaretleyici her modele 5 puanlık bir ölçekte 1,81 ile 2,59 arasında puan verdi: “‘çoğunlukla farklı’ya yakın”. (arXiv:2606.29689)
İkincisi, ve akılda tutulacak olan bu: “modeller, puanların ortaya çıkarmadığı biçimlerde ayrışıyor: insanların seçici olduğu yerde neredeyse her estetik yönü ele alıyorlar ve insan uzunluğunda yazmaları istendiğinde bile tek bir fotoğrafın eleştirileri boyunca kendilerini tekrarlıyorlar.” Her yönü ele almak, her sorunu bulmak demek değildir: yazarlar ayrıca “görüntüyü saklamanın” otomatik benzerlik puanlarını “neredeyse hiç değiştirmediğini” ve olağan ölçünün “insan eleştirisinin seçiciliğini ve özgüllüğünü değil, akıcı, kapsamlı bir eleştiri üslubunu ödüllendirdiğini” buldu. (arXiv:2606.29689) Kısacası: kendi hâline bırakılan bir model neredeyse her şey hakkında yorum yapar ve makalenin otomatik puanları, model fotoğrafı hiç görmediğinde bile neredeyse kıpırdamadı. İyi bir eleştirmen önce bakar, sonra çoğunu dışarıda bırakır.
FinalFrame'in tasarımı bu bulgunun iki yarısına da cevap veriyor, ancak makalenin testini onun üzerinde çalıştırmadık. Yukarıda anlatılan ölçüm, teknik okumaları piksellere bağlar. Seçicilik yarısı ise makaleden eski bir öğretim tercihidir: eleştiri, senin kanalında kareye neye mal olduğuna göre seçilmiş tek bir sorunun adını koyar ve o sorunla başlar; böylece bir sonraki düzenlemenin tek bir hedefi olur. O sorunun senin adını koyacağın sorun olup olmadığı yerinde bir soru; altındaki “Fotoğrafımla uyuşmuyor” kontrolü, öyle olmadığında onu işaretlemeni sağlar.
Tutarlılık: işin zor kısmı ve ne ölçtük
Tutarlılık, insan ya da yapay zeka, her eleştirinin zor kısımlarından biridir. ABD'deki büyük bir şarap yarışmasında yapılan 4 yıllık bir çalışmada, aynı şarabı tek bir oturumda 3 kez tadan jüri üyeleri ona çoğu zaman farklı puanlar verdi, bazıları bronzdan altına kadar (Hodgson, Journal of Wine Economics, 2008); fotoğraf jürileri üzerine böyle bir çalışma bulamadık. Bir model de aynı fotoğrafı farklı okuyabilir, bizimki de dahil. Bulduğumuz yayımlanmış kaynakların hiçbiri bunu bir sohbet botu için de, herhangi bir eleştiri uygulaması için de ölçmedi; bu yüzden bu bölüm bizimkiyle ilgili. Bu aynı zamanda kullandığın her şey üzerinde, biz de dahil, yapabileceğin bir test: aynı fotoğrafı 3 kez gönder ve karşılaştır. FinalFrame'in puanlama sayfası “aynı fotoğraf yeniden değerlendirildiğinde biraz farklı çıkabilir” diyor ve bu hâlâ doğru. Bizim yaptığımız, farkın ne kadar olduğunu ölçmek ve sonra onu sınırlamaktı.
Ekim 2026'daki çalıştırmada, sınır vakalarıyla dolu bir sette her biri 3 kez okunan 73 fotoğrafın 77 eleştirisinin hiçbiri 3 okuma boyunca 0,4 puandan fazla oynamadı ve 77'nin 47'si 3 okumanın hepsinde aynı FinalFrame Puanı'nı aldı; harf kademesi 77'nin 71'inde 3 okumanın hepsinde aynı çıktı, “zahmete değer mi” cevabı 73'ünde, durma kararı 75'inde. Buraya önce ölçerek geldik: Ağustos 2026'da, her biri 5 kez okunan 10 fotoğrafta, modelin çalıştırılma biçimindeki tek bir değişiklik, bir fotoğrafın en yüksek ve en düşük potansiyel puanı (düzenlemenin onu ne kadar ileri götürebileceği) arasındaki medyan farkı 0,8 puandan 0,4'e indirerek yarıya düşürdü. Bu fark artık her tam test çalıştırmasında raporlanıyor; yukarıdaki Ekim rakamları bu çalıştırmalardan birinden geliyor.
Bir sınır. Adı konan sorun, puandan daha az sıkı tekrar eder: Eylül 2026'da daha önceki bir sürümle yapılan ve her biri 5 kez okunan 71 fotoğraflık bir çalıştırmada, aynı sorun bunların 59'unda 5 okumanın en az 4'ünde başa geçti, 40'ında ise 5'inin hepsinde; yani yeniden okuma farklı bir sorunla başlayabilir.
İkisi birlikte nasıl kullanılır
İkisini rakip değil, farklı araçlar olarak gör. Yapay zeka okumasını düzenleme döngüsünün içinde kullan: adını koyduğu tek şeyi düzelt, yeni sürümü yükle, düzeltmenin işe yarayıp yaramadığını gör ve durma işareti nedenini söylediğinde dur. Yeni sürümde eleştiri, önceki sorunun çözüldüğünü, kısmen çözüldüğünü ya da hâlâ mevcut olduğunu söyler ve 0,1 ya da daha küçük bir puan değişimi ilerleme olarak raporlanmaz, “normal değişim aralığında” olarak etiketlenir.
İnsanları, yapay zekanın sana kör olduğunu söylediği yerde kullan. Bitmiş sürümü bir kulübün eleştiri gecesine ya da r/photocritique gibi bir foruma götür ve tek bir soru sor: bu resim kastettiğim şeyi söylüyor mu? Duygusal okumayı, bağlam okumasını ve bazen de hiçbir modelin sana vermeyeceği “bu fotoğraf bana hiçbir şey ifade etmiyor” cevabını alırsın. İkisi teknik bir kusurda anlaşamadığında meseleyi dosya çözer: %100'de ve gösterileceği boyutta; karenin işe yarayıp yaramadığında anlaşamadıklarında ise önemli olan soruyu cevaplayan insandır.
Belirtiyi zaten adlandırabiliyorsan (düz bir kare, beyaz bir gökyüzü, yumuşak bir göz), doğrudan her belirtiyi kendi dersine yönlendiren teşhis dizinine git. Kare çekimle sınırlı ise hiçbir düzenleme o sınırı kaldıramaz: soru, karenin olduğu hâliyle işe yarayıp yaramadığına ya da yeniden çekimi hak edip etmediğine döner. Eleştiriyi kimin verdiğinin karşılaştırmasını değil de bir eleştirinin izlediği yöntemi istiyorsan, bir fotoğraf nasıl eleştirilir sayfasını oku.
Yapay zeka fotoğraf eleştirisi hakkında sık sorulan sorular
- ChatGPT fotoğraflarımı eleştirebilir mi?
- Eleştirir ve ayrıntılı bir istemle daha iyisini yapar. TechRadar'dan Peter Fenech, niyetini anlatmadıkça onun “geri bildirimi muhtemelen genel tutacağını” gördü ve yine de çoğunun “hazır cevaplardan çekildiğinden” şüphelendi. (TechRadar, Aralık 2025; Amateur Photographer, Kasım 2025) OpenAI'a göre Memory açıkken ChatGPT önceki sohbetlerinden ayrıntıları hatırlayabilir ve cevaplarını kişiselleştirmek için kullanabilir (OpenAI Help Center, “Memory in ChatGPT”, Ekim 2026'da okundu). Fotoğraf hakkında, ChatGPT'nin seninle ilgili bildiklerinin şekillendirmediği bir geri bildirim istiyorsan geçici bir sohbet (Temporary Chat) başlat ve seçenek sunduğu yerde Unpersonalized (kişiselleştirilmemiş) seçeneğini seç. İki dergi yazısı da onu kusuru bilinen bir fotoğrafta test etmedi ve hiçbiri aynı fotoğrafı iki kez aynı şekilde okuyup okumadığını ölçmedi. FinalFrame'in eklediği şey istemin dışında: önemli olan detayda ayrı bir adım olarak yapılan bir odak kontrolü, kusurları bilinen fotoğraflarda test edilmiş okumalar ve tekrarlanan bir okumanın ne kadar oynadığına dair ölçülmüş bir cevap.
- Yapay zeka fotoğraf eleştirisi doğru mu?
- Neyin ölçüldüğüne bağlı; bu yüzden rakamları iste. FinalFrame'in rakamları, kendi etiketli test çalıştırmalarından: açıkça yumuşak karelerin 80 okumasının 75'inde yumuşaklık işaretlendi, keskin karelerin 100 okumasının 0'ında yanlışlıkla işaretlendi (Eylül 2026, daha önceki bir sürümde) ve her biri 3 kez okunan 73 fotoğrafın 77 eleştirisinin 71'inde 3 okumanın hepsinde aynı kademe çıktı (Ekim 2026). Niyet konusunda, seçtiğin kanalı bilir: değerlendirirken karşısına koyduğu standart. Bilemediği şey, kare içindeki bir tercihin bilinçli olduğudur. Bu yüzden high-key bir gökyüzü ya da kasıtlı bir eğim kusur olarak okunabilir; o nota daha az ağırlık ver. FinalFrame'in Hizmet Koşulları çıktıyı uzman değerlendirmesi değil, “algoritmik bir görüş” olarak adlandırır. Onu adı konmuş bir standarda karşı ölçülmüş bir ikinci görüş olarak değerlendir.
- Yapay zeka geri bildirimi fotoğraflarımı sıradanlaştırır mı?
- Genel bir modelin söylediği her şeye göre hareket edersen sıradanlaştırabilir: 2026 tarihli ön baskı, modellerin “insanların seçici olduğu yerde neredeyse her estetik yönü ele aldığını” ve insan eleştirilerine benzerliklerinin “görüntüye özgü gözlemden çok, istikrarlı bir eleştiri üslubunu” yansıttığını buldu (arXiv:2606.29689); 10 notu birden düzeltmek, kendine özgü bir karenin yalnızca doğru bir kareye dönüşme biçimidir. FinalFrame her eleştiride, seçtiğin kanalda kareye neye mal olduğuna göre seçilmiş tek bir sorunun adını koyar. Onu düzelt, yeni sürümü yükle ve düzeltmenin işe yarayıp yaramadığını gör. Adını koyduğu tek şey bilerek yaptığın bir tercihse onu koru.
- Ücretsiz bir yapay zeka fotoğraf eleştirisi var mı?
- Evet. FinalFrame ana sayfası hesap gerektirmeyen ücretsiz bir demo eleştiri sunar (kademe, puanlar, adı konmuş darboğaz ve karar; düzenleme ayarlamalarının tamamı için ücretsiz bir hesap gerekir) ve ücretsiz bir hesap ayda her biri 1 kredi olan 3 eleştirinin yanı sıra, düzenlenmiş bir sürüm yüklediğinde bir kez kazanılan 2'ye kadar bonus kredi alır.
İyi tanıdığın bir karenin ölçülmüş eleştirisini gör
Hakkında zaten bir fikrin olan bir fotoğraf yükle. FinalFrame odağını ve bir çekim sınırı olup olmadığını okur, ona en çok mal olan tek sorunun adını koyar ve daha fazla düzenlemenin zahmete değip değmediğini, dur dediğinde de nedenini söyler. O tek düzeltme için kaydırıcı değerleri ücretsiz bir hesapla gelir. Bunu senin söyleyeceğinle karşılaştır; her iki yöndeki farklar işe yarayan kısımdır.
Bir fotoğrafı eleştirChatGPT ve OpenAI, OpenAI'ın ticari markalarıdır. FinalFrame, OpenAI ile resmi olarak bağlantılı değildir ve OpenAI tarafından onaylanmamaktadır.