Krytyka zdjęć przez AI a przez człowieka: co wychwytuje chatbot, narzędzie do krytyki i ludzki krytyk
Krytyka zdjęć przez AI jest tak dobra, jak to, co zbudowano i zmierzono wokół modelu. Ogólny chatbot odpowiada na pytanie, które wpiszesz. FinalFrame najpierw mierzy zdjęcie, za każdym razem zadaje mu te same stałe pytania i sprawdza swoje odczyty na zdjęciach, których wady są już znane. Dostajesz zmierzoną drugą opinię względem wybranego przez siebie standardu: jeden nazwany problem, wartości suwaków dla niego w twoim edytorze i werdykt, czy dalsza edycja jest warta wysiłku, żeby następna edycja miała kierunek. Ludzki krytyk wciąż wygrywa w odczytaniu zamiaru i w tym, czy obraz trafia do odbiorcy.
Kto wkleił kiedyś zdjęcie do chatbota z pytaniem „co o tym myślisz?”, ten może rozpoznać odpowiedź, którą opisują fotografowie testujący ChatGPT pod koniec 2025 roku: ciepłe otwarcie, listę tego, co działa, i jedną albo dwie łagodne sugestie. Krytyka w rozumieniu tej strony za każdym razem zadaje zdjęciu stałe pytania, mierzy jego stan techniczny, nazywa jeden problem i decyduje, co zrobić dalej.
Jeśli wybierasz, gdzie wysłać następne zdjęcie, ta strona podaje zmierzone liczby FinalFrame, z datami, pokazuje, jak wygląda odpowiedź chatbota na tę samą prośbę, i mówi, gdzie człowiek wciąż radzi sobie lepiej.
Czym jest krytyka zdjęć przez AI i czym różni się od pytania chatbota
Ogólny chatbot odpowiada na prompt, który dostaje. Daj mu zdjęcie i ogólnikowe pytanie, a sam wybierze, o czym mówić. Peter Fenech z TechRadar, były redaktor Digital Photographer, przeprowadził dokładnie taki test w grudniu 2025 roku i podsumował pierwszą rundę jednym zdaniem: „przy ogólnym prompcie uwagi najpewniej też pozostaną ogólne”. Dłuższe prompty, które nazywały jego zamiar, dały mu bardziej ukierunkowane odpowiedzi. (TechRadar, 31 gru 2025)
Lepszy prompt daje odpowiedź o lepszym kształcie; Fenech przekonał się dokładnie o tym. To, co dodaje FinalFrame, nie siedzi w prompcie. Mierzy zdjęcie, zanim powstanie krytyka: odczytuje dane aparatu zapisane w pliku i sprawdza ostrość na detalu, który się liczy, z bliska, jako osobny krok. Potem każda krytyka odpowiada na te same stałe pytania, w stałej kolejności, więc to, co obejmuje odczyt, nie zależy od tego, jak dobrze padło pytanie. FinalFrame działa na modelu OpenAI, co podaje jego Regulamin. Model to jedna część rezultatu. Pomiar, zanim model zacznie pisać, i sprawdzanie tego, co pisze, na zdjęciach o znanych wadach, to reszta; liczby podaje następna sekcja.
Trzy pytania są tu najważniejsze. Czy kadr jest ostry tam, gdzie trzeba, i czy problem wymaga powtórzenia zdjęcia, czy da się go rozwiązać przy biurku: to 2 odczyty, które sprawdzamy najsurowiej. Który jeden problem najwięcej kosztuje kadr, nazwany ze stałej listy i wybrany według tego, ile kosztuje kadr w wybranym trybie, czyli w standardzie, według którego ma być mierzone twoje zdjęcie (Czysty & naturalny, Nastrój & styl, Gotowy do druku, Gotowy na konkurs, Społecznościowy albo Dostawa do klienta). I czy edytować dalej: flaga zatrzymania z uzasadnieniem oraz werdykt „warto” albo „nie warto”, czyli tak albo nie. Razem z odpowiedzią dostajesz to, co przesunąć: wartości suwaków dla tego jednego problemu w edytorze ustawionym w twoich preferencjach (Lightroom, Capture One, Photoshop i inne); wgraj edytowaną wersję, a następna krytyka powie, czy ten problem jest rozwiązany, częściowo rozwiązany, czy nadal jest. Te pytania można wpisać do chatbota; nie da się wpisać sprawdzenia ostrości, które stoi za pierwszym z nich, testów na zdjęciach o znanych wadach, o których mówi następna sekcja, ani pomiaru tego, co zmieniła twoja edycja: każda nowa wersja dostaje własną ocenę, a potem jest mierzona względem poprzedniej, a ponowne wgranie tego samego pliku zostaje oznaczone jako ten sam obraz.
Gdzie krytyka AI jest mocna i skąd to wiemy
Najpierw odczyt techniczny. Końcowy wniosek Fenecha brzmiał: „AI jest bardzo dobra w analizach technicznych”, ale testował własne, gotowe kadry, a żaden z tekstów, które znaleźliśmy, nie sprawdził zdjęcia ze znaną wadą. (TechRadar; Amateur Photographer, lis 2025; Venture Photography, lis 2025) Sprawdziliśmy więc nasze. W naszym ostatnim pełnym teście ostrości, przeprowadzonym we wrześniu 2026 roku na wcześniejszej wersji krytyki, 16 wyraźnie miękkich zdjęć odczytano po 5 razy: krytyka wychwyciła miękkość w 75 z 80 odczytów, a w 100 odczytach 20 ostrych zdjęć ani razu nie nazwała żadnego miękkim. W przebiegu z października 2026 roku, na plikach z zachowanymi danymi aparatu, wykryła rzeczywiste ograniczenie ujęcia we wszystkich 45 odczytach 15 zdjęć, które je miały, i dała 0 fałszywych wskazań do powtórzenia zdjęcia w 132 odczytach 44 zdjęć, w których wybór stylistyczny albo wada do poprawienia nie może zostać odczytana jako takie ograniczenie. To nasze własne zdjęcia i etykiety, dobrane tak, żeby były trudne; twoich zdjęć w tym zestawie nie ma.
Druga mocna strona to zatrzymanie. Przy pierwszej krytyce FinalFrame sprawdza stały zestaw warunków zatrzymania i może kazać przestać wcześniej, gdy kadr ma ograniczenie ujęcia, czyli wadę utrwaloną w chwili wyzwolenia migawki, na przykład ostrość, która minęła się z głównym obiektem, a której żadna obróbka nie zniesie; wtedy uzasadnienie nazywa to ograniczenie, a kadr zostaje oznaczony jako niewart tej godziny. Mało który znajomy każe przerwać edycję zdjęcia, która wyraźnie sprawia ci przyjemność, a mentora, który by to zrobił, nie zawsze ma się pod ręką; flaga umieszcza tę decyzję w każdej krytyce. Tę flagę omawia lekcja Koniec edytowania.
Trzecia to sama ocena: czy stawia zdjęcie z wadą niżej niż zdjęcie bez wady? W październiku 2026 roku oceniliśmy 42 zdjęcia z etykietowanych zestawów testowych, na których sprawdzamy każdą nową wersję FinalFrame: 16 ze znaną wadą (15 z nich z problemem ostrości) i 26 bez wady. W 412 z 416 par zdjęcia bez wady ze zdjęciem z wadą (99%) FinalFrame wyżej ocenił zdjęcie bez wady; zdjęcia bez wady uzyskały średnio 7,0, a zdjęcia z wadą 5,4.
Na tych samych zdjęciach GPT-6.1 Sol przy niskim poziomie wysiłku, który dostał tylko zdjęcie i krótką prośbę o krytykę i ocenę od 1 do 10 przez API OpenAI (nie przez aplikację ChatGPT), dał średnio 7,7 zdjęciom bez wady i 6,7 zdjęciom z wadą (7,7 i 6,6 przy wysokim poziomie wysiłku): około 1 punktu różnicy między grupami, tam gdzie FinalFrame dał 1,6. Metoda, prompt i oceny każdego zdjęcia: jak testowaliśmy (po angielsku).
Sam model to sprawny model, który dostał kilka zdań instrukcji; postaw obok niego FinalFrame, a zobaczysz, co buduje się wokół modelu, a nie który model jest lepszy. Wokół modelu powstaje krytyka pomyślana jako punkt odniesienia: ocena, która spada, gdy zdjęcie ma wadę, jeden nazwany problem, werdykt, czy dalsza edycja jest warta wysiłku, czy kadr wymaga powtórzenia zdjęcia, zmiana, która najbardziej podniosłaby ocenę, oraz wartości suwaków na następną edycję w wybranym trybie. Dwa zdjęcia poniżej pokazują, gdzie odpowiedź samego modelu i jej ocena mogą się rozjechać.
Dwa ze zdjęć z wadą: co napisał każdy z nich i jaką dał ocenę
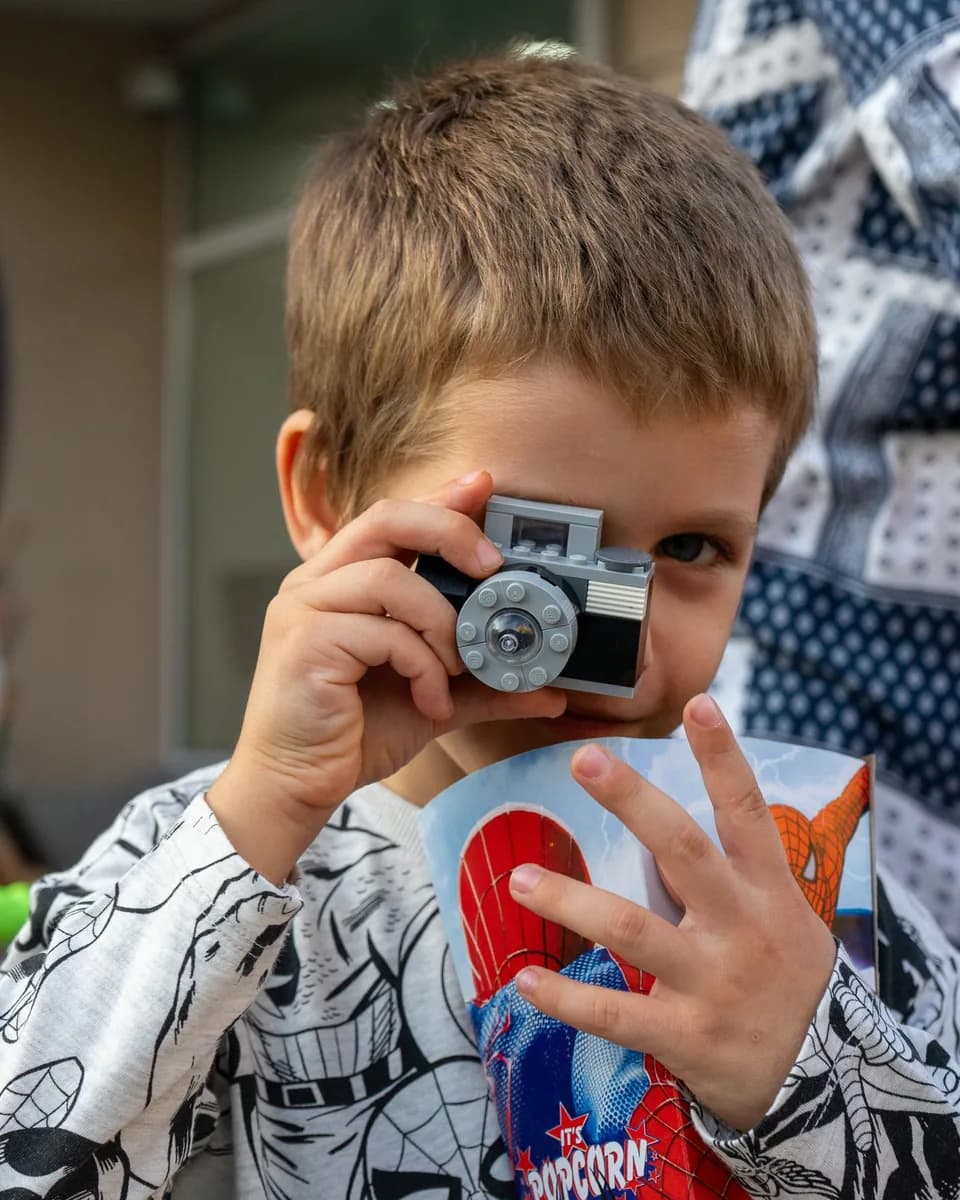
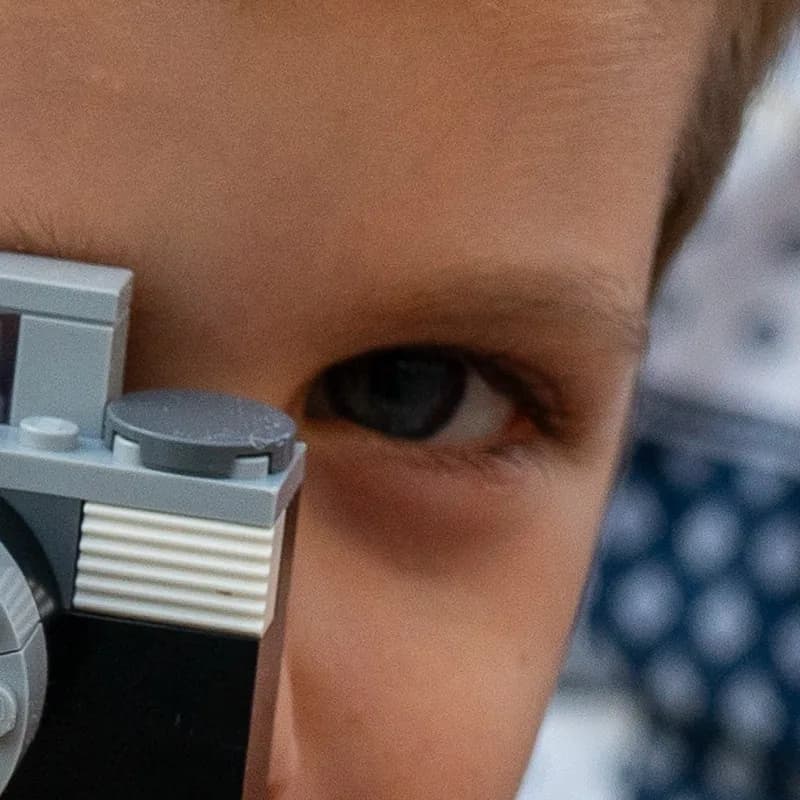
Oko z bliska, z tego samego pliku.
Sam GPT-6.1 Sol (API OpenAI, niski poziom wysiłku): 7,8/10. FinalFrame (tryb Czysty & naturalny): 5,5/10. Po jednym odczycie, październik 2026.
GPT-6.1 Sol (API OpenAI, niski poziom wysiłku; przetłumaczone z angielskiego)
7,8/10
GPT-6.1 Sol: „Ostrość jest dobra tam, gdzie trzeba, z przyjemnym detalem we włosach, oku i dłoniach”. Największy problem według modelu: „Najbardziej ogranicza je rozpraszająca postać w tle po prawej”.
FinalFrame (przetłumaczone z angielskiego)
5,5/10
FinalFrame: „jedyne widoczne oko musi udźwignąć cały portret, a nie jest wystarczająco ostre jak na czysty kadr do portfolio”. I jego werdykt: „Nie poświęcałbym już dużo więcej czasu na edycję tej wersji; pomysł jest wart powtórzenia zdjęcia z idealnie ostrym okiem”.
Sam model pochwalił ostrość i dał 7,8. FinalFrame wskazał miękkie oko jako ograniczenie, dał 5,5 i zalecił powtórzenie zdjęcia zamiast dalszej edycji: jego słowa i jego liczba mówią to samo.
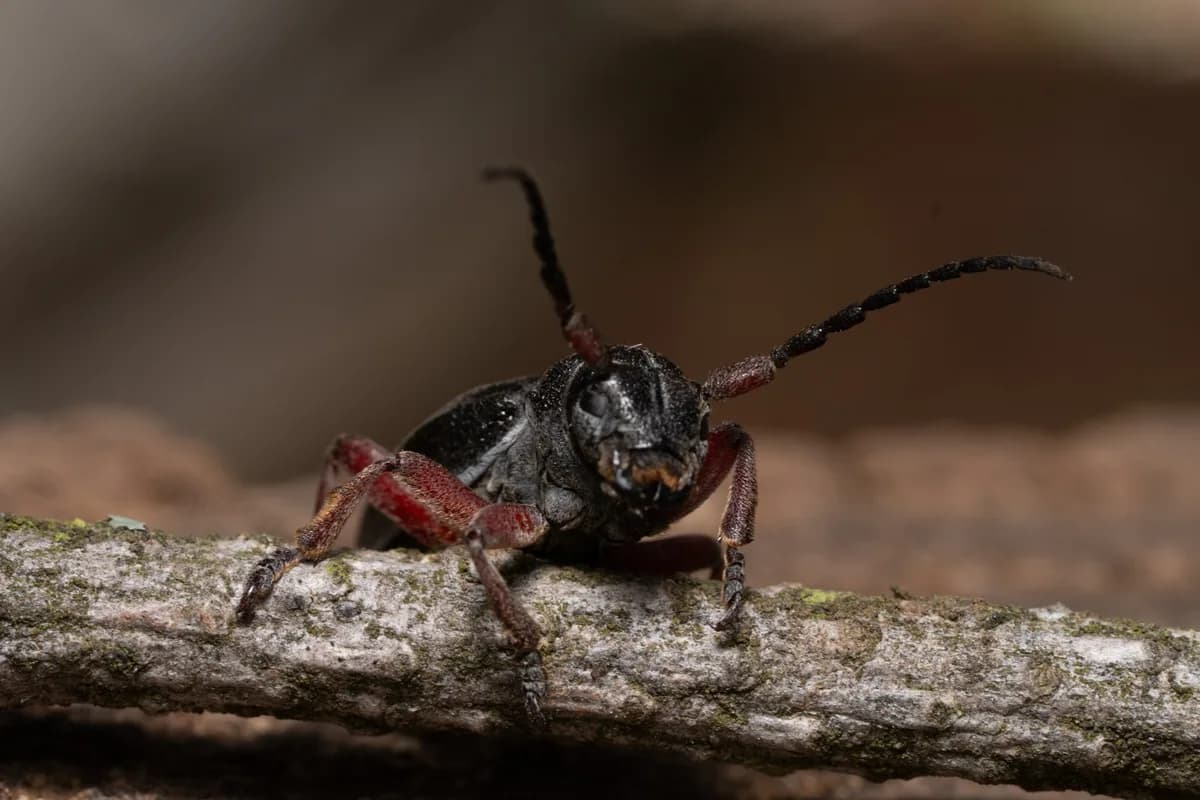
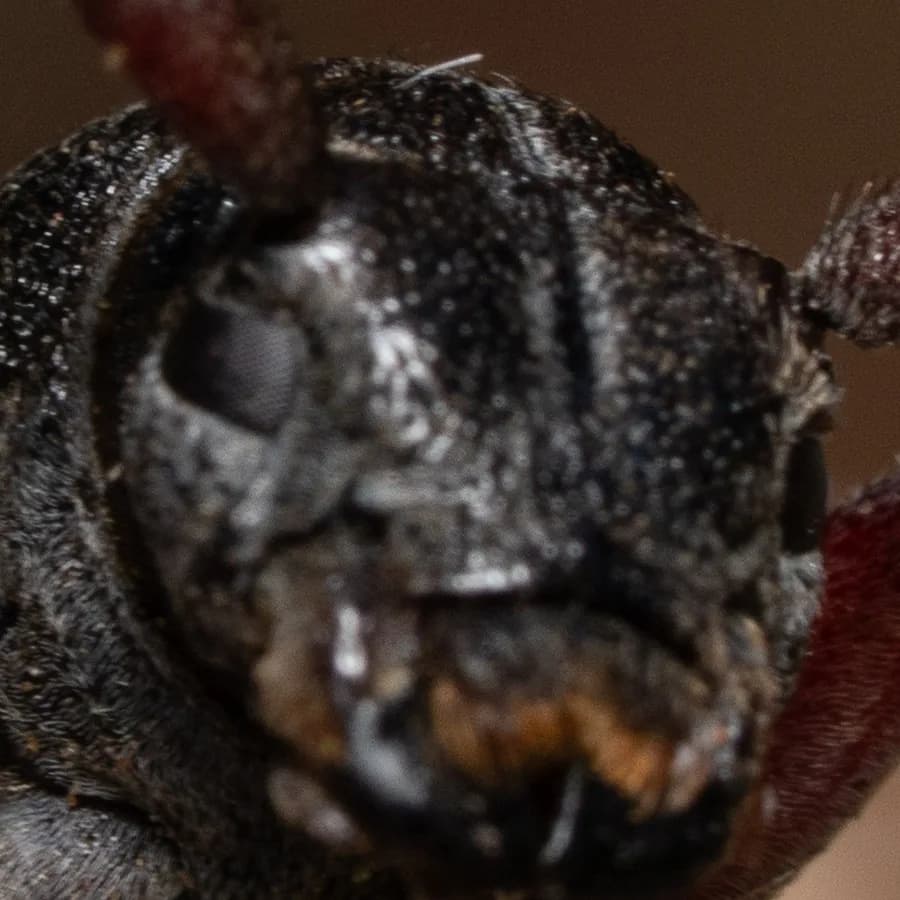
Oko z bliska, z tego samego pliku.
Sam GPT-6.1 Sol (API OpenAI, niski poziom wysiłku): 7,3/10. FinalFrame (tryb Czysty & naturalny): 5,6/10. Po jednym odczycie, październik 2026.
GPT-6.1 Sol (API OpenAI, niski poziom wysiłku; przetłumaczone z angielskiego)
7,3/10
GPT-6.1 Sol: „Najbardziej ogranicza je brak wyraźnego detalu wokół oczu i twarzy. To naturalne punkty skupienia uwagi, ale wyglądają na lekko miękkie…”
FinalFrame (przetłumaczone z angielskiego)
5,6/10
FinalFrame: „obszar twarzy/oka nie jest odwzorowany z wystarczającą precyzją”. I jego werdykt: „wyostrzanie i lokalny kontrast nie zamienią tego w ostry kadr do portfolio”.
Tu oba wskazały miękką głowę. Sam model, który wcześniej nazwał ostrość zabawkowego aparatu dobrą, ocenił to zdjęcie tylko o pół punktu niżej: 7,3 wobec 7,8. Ocena 5,6 od FinalFrame mówi to samo, co jego słowa, i to, że wyostrzanie tego nie naprawi.
Wypróbuj to na zdjęciu, o którym masz już własne zdanie: jeden nazwany problem, tak albo nie w sprawie tego, czy dalsza edycja jest warta wysiłku, i uzasadnienie, gdy każe przestać. Potem porównaj to z własną oceną.
Skrytykuj zdjęcieTa sama prośba w aplikacji ChatGPT
Powyższy test szedł przez API OpenAI. Większość ludzi pyta jednak w aplikacji ChatGPT, często z wcześniejszymi czatami i Pamięcią w tle. Wpisaliśmy więc tę samą prośbę ręcznie w aplikacji, na płatnym koncie z włączoną Pamięcią, używając modelu i ustawienia, z którymi aplikacja się otworzyła (GPT-6, Medium). Zapytaliśmy o 2 przykładowe zdjęcia powyżej, wybrane dlatego, że ocena modelu z API była jedną z najdalszych od naszej, oraz o 1 zdjęcie bez wady z tego samego zestawu, każde 3 razy, za każdym razem w nowym czacie.
Oceny aplikacji prawie się nie zmieniały z czatu na czat: 7,6, 7,6 i 7,8 dla zdjęcia bez wady; 7,2, 7,2 i 7,1 dla zabawkowego aparatu; 7,2, 7,4 i 7,2 dla chrząszcza. W każdej z 3 rund aplikacja oceniła zdjęcie bez wady wyżej niż oba zdjęcia z wadą, o 0,2 do 0,7 punktu. Żadna z 3 odpowiedzi o zabawkowym aparacie, czyli zdjęciu, na którym ostrość minęła oko, nie zauważyła miękkiego oka: 2 nazwały ostrość dobrą („Ostrość jest dość wyraźna”, przetłumaczone z angielskiego), trzecia pochwaliła detal we włosach, dłoniach i zabawkowym aparacie, czyli tam, gdzie padła ostrość, a wszystkie 3 winiły bałagan wizualny. Przy chrząszczu słowa zmieniały się bardziej niż liczby: 2 odpowiedzi wskazały miękką ostrość na głowie, a trzecia inny problem, „Twarz chrząszcza jest za ciemna” (przetłumaczone z angielskiego), i zasugerowała rozjaśnienie cieni; ocena i tak pozostała między 7,2 a 7,4.
Ponieważ te 2 przykłady wybrano ze względu na duże pomyłki, dodaliśmy 2 zdjęcia, które takie nie były: portret osła z naszego własnego zestawu kalibracyjnego, ze zwyczajną wadą (płaskim, jasnym światłem i prawie prześwietlonym niebem), oraz drugie zdjęcie bez wady, panoramę zachodu słońca, po 3 czaty na każde. Przy ośle aplikacja w każdym z 3 czatów wskazała inny główny problem: światło, potem pustą przestrzeń, potem głowę osła na tle drzew za nim; każdy z nich to trafna uwaga o tym zdjęciu, 2 z nich pokrywają się z oceną naszego założyciela, ale za każdym razem był to inny problem. FinalFrame, uruchomiony 3 razy na tym samym pliku, za każdym razem wskazał jasne niebo, które przyciąga uwagę bardziej niż pysk, za każdym razem dał 7,0 i za każdym razem podał ten sam plan edycji. Przy panoramie 3 odpowiedzi aplikacji i 3 przebiegi FinalFrame wskazały ciemny pierwszy plan. Na tych 2 zdjęciach oceny aplikacji mieściły się w granicach pół punktu od ocen FinalFrame; duże różnice przy zabawkowym aparacie i chrząszczu dotyczyły 2 zdjęć wybranych ze względu na duże pomyłki.
Przez API GPT-6.1 Sol ocenił pierwsze 3 zdjęcia na 8,2, 7,8 i 7,3 przy niskim poziomie wysiłku. Przebieg w aplikacji różni się od tego nie tylko Pamięcią: to inny model (GPT-6, a nie GPT-6.1 Sol), inne ustawienie wysiłku i wszystko, co aplikacja dodaje do czatu. Było to jedno konto, założyciela, z włączoną Pamięcią, więc wcześniejsze czaty mogły wpłynąć na późniejsze. Pokazuje to więc, co dostajesz od ChatGPT, kiedy używasz go normalnie, a nie to, jak bardzo sama Pamięć przesuwa ocenę. Oceny są na stronie jak testowaliśmy (po angielsku).
Trzy sposoby na krytykę zdjęcia
Każdy wiersz ma wyjątki. Kolumna chatbota podsumowuje to, co fotografowie i jeden zespół badawczy opublikowali między listopadem 2025 a sierpniem 2026 roku, czyli pojedyncze doświadczenia, a nie kontrolowany test; chatboty często się zmieniają. Nasze własne testy samego modelu, przez API OpenAI i ręcznie w aplikacji ChatGPT, są opisane przed tabelą i nie wchodzą w skład tej kolumny.
| Chatbot pytany doraźnie | FinalFrame | Ludzki krytyk | |
|---|---|---|---|
| Podstawy techniczne | Dobrze oceniony przez jednego testującego na jego własnych, gotowych kadrach; niesprawdzony na zdjęciu ze znaną wadą (TechRadar, gru 2025) | Zmierzone, wrz 2026, na wcześniejszej wersji: miękkość wychwycona w 75 z 80 odczytów wyraźnie miękkich zdjęć, 0 fałszywych alarmów w 100 odczytach ostrych; odczyt z zapisanej kopii twojego zdjęcia, a nie z oryginalnego pliku, a sprawdzenie ostrości na kluczowym detalu odbywa się jako osobny krok | Mocny; mentor może sprawdzić cały plik w 100% |
| Zamiar i świadome łamanie reguł | Ślepy, dopóki mu się nie powie (Venture Photography, lis 2025) | Przyjmuje twój cel jako wybrany tryb, jeden z 6, i ocenia względem niego; poza tym nie zna zamiaru, mówi o tym i pozwala oznaczyć nazwany problem jako niepasujący do twojego zdjęcia | To, co robi najlepiej |
| To samo zdjęcie, odczytane ponownie | Niezmierzone w opublikowanych tekstach, na których opiera się ta kolumna; odpowiedź zmienia się zależnie od tego, jak pytasz (TechRadar, gru 2025) | Mierzone w każdym pełnym przebiegu testów; paź 2026, 77 krytyk odczytanych 3 razy: nigdy więcej niż 0,4 różnicy między 3 odczytami, ten sam Wynik FinalFrame we wszystkich 3 dla 47; ta sama litera poziomu dla 71 | Może się wahać ze zmęczeniem, nastrojem i kolejnością zgłoszeń, dlatego salony powołują jury |
| Co rozstrzyga | Komentuje niemal każdy aspekt, w testach preprintu z 2026 roku; bez stałego werdyktu (arXiv:2606.29689) | Jeden problem ze stałej listy; flaga zatrzymania z uzasadnieniem; werdykt „warto” albo „nie warto” | To, co dla niego najważniejsze; dobry krytyk powie, kiedy kadr jest skończony albo niewart więcej czasu |
| Szybkość i dostępność | Od sekund do minut, o każdej porze | Około minuty, o każdej porze, z opisanym wyżej pomiarem wykonanym najpierw | Godziny na forum; tydzień lub dłużej na wieczór w klubie albo mentora |
Kolumnę FinalFrame czytaj jako model otoczony procesem pomiaru. Prawą kolumnę czytaj jako tę, dla której przygotowujesz fotografię.
Gdzie ludzki krytyk wciąż wygrywa
Zamiar. Każde źródło na tej stronie dochodzi do tego miejsca. Venture Photography, szkoła warsztatów, we wpisie z listopada 2025 roku (podpis: sengmah): „AI może ocenić tylko to, co widzi, a nie to, czy osiągnięto zamierzony cel artystyczny”. (Venture Photography, 24 lis 2025) Geoff Harris z Amateur Photographer pokazał ChatGPT kadr Henriego Cartier-Bressona w listopadzie 2025 roku i dostał listę ulepszeń, z których jedno, jak napisał, „sprawiłoby, że HCB przewróciłby się w grobie”. (Amateur Photographer, 17 lis 2025) Ludzki krytyk, który cię zna albo po prostu pyta, o co ci chodziło, czyta przechylony horyzont jako pomysł. Model czyta go jako przechylony horyzont; często tak samo sędzia salonu, który widzi obraz bez autora obok, który by go objaśnił.
Strona FinalFrame o ocenianiu mówi, że krytyka „nie zna twojego zamiaru” i że „przechylony horyzont może być całym pomysłem”. Bierze natomiast pod uwagę twój cel: wybierasz tryb (Czysty & naturalny, Nastrój & styl, Gotowy do druku, Gotowy na konkurs, Społecznościowy albo Dostawa do klienta), a zdjęcie jest oceniane względem niego. To samo zdjęcie, inny tryb, inna ocena, i właśnie o to chodzi. Etykietowany zestaw zawiera zdjęcia o świadomym stylu (oczy za okularami przeciwsłonecznymi albo rondem kapelusza, świadome rozmycie ruchu), żeby wybór stylistyczny nie został odczytany jako powód do powtórzenia zdjęcia; podana wyżej liczba 0 na 132 je obejmuje. Krytyka może mimo to powiedzieć, ile ten wybór kosztuje w wybranym trybie. Zasada czytania pochodzi ze strony o ocenianiu: gdy oznaczona wada była świadomą decyzją, nadaj jej mniejszą wagę. Więcej o tym, gdzie AI może się mylić, znajdziesz na stronie Jak działa Wynik FinalFrame.
Emocje i sala. Ludzki krytyk może powiedzieć, czy obraz go poruszył i jak wypada obok reszty twojej pracy. Poziomy FinalFrame są skalibrowane według sędziowania międzynarodowych salonów (wystaw PSA i FIAP) i to przydatny standard, by się z nim mierzyć; nadal jednak jest to standard, a nie juror. Wniosek Harrisa rozpozna większość fotografów: „żaden konkurs fotograficzny z prawdziwego zdarzenia nigdy nie zwolniłby jury i nie posadził na jego miejscu ChatGPT”. (Amateur Photographer)
Problem selektywności: co wykazał preprint z 2026 roku
Najbardziej bezpośrednim opublikowanym dowodem, jaki znaleźliśmy, jest preprint z czerwca 2026 roku autorstwa Sajjada Ghiasvanda i czterech współautorów, „Can MLLMs Critique Like Humans?”, w którym oceniono osiem modeli z otwartymi wagami oraz GPT-5.5 względem uszeregowanych ludzkich krytyk 1227 wpisów z r/photocritique. (arXiv:2606.29689, v2 31 sie 2026) Ważne są tu dwa ustalenia.
Po pierwsze, czołowe modele wygrały preferencje sędziów: w głównym wariancie wszyscy 4 sędziowie LLM „wolą krytyki czołowych modeli od ludzkich”. Ale zapytani, na ile każda krytyka modelu jest merytorycznie podobna do ludzkiej, sędziowie i 2 ludzkich anotatorów dali każdemu modelowi od 1,81 do 2,59 w 5-stopniowej skali, „blisko »w większości różne«”. (arXiv:2606.29689)
Po drugie, i to warto zapamiętać: „modele rozchodzą się w sposób, którego oceny nie ujawniają: obejmują niemal każdy aspekt estetyczny tam, gdzie ludzie są selektywni, i powtarzają się w krytykach jednego zdjęcia, nawet gdy dostają polecenie, by pisać tyle, ile człowiek”. Objąć każdy aspekt to nie to samo, co znaleźć każdy problem: autorzy ustalili też, że „ukrycie obrazu prawie nie zmienia” automatycznych miar podobieństwa, a zwykła miara „nagradza płynny, wyczerpujący styl krytyki zamiast selektywności i konkretności krytyki ludzkiej”. (arXiv:2606.29689) Mówiąc prosto: zostawiony sam sobie model komentuje prawie wszystko, a automatyczne miary z artykułu prawie się nie zmieniły, gdy model w ogóle nie widział zdjęcia. Dobry krytyk najpierw patrzy, a potem większość pomija.
Projekt FinalFrame odpowiada na obie połowy tego ustalenia, choć nie przeprowadziliśmy na nim testu z artykułu. Opisany wyżej pomiar wiąże odczyty techniczne z pikselami. Połowa dotycząca selektywności to wybór dydaktyczny starszy niż artykuł: krytyka nazywa jeden problem, wybrany według tego, ile kosztuje kadr w twoim trybie, i od niego zaczyna, żeby następna edycja miała jeden cel. Czy to ten problem, który wskazałoby się samemu, to uczciwe pytanie; przycisk „Nie pasuje do mojego zdjęcia” pod nim pozwala to zaznaczyć, gdy nie jest.
Spójność: trudna część i co zmierzyliśmy
Spójność to jedna z trudnych części każdej krytyki, ludzkiej czy AI. W 4-letnim badaniu na dużym konkursie win w USA sędziowie, którzy w jednej sesji dostali to samo wino 3 razy, często oceniali je różnie, niektórzy od brązu do złota (Hodgson, Journal of Wine Economics, 2008); nie znaleźliśmy takiego badania dotyczącego sędziów fotograficznych. Model też może odczytać to samo zdjęcie różnie, nasz również. Żadne opublikowane źródło, jakie znaleźliśmy, tego nie zmierzyło, ani dla chatbota, ani dla żadnej aplikacji do krytyki, więc ta sekcja dotyczy naszego; to także test, który możesz przeprowadzić na tym, czego używasz, również na nas: wyślij to samo zdjęcie 3 razy i porównaj. Strona FinalFrame o ocenianiu mówi, że „przy ponownej ocenie tego samego zdjęcia wynik może wyjść nieco inaczej”, i to nadal prawda. Zrobiliśmy tyle, że zmierzyliśmy, jak bardzo, a potem to ograniczyliśmy.
W przebiegu z października 2026 roku, 77 krytyk 73 fotografii, każda odczytana 3 razy, na zestawie pełnym przypadków granicznych: żadna nie przesunęła się o więcej niż 0,4 punktu między 3 odczytami, a 47 z 77 dostało ten sam Wynik FinalFrame we wszystkich 3; litera poziomu zgadzała się we wszystkich 3 w 71 z 77, werdykt „warto” albo „nie warto” w 73, a decyzja o zatrzymaniu w 75. Doszliśmy do tego, mierząc najpierw: w sierpniu 2026 roku, na 10 zdjęciach odczytanych po 5 razy, jedna zmiana w sposobie uruchamiania modelu zmniejszyła o połowę medianę rozrzutu między najwyższym a najniższym wynikiem potencjalnym zdjęcia (jak daleko może je zaprowadzić edycja), z 0,8 do 0,4 punktu. Rozrzut jest teraz raportowany w każdym pełnym przebiegu testów; podane wyżej liczby z października pochodzą z jednego z nich.
Jedno ograniczenie. Nazwany problem powtarza się mniej ściśle niż ocena: w przebiegu z września 2026 roku na wcześniejszej wersji, 71 zdjęć odczytanych po 5 razy, ten sam problem był wiodący w co najmniej 4 z 5 odczytów dla 59 z nich, a we wszystkich 5 dla 40, więc ponowny odczyt może zacząć od innego problemu.
Jak korzystać z obu
Traktuj je jako różne instrumenty, a nie rywali. Odczytu AI używaj w pętli edycji: popraw jedną rzecz, którą nazywa, wgraj nową wersję, sprawdź, czy poprawka zadziałała, i przestań, gdy flaga zatrzymania powie dlaczego. Przy nowej wersji krytyka mówi, czy wcześniejszy problem jest rozwiązany, częściowo rozwiązany, czy nadal jest, a zmiana oceny o 0,1 lub mniej jest opisana jako mieszcząca się w granicach normalnej zmienności, a nie przedstawiana jako postęp.
Ludzi pytaj tam, gdzie AI sama przyznała, że jest ślepa. Zanieś gotową wersję na wieczór krytyki w klubie albo na forum takie jak r/photocritique i zadaj jedno pytanie: czy to zdjęcie mówi to, co chcę nim powiedzieć? Dostaniesz odczytanie emocjonalne, odczytanie kontekstu, a czasem „to zdjęcie mnie nie obchodzi”, czego żaden model ci nie powie. Gdy oba źródła nie zgadzają się co do wady technicznej, rozstrzyga plik, w 100% i w rozmiarze, w jakim będzie pokazany; gdy nie zgadzają się co do tego, czy kadr działa, człowiek odpowiada na pytanie, które się liczy.
Jeśli już potrafisz nazwać objaw (płaski kadr, białe niebo, miękkie oko), przejdź od razu do indeksu diagnoz, który kieruje każdy z nich do właściwej lekcji. A jeśli kadr jest ograniczony ujęciem, żadna edycja tego ograniczenia nie zniesie: pytanie brzmi wtedy, czy kadr działa taki, jaki jest, czy zasługuje na powtórzenie zdjęcia. Jeśli chcesz poznać metodę, którą stosuje krytyka, a nie porównanie tego, kto ją wystawia, przeczytaj jak krytycznie ocenić zdjęcie.
Najczęstsze pytania o krytykę zdjęć przez AI
- Czy ChatGPT może krytykować moje zdjęcia?
- Może, a ze szczegółowym promptem radzi sobie lepiej. Peter Fenech z TechRadar stwierdził, że „uwagi najpewniej pozostaną ogólne”, o ile nie opisał swojego zamiaru, i nadal podejrzewał, że duża ich część jest „wzięta z gotowych odpowiedzi”. (TechRadar, gru 2025; Amateur Photographer, lis 2025) OpenAI podaje, że gdy Pamięć jest włączona, ChatGPT może zapamiętywać szczegóły z twoich wcześniejszych czatów i używać ich do personalizowania odpowiedzi (OpenAI Help Center, „Memory in ChatGPT”, dostęp: październik 2026). Jeśli chcesz uwag o zdjęciu, których nie kształtuje to, co ChatGPT o tobie wie, otwórz czat tymczasowy i, jeśli jest taka opcja, wybierz Unpersonalized (bez personalizacji). Żaden z dwóch artykułów w magazynach nie sprawdził go na zdjęciu ze znaną wadą i żaden nie zmierzył, czy dwa razy odczytuje to samo zdjęcie tak samo. To, co dodaje FinalFrame, leży poza promptem: sprawdzenie ostrości na detalu, który się liczy, wykonywane jako osobny krok, odczyty sprawdzone na zdjęciach o znanych wadach i zmierzona odpowiedź na pytanie, jak bardzo przesuwa się powtórny odczyt.
- Czy krytyka zdjęć przez AI jest trafna?
- To zależy od tego, co zmierzono, więc pytaj o liczby. Liczby FinalFrame z jego własnych etykietowanych przebiegów testów: miękkość wychwycona w 75 z 80 odczytów wyraźnie miękkich kadrów i fałszywie w 0 ze 100 odczytów ostrych (wrzesień 2026, na wcześniejszej wersji), a w 77 krytykach 73 fotografii, każdej odczytanej 3 razy, ten sam poziom we wszystkich 3 odczytach dla 71 (październik 2026). Jeśli chodzi o zamiar, zna wybrany przez ciebie tryb, czyli standard, względem którego ocenia. Nie może natomiast wiedzieć, że jakiś wybór w kadrze był świadomy, więc niebo w high-key albo celowe przechylenie może zostać odczytane jako wada; nadaj tej uwadze mniejszą wagę. Jego Regulamin nazywa to, co generuje, „opinią algorytmiczną”, a nie oceną eksperta. Traktuj go jak zmierzoną drugą opinię względem nazwanego standardu.
- Czy uwagi AI sprawią, że moje zdjęcia będą sztampowe?
- Mogą, jeśli wdrożysz wszystko, co mówi ogólny model: preprint z 2026 roku wykazał, że modele „obejmują niemal każdy aspekt estetyczny tam, gdzie ludzie są selektywni”, a ich podobieństwo do ludzkich krytyk odzwierciedla „raczej stały styl krytyki niż obserwacje dotyczące konkretnego obrazu” (arXiv:2606.29689); poprawianie 10 uwag naraz to sposób, w jaki wyrazisty kadr staje się kadrem tylko poprawnym. FinalFrame nazywa jeden problem na krytykę, wybrany według tego, ile kosztuje kadr w wybranym trybie. Popraw go, wgraj nową wersję i sprawdź, czy poprawka zadziałała. Jeśli to, co nazywa, jest wyborem dokonanym celowo, zostaw go.
- Czy jest darmowa krytyka zdjęć przez AI?
- Tak. Strona główna FinalFrame oferuje darmową krytykę demonstracyjną bez konta (poziom, oceny, nazwane wąskie gardło i werdykt; pełne korekty dla edytora wymagają darmowego konta), a darmowe konto dostaje 3 krytyki miesięcznie, po 1 kredycie każda, oraz jednorazowo do 2 kredytów bonusowych za wgranie edytowanej wersji.
Zobacz zmierzoną krytykę kadru, który dobrze znasz
Wgraj fotografię, o której masz już własne zdanie. FinalFrame odczytuje jej ostrość i to, czy ma ograniczenie ujęcia, nazywa jeden problem, który najwięcej ją kosztuje, i mówi, czy dalsza edycja jest warta wysiłku, a gdy każe przestać, mówi dlaczego. Wartości suwaków dla tej jednej poprawki są dostępne z darmowym kontem. Porównaj to z własną opinią; rozbieżności w obu kierunkach to najcenniejsza część.
Skrytykuj zdjęcieChatGPT i OpenAI są znakami towarowymi OpenAI. FinalFrame nie jest powiązany z OpenAI ani przez OpenAI popierany.