KI- oder menschliche Fotokritik: was ein Chatbot, ein Kritikwerkzeug und ein Mensch jeweils erkennen
Eine KI-Fotokritik ist so gut wie das, was um das Modell herum gebaut und gemessen wird. Ein allgemeiner Chatbot beantwortet die Frage, die du eingetippt hast. FinalFrame misst zuerst das Foto, stellt ihm jedes Mal dieselben festen Fragen und prüft seine Analysen an Fotos, deren Fehler schon bekannt sind. Was du bekommst, ist eine gemessene Zweitmeinung gegen einen Maßstab, den du wählst: ein benanntes Problem, die Reglerwerte dafür in deinem Bearbeitungsprogramm und eine Einschätzung, ob sich weitere Bearbeitung lohnt, damit die nächste Bearbeitung eine Richtung hat. Bei der Absicht und bei der Frage, ob das Bild ankommt, liegt ein menschlicher Kritiker noch vorn.
Wenn du schon einmal ein Foto in einen Chatbot eingefügt und gefragt hast „Was hältst du davon?“, erkennst du vielleicht die Antwort wieder, die die Fotografen beschreiben, die ChatGPT Ende 2025 getestet haben: ein warmer Einstieg, eine Liste dessen, was funktioniert, und ein oder zwei sanfte Vorschläge. Eine Kritik in dem Sinn, in dem diese Seite das Wort verwendet, stellt dem Foto jedes Mal feste Fragen, misst seinen technischen Zustand, benennt ein Problem und entscheidet, was als Nächstes zu tun ist.
Wenn du gerade überlegst, wohin du das nächste Foto schickst, findest du hier die gemessenen Zahlen von FinalFrame mit Datum, wie die Antwort eines Chatbots auf dieselbe Anfrage aussieht und wo ein Mensch noch besser ist.
Was eine KI-Fotokritik ist und worin sie sich von einer Frage an einen Chatbot unterscheidet
Ein allgemeiner Chatbot beantwortet den Prompt, den er bekommt. Gib ihm ein Foto und eine vage Frage, und er sucht sich aus, worüber er spricht. Peter Fenech von TechRadar, früher Redakteur von Digital Photographer, hat genau diesen Test im Dezember 2025 gemacht und die erste Runde in einem Satz zusammengefasst: „Bei einem allgemeinen Prompt bleibt das Feedback wahrscheinlich allgemein.“ Längere Prompts, die seine Absicht benannten, brachten ihm gezieltere Antworten. (TechRadar, 31. Dez. 2025)
Ein besserer Prompt bringt dir eine besser geformte Antwort; genau das hat Fenech festgestellt. Was FinalFrame hinzufügt, steht nicht im Prompt. Es misst das Foto, bevor die Kritik geschrieben wird: Es liest die Kameradaten in der Datei, und es prüft den Fokus auf dem Detail, auf das es ankommt, aus der Nähe, als eigenen Schritt. Danach beantwortet jede Kritik dieselben festen Fragen in fester Reihenfolge, sodass das, was die Analyse abdeckt, nicht davon abhängt, wie gut du gefragt hast. FinalFrame läuft auf einem OpenAI-Modell, wie es in seinen Nutzungsbedingungen steht. Das Modell ist ein Teil des Ergebnisses. Das Messen, bevor es schreibt, und das Prüfen dessen, was es schreibt, an Fotos, deren Fehler schon bekannt sind, sind der Rest; die Zahlen stehen im nächsten Abschnitt.
Drei Fragen zählen hier am meisten. Ist das Bild dort scharf, wo es darauf ankommt, und braucht das Problem eine Neuaufnahme, oder lässt es sich am Schreibtisch lösen: die 2 Analysen, die wir am härtesten testen. Welches eine Problem kostet das Bild am meisten, benannt aus einer festen Liste und danach ausgewählt, was es das Bild in dem Kontext kostet, den du wählst: dem Maßstab, an dem du gemessen werden willst (Subtil & natürlich, Stimmung & Stil, Druckfertig, Wettbewerbsbereit, Social oder Auftragsarbeit). Und solltest du weiterbearbeiten: ein Stoppsignal mit seiner Begründung, dazu eine Einschätzung zu „Lohnenswert“, die Ja oder Nein lautet. Mit der Antwort kommt, was du verstellen sollst: Reglerwerte für dieses eine Problem, in dem Bearbeitungsprogramm, das du in deinen Einstellungen gewählt hast (Lightroom, Capture One, Photoshop und andere); lade die bearbeitete Version hoch, und die nächste Kritik sagt, ob dieses Problem behoben, teilweise behoben oder noch vorhanden ist. Diese Fragen kannst du auch in einen Chatbot tippen; was du nicht tippen kannst, ist die Fokusprüfung hinter der ersten, das Testen an Fotos mit bekannten Fehlern, über das der nächste Abschnitt berichtet, oder eine Messung dessen, was deine Bearbeitung verändert hat: Jede neue Version wird für sich bewertet und dann an der vorherigen gemessen, und wenn du dieselbe Datei erneut hochlädst, wird sie als dasselbe Bild markiert.
Wo KI-Kritik stark ist und woher wir das wissen
Zuerst die technische Analyse. Fenechs abschließende Einschätzung war, dass „KI sehr gut in technischen Analysen“ ist, aber er hat seine eigenen fertigen Bilder getestet, und keiner der Berichte, die wir gefunden haben, hat ein Foto mit einem bekannten Fehler ausprobiert. (TechRadar; Amateur Photographer, Nov. 2025; Venture Photography, Nov. 2025) Also haben wir unsere getestet. In unserem letzten vollständigen Fokustest, im September 2026 mit einer früheren Version der Kritik, wurden 16 deutlich unscharfe Fotos je 5-mal analysiert: Die Kritik erkannte die Unschärfe in 75 der 80 Analysen, und in 100 Analysen von 20 scharfen Fotos bezeichnete sie kein einziges als unscharf. In einem Lauf im Oktober 2026, mit Dateien, die ihre Kameradaten enthielten, erkannte sie eine echte Grenze aus der Aufnahme in allen 45 Analysen der 15 Fotos, die eine hatten, und verlangte in 132 Analysen von 44 Fotos, bei denen eine Stilentscheidung oder ein behebbarer Fehler nicht als solche Grenze gelesen werden darf, 0-mal fälschlich eine Neuaufnahme. Das sind unsere eigenen Fotos und Labels, bewusst schwierig gewählt; deine Fotos sind nicht in diesem Set.
Als Zweites der Stopp. Bei einer ersten Kritik prüft FinalFrame eine feste Reihe von Stoppbedingungen, und es kann früh Stopp sagen, wenn das Bild eine Grenze aus der Aufnahme trägt, einen Fehler, der im Moment der Auslösung festgelegt wurde, etwa ein Fokus, der das Motiv verfehlt hat, und den keine Bearbeitung aufheben kann; dann benennt die Begründung diese Grenze, und das Bild wird als die Stunde Arbeit nicht wert markiert. Wenige Freunde sagen dir, du sollst aufhören, ein Foto zu bearbeiten, an dem du sichtlich Freude hast, und der Mentor, der es täte, ist nicht immer greifbar; das Signal bringt diese Einschätzung in jede Kritik. Die Lektion dazu, wie du dieses Signal liest, ist Bearbeitungsstopp.
Als Drittes der Score selbst: Setzt er ein fehlerhaftes Foto unter ein einwandfreies? Im Oktober 2026 haben wir 42 Fotos aus den gelabelten Testsets bewertet, an denen wir jede neue Version von FinalFrame prüfen: 16 mit einem bekannten Fehler (15 davon ein Fokusproblem) und 26 ohne. In 412 der 416 Paarungen aus einem einwandfreien und einem fehlerhaften Foto (99 %) bewertete FinalFrame das einwandfreie Foto höher; einwandfreie Fotos kamen im Schnitt auf 7,0, fehlerhafte auf 5,4.
Bei denselben Fotos kam GPT-6.1 Sol mit Effort „low“, dem über die API von OpenAI (nicht die ChatGPT-App) nur das Foto und eine kurze Bitte um eine Kritik und einen Score von 1 bis 10 gegeben wurde, im Schnitt auf 7,7 für die einwandfreien und 6,7 für die fehlerhaften Fotos (7,7 und 6,6 mit Effort „high“): etwa 1 Punkt zwischen den Gruppen, während es bei FinalFrame 1,6 waren. Die Methode, der Prompt und die Scores jedes einzelnen Fotos: So haben wir getestet (auf Englisch).
Das reine Modell ist ein fähiges Modell, das ein paar Sätze Anweisung bekommt; stell FinalFrame daneben, und was du siehst, ist das, was um ein Modell herum gebaut ist, nicht, welches Modell besser ist. Was FinalFrame um das Modell herum baut, ist eine Kritik, die als Bezugspunkt dienen soll: ein Score, der sinkt, wenn das Foto einen Fehler hat, ein benanntes Problem, eine Einschätzung, ob sich weitere Bearbeitung lohnt oder das Bild eine Neuaufnahme braucht, die Änderung, die den Score am stärksten bewegen würde, und Reglerwerte für die nächste Bearbeitung in dem Kontext, den du gewählt hast. Die beiden Fotos unten zeigen, wo eine reine Modellantwort und ihr Score auseinanderfallen können.
Zwei der fehlerhaften Fotos: was jeder schrieb und welchen Score jeder vergab
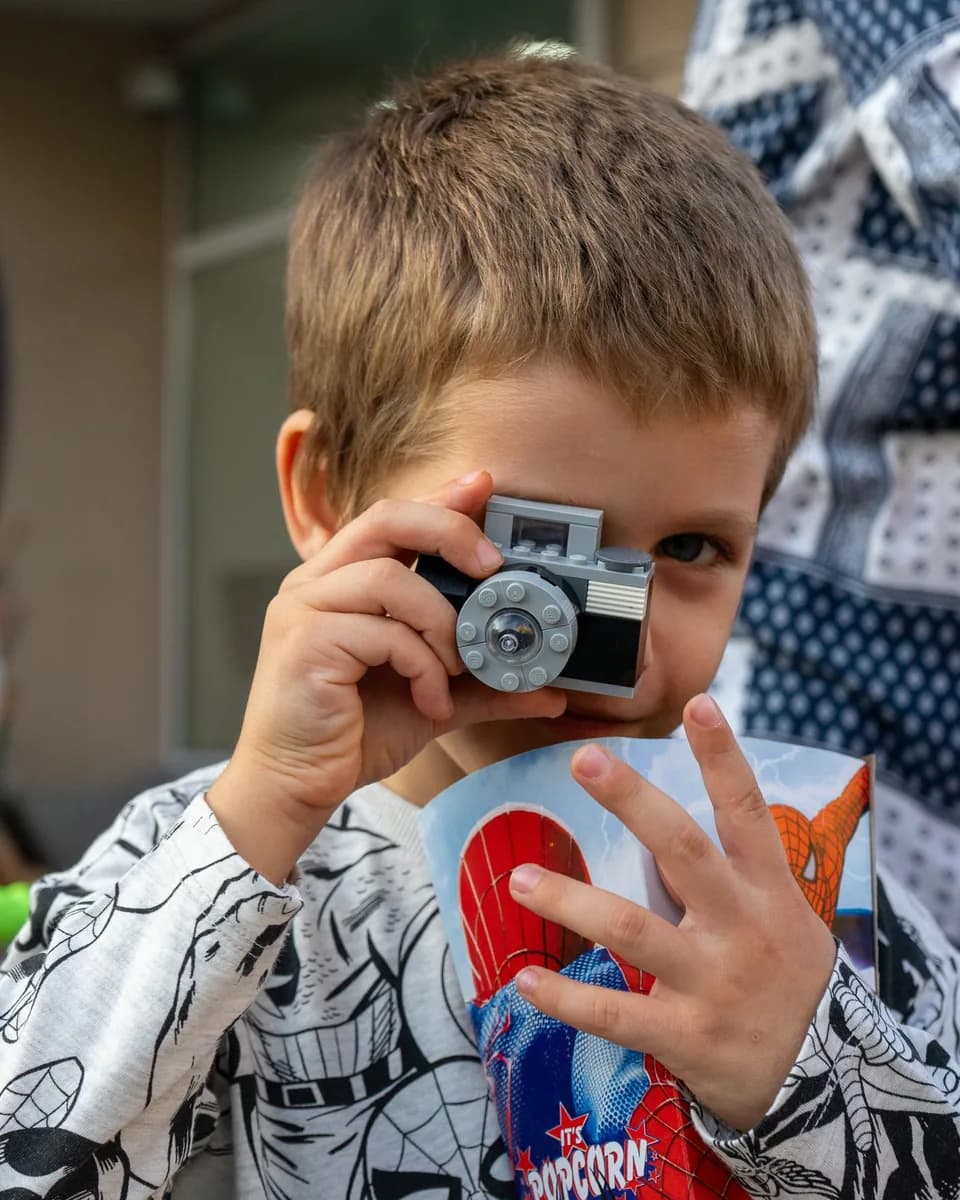
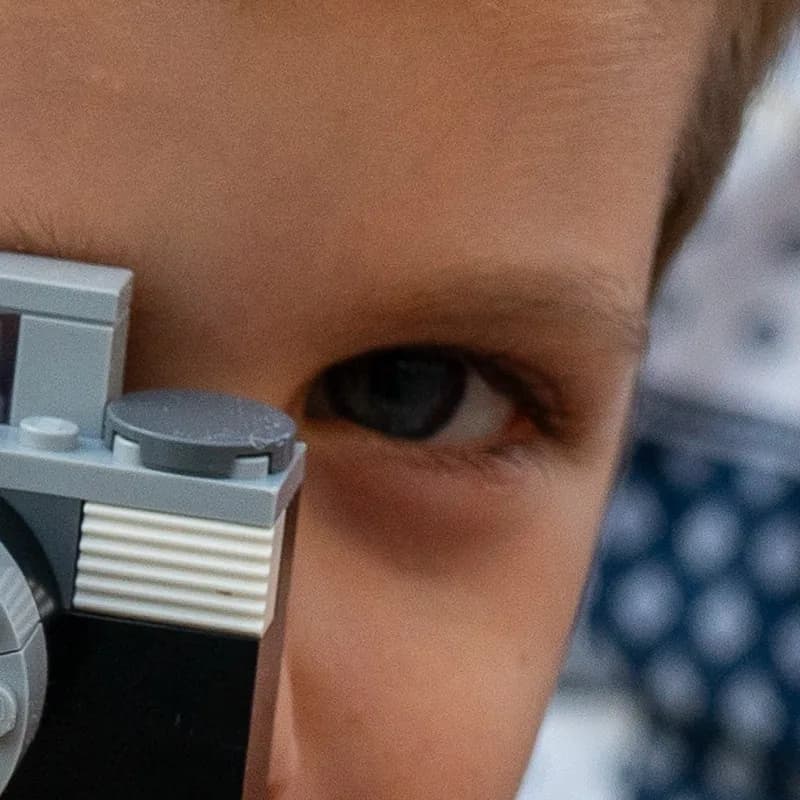
Das Auge in Nahaufnahme, aus derselben Datei.
Reines GPT-6.1 Sol (OpenAI-API, Effort „low“): 7,8/10. FinalFrame (Kontext „Subtil & natürlich“): 5,5/10. Je eine Analyse, Oktober 2026.
GPT-6.1 Sol (OpenAI-API, Effort „low“; aus dem Englischen übersetzt)
7,8/10
GPT-6.1 Sol: „Der Fokus sitzt gut, wo es darauf ankommt, mit ansprechenden Details in Haaren, Auge und Händen.“ Das größte Problem, das es nennt: „Was das Bild am meisten zurückhält, ist die ablenkende Figur im Hintergrund rechts.“
FinalFrame (aus dem Englischen übersetzt)
5,5/10
FinalFrame: „Das eine sichtbare Auge muss das ganze Porträt tragen, und es ist nicht scharf genug für ein sauberes Portfoliobild.“ Und sein Fazit: „Ich würde nicht mehr viel Zeit in die Bearbeitung dieser Version stecken; die Idee ist eine Neuaufnahme mit gestochen scharfem Auge wert.“
Das reine Modell lobte den Fokus und vergab 7,8. FinalFrame benannte das unscharfe Auge als die Grenze, vergab 5,5 und riet zur Neuaufnahme statt zum Weiterbearbeiten: Seine Worte und seine Zahl sagen dasselbe.
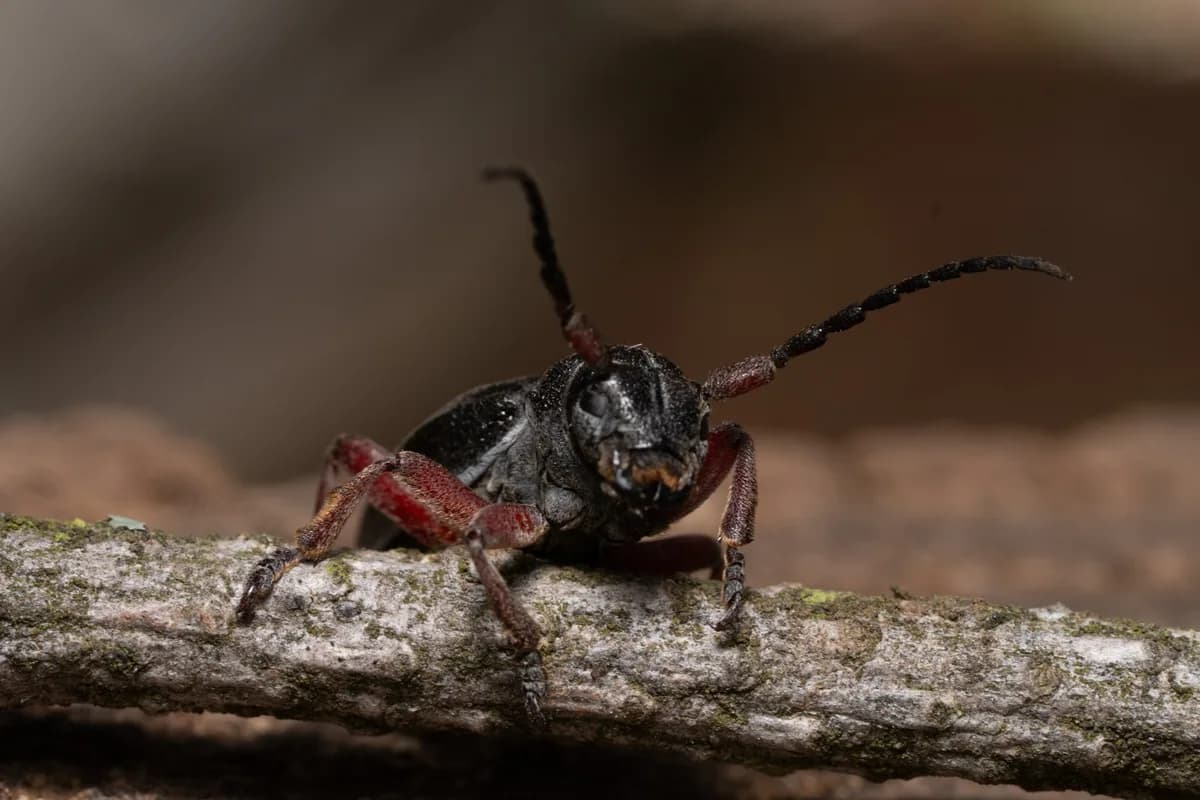
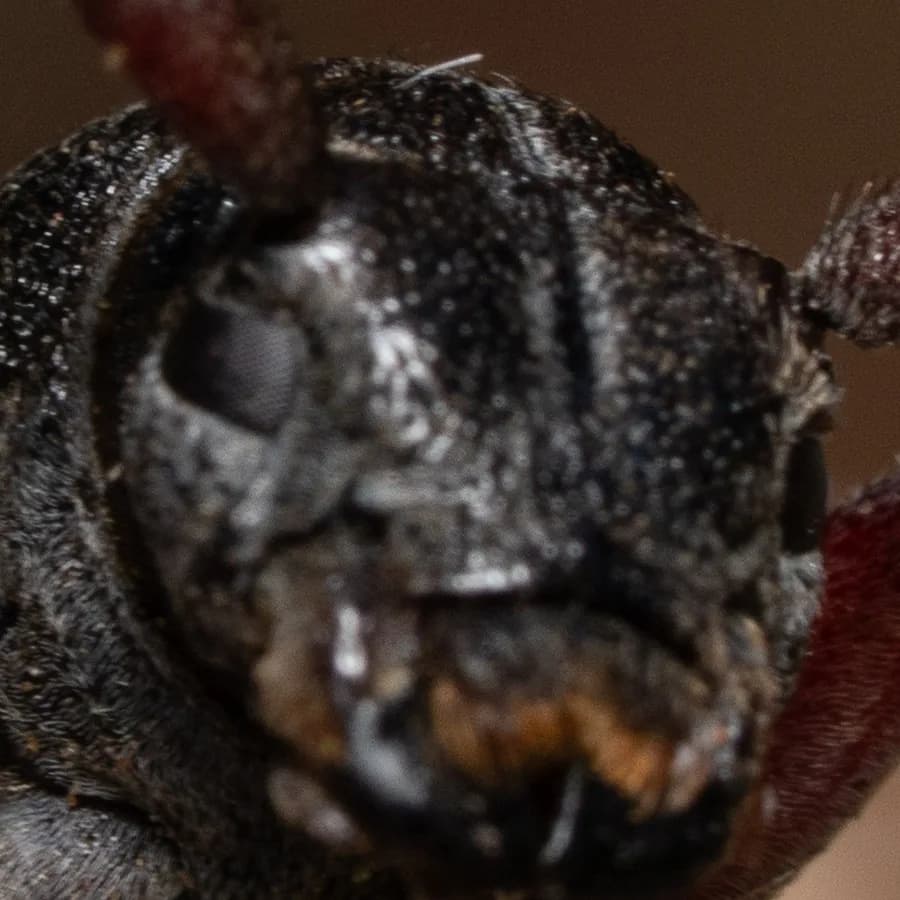
Das Auge in Nahaufnahme, aus derselben Datei.
Reines GPT-6.1 Sol (OpenAI-API, Effort „low“): 7,3/10. FinalFrame (Kontext „Subtil & natürlich“): 5,6/10. Je eine Analyse, Oktober 2026.
GPT-6.1 Sol (OpenAI-API, Effort „low“; aus dem Englischen übersetzt)
7,3/10
GPT-6.1 Sol: „Was das Bild am meisten zurückhält, ist der Mangel an knackigen Details um Augen und Gesicht. Das sind die natürlichen Blickpunkte, aber sie wirken leicht unscharf …“
FinalFrame (aus dem Englischen übersetzt)
5,6/10
FinalFrame: „Der Gesichts-/Augenbereich wird nicht präzise genug abgebildet.“ Und sein Fazit: „Schärfen und lokaler Kontrast werden daraus kein knackiges Portfoliostück machen.“
Hier benannten beide das unscharfe Gesicht. Das reine Modell, das den Fokus bei der Spielzeugkamera gut genannt hatte, bewertete dieses Foto nur einen halben Punkt niedriger: 7,3 gegenüber 7,8. Die 5,6 von FinalFrame sagt dasselbe wie seine Worte, und die sagen auch, dass Schärfen das nicht behebt.
Probier es an einem Foto aus, das du selbst schon beurteilt hast: ein benanntes Problem, ein Ja oder Nein dazu, ob sich weitere Bearbeitung lohnt, und die Begründung, wenn es Stopp sagt. Dann vergleiche es mit dem, was du gesagt hättest.
Foto kritisieren lassenDieselbe Anfrage in der ChatGPT-App
Der Test oben lief über die API von OpenAI. Die meisten fragen stattdessen in der ChatGPT-App, oft mit ihren früheren Chats und Memory im Hintergrund. Also haben wir dieselbe Anfrage von Hand in die App getippt, mit einem bezahlten Konto mit aktiviertem Memory, und dabei das Modell und die Einstellung verwendet, mit denen die App startete (GPT-6, Medium). Wir haben nach den 2 Beispielfotos oben gefragt, ausgewählt, weil der Score des API-Modells mit am weitesten von unserem entfernt lag, und nach 1 einwandfreien Foto aus demselben Set, je 3-mal, jedes Mal in einem neuen Chat.
Die Scores der App bewegten sich von einem Chat zum nächsten kaum: 7,6, 7,6 und 7,8 für das einwandfreie Foto, 7,2, 7,2 und 7,1 für die Spielzeugkamera, 7,2, 7,4 und 7,2 für den Käfer. In jeder der 3 Runden bewertete sie das einwandfreie Foto höher als beide fehlerhaften, um 0,2 bis 0,7 Punkte. Keine der 3 Antworten zur Spielzeugkamera, dem Foto, bei dem der Fokus das Auge verfehlt hatte, bemerkte das unscharfe Auge: 2 nannten den Fokus gut („Der Fokus ist recht scharf“, aus dem Englischen übersetzt), die dritte lobte die Details in Haaren, Händen und Spielzeugkamera, also genau dort, wo der Fokus lag, und alle 3 machten Unordnung verantwortlich. Beim Käfer bewegten sich ihre Worte stärker als ihre Zahlen: 2 Antworten nannten Unschärfe im Gesicht, und die dritte nannte ein anderes Problem, „Das Gesicht des Käfers ist zu dunkel“ (aus dem Englischen übersetzt), und schlug vor, die Schatten anzuheben; der Score blieb so oder so zwischen 7,2 und 7,4.
Weil diese 2 Beispiele wegen großer Fehleinschätzungen ausgewählt wurden, haben wir 2 Fotos hinzugenommen, bei denen das nicht so war: ein Eselporträt aus unserem eigenen Kalibrierungsset, mit einem gewöhnlichen Fehler (flaches, helles Licht und ein fast ausgefressener Himmel), und ein zweites einwandfreies Foto, ein Sonnenuntergangspanorama, je 3 Chats. Beim Esel nannte die App in jedem der 3 Chats ein anderes Hauptproblem: das Licht, dann den leeren Raum, dann den Kopf des Esels vor den Bäumen dahinter; jedes ein berechtigter Einwand zu diesem Foto, 2 davon auch in der eigenen Bewertung unseres Gründers, aber jedes Mal ein anderer. FinalFrame, 3-mal mit derselben Datei ausgeführt, nannte jedes Mal den hellen Himmel, der dem Gesicht den Rang abläuft, bewertete das Foto jedes Mal mit 7,0 und gab jedes Mal denselben Bearbeitungsplan. Beim Panorama zeigten die 3 Antworten der App und die 3 Läufe von FinalFrame alle auf den dunklen Vordergrund. Bei diesen 2 Fotos lagen die Scores der App innerhalb eines halben Punkts von denen von FinalFrame; die großen Abstände bei der Spielzeugkamera und beim Käfer betrafen die 2 Fotos, die wegen großer Fehleinschätzungen ausgewählt wurden.
Über die API hatte GPT-6.1 Sol die ersten 3 Fotos mit Effort „low“ mit 8,2, 7,8 und 7,3 bewertet. Der App-Lauf unterscheidet sich davon in mehr als Memory: ein anderes Modell (GPT-6, nicht GPT-6.1 Sol), eine andere Effort-Einstellung und alles, was die App einem Chat hinzufügt. Es war ein einziges Konto, das des Gründers, mit aktiviertem Memory, also können frühere Chats spätere beeinflusst haben. Das zeigt also, was du von ChatGPT bekommst, so wie du es nutzen würdest, nicht, wie stark Memory allein einen Score verschiebt. Die Scores stehen auf So haben wir getestet (auf Englisch).
Drei Wege zu einer Fotokritik
Jede Zeile hat Ausnahmen. Die Chatbot-Spalte fasst zusammen, was Fotografen und ein Forschungsteam zwischen November 2025 und August 2026 veröffentlicht haben, Einzelerfahrungen statt eines kontrollierten Tests, und Chatbots ändern sich oft. Unsere eigenen Tests eines reinen Modells, über die API von OpenAI und von Hand in der ChatGPT-App, stehen oberhalb der Tabelle und sind nicht Teil dieser Spalte.
| Ein Chatbot, spontan gefragt | FinalFrame | Ein menschlicher Kritiker | |
|---|---|---|---|
| Technische Grundlagen | Von einem Tester an seinen eigenen fertigen Bildern gut bewertet; nicht an einem Foto mit bekanntem Fehler getestet (TechRadar, Dez. 2025) | Gemessen, Sept. 2026, mit einer früheren Version: Unschärfe in 75 von 80 Analysen deutlich unscharfer Fotos erkannt, 0 Fehlalarme in 100 Analysen scharfer Fotos; analysiert an einer gespeicherten Kopie deines Fotos, nicht an deiner Originaldatei, mit der Fokusprüfung am entscheidenden Detail als eigenem Schritt | Stark; ein Mentor kann die ganze Datei bei 100 % prüfen |
| Absicht und bewusster Regelbruch | Blind, wenn man es ihm nicht sagt (Venture Photography, Nov. 2025) | Nimmt dein Ziel als den Kontext, den du aus 6 wählst, und urteilt danach; darüber hinaus kann es die Absicht nicht kennen, sagt das und lässt dich das benannte Problem als nicht zu deinem Foto passend markieren | Das, was er am besten kann |
| Dasselbe Foto, noch einmal analysiert | In den veröffentlichten Beiträgen, auf die sich diese Spalte stützt, nicht gemessen; die Antwort ändert sich damit, wie du fragst (TechRadar, Dez. 2025) | Bei jedem vollständigen Testlauf gemessen; Okt. 2026, 77 Kritiken je 3-mal analysiert: nie mehr als 0,4 Punkte Abstand über die 3 Analysen, bei 47 derselbe FinalFrame-Score in allen 3; dieselbe Buchstabenstufe bei 71 | Kann mit Müdigkeit, Stimmung und der Reihenfolge der Einreichungen schwanken, deshalb setzen Salons eine Jury ein |
| Was es entscheidet | Kommentiert fast jeden Aspekt, in den Tests eines Preprints von 2026; kein festes Urteil (arXiv:2606.29689) | Ein Problem aus einer festen Liste; ein Stoppsignal mit Begründung; ein Ja oder Nein zu „Lohnenswert“ | Was ihm am wichtigsten ist; ein guter sagt dir, wann ein Bild fertig ist oder keine weitere Zeit wert ist |
| Tempo und Verfügbarkeit | Sekunden bis Minuten, zu jeder Stunde | Etwa eine Minute, zu jeder Stunde, mit dem oben beschriebenen Messen vorab | Stunden in einem Forum; eine Woche oder mehr für einen Clubabend oder einen Mentor |
Lies die FinalFrame-Spalte als ein Modell mit einem Messverfahren drumherum. Lies die rechte Spalte als die, für die du das Foto vorbereitest.
Wo ein menschlicher Kritiker noch vorn liegt
Bei der Absicht. Jede Quelle auf dieser Seite kommt hier an. Venture Photography, eine Workshop-Schule, in einem Beitrag vom November 2025 (Autorenzeile: sengmah): „KI kann nur bewerten, was sie visuell sieht, nicht, ob du dein künstlerisches Ziel erreicht hast.“ (Venture Photography, 24. Nov. 2025) Geoff Harris von Amateur Photographer hat im November 2025 ein Bild von Henri Cartier-Bresson in ChatGPT gegeben und eine Liste von Verbesserungen bekommen, von denen eine, so schrieb er, „HCB sich im Grab umdrehen lassen würde“. (Amateur Photographer, 17. Nov. 2025) Ein menschlicher Kritiker, der dich kennt oder einfach fragt, worauf du hinauswolltest, liest den gekippten Horizont als die Idee. Ein Modell liest ihn als gekippten Horizont; oft tut das auch ein Salonjuror, der das Bild sieht, ohne dass sein Urheber dabei ist, um es zu erklären.
Die Seite zur Bewertung von FinalFrame sagt, die Kritik „kann deine Absicht nicht kennen“ und „ein gekippter Horizont kann die ganze Idee sein“. Was sie aufnimmt, ist dein Ziel: Du wählst einen Kontext (Subtil & natürlich, Stimmung & Stil, Druckfertig, Wettbewerbsbereit, Social oder Auftragsarbeit), und das Foto wird daran beurteilt. Gleiches Foto, anderer Kontext, anderer Score, und genau darum geht es. Das gelabelte Set enthält Fotos mit bewusstem Stil (Augen hinter einer Sonnenbrille oder einer Hutkrempe, eine bewusste Bewegungsunschärfe), damit eine Stilentscheidung nicht als Grund für eine Neuaufnahme gelesen wird; die Zahl 0 von 132 oben schließt sie ein. Die Kritik kann trotzdem sagen, was die Entscheidung in dem gewählten Kontext kostet. Die Leseregel ist die der Seite zur Bewertung: Gewichte einen markierten Fehler geringer, wenn er eine bewusste Entscheidung war. Mehr dazu, wo die KI falsch liegen kann, steht auf So funktioniert der FinalFrame-Score.
Gefühl und Publikum. Ein menschlicher Kritiker kann dir sagen, ob das Bild bei ihm angekommen ist und wie es neben deinen übrigen Arbeiten wirkt. Die Stufen von FinalFrame sind an der Jurierung internationaler Salons kalibriert (den Ausstellungen von PSA und FIAP), und das ist ein nützlicher Maßstab, an dem man sich messen lassen kann; es bleibt ein Maßstab, kein Juror. Harris' Fazit ist das, das die meisten Fotografen wiedererkennen werden: „Kein großer Fotowettbewerb, der etwas auf sich hält, würde je die Jury feuern und stattdessen ChatGPT holen.“ (Amateur Photographer)
Das Selektivitätsproblem: was ein Preprint von 2026 herausfand
Der direkteste veröffentlichte Beleg, den wir gefunden haben, ist ein Preprint vom Juni 2026 von Sajjad Ghiasvand und vier Mitautoren, „Can MLLMs Critique Like Humans?“, der acht Modelle mit offenen Gewichten plus GPT-5.5 an gerankten menschlichen Kritiken zu 1.227 Beiträgen aus r/photocritique gemessen hat. (arXiv:2606.29689, v2 31. Aug. 2026) Zwei Befunde zählen hier.
Erstens gewannen die Frontier-Modelle die Präferenz der Bewerter: In der Hauptbedingung „bevorzugen alle 4 LLM-Bewerter die Kritiken der Frontier-Modelle gegenüber den menschlichen“. Doch gefragt, wie ähnlich jede Modellkritik der menschlichen in der Substanz war, gaben die Bewerter und 2 menschliche Annotatoren jedem Modell zwischen 1,81 und 2,59 auf einer 5-Punkte-Skala, „nahe an ‚größtenteils verschieden‘“. (arXiv:2606.29689)
Zweitens, und das ist der Befund, den man sich merken sollte: „Die Modelle weichen auf eine Weise ab, die die Scores nicht sichtbar machen: Sie decken fast jeden ästhetischen Aspekt ab, wo Menschen selektiv sind, und wiederholen sich über die Kritiken eines Fotos hinweg, selbst wenn sie angewiesen werden, in menschlicher Länge zu schreiben.“ Jeden Aspekt abzudecken heißt nicht, jedes Problem zu finden: Die Autoren fanden auch, dass „das Weglassen des Bildes“ die automatischen Ähnlichkeitswerte „kaum verändert“ und dass das übliche Maß „einen flüssigen, umfassenden Kritikstil belohnt statt der Selektivität und Spezifität menschlicher Kritik“. (arXiv:2606.29689) Einfach gesagt: Sich selbst überlassen, kommentiert ein Modell fast alles, und die automatischen Werte der Arbeit bewegten sich kaum, wenn das Modell das Foto nie gesehen hatte. Ein guter Kritiker schaut zuerst hin und lässt dann das meiste weg.
Das Design von FinalFrame antwortet auf beide Hälften dieses Befunds, auch wenn wir den Test der Arbeit nicht darauf angewendet haben. Das oben beschriebene Messen bindet die technischen Analysen an die Pixel. Die Hälfte zur Selektivität ist eine didaktische Entscheidung, die älter ist als die Arbeit: Die Kritik benennt ein Problem, ausgewählt danach, was es das Bild in deinem Kontext kostet, und stellt dieses eine an den Anfang, damit die nächste Bearbeitung ein Ziel hat. Ob dieses Problem das ist, das du benannt hättest, ist eine berechtigte Frage; mit „Passt nicht zu meinem Foto“ direkt darunter kannst du es markieren, wenn es nicht passt.
Konsistenz: der schwierige Teil und was wir gemessen haben
Konsistenz ist einer der schwierigen Teile jeder Kritik, ob von Mensch oder KI. In einer 4-jährigen Studie bei einem großen US-Weinwettbewerb bewerteten Juroren, die denselben Wein in einer Sitzung 3-mal bekamen, ihn oft unterschiedlich, manche von Bronze bis Gold (Hodgson, Journal of Wine Economics, 2008); eine solche Studie zu Fotojuroren haben wir nicht gefunden. Auch ein Modell kann dasselbe Foto unterschiedlich lesen, unseres eingeschlossen. Keine veröffentlichte Quelle, die wir gefunden haben, hat das gemessen, weder für einen Chatbot noch für irgendeine Kritik-App, also geht es in diesem Abschnitt um unseres; es ist auch ein Test, den du mit allem machen kannst, was du nutzt, uns eingeschlossen: Schick dasselbe Foto 3-mal und vergleiche. Auf der Seite zur Bewertung von FinalFrame steht: „Eine zweite Analyse desselben Fotos kann leicht anders ausfallen“, und das bleibt wahr. Was wir getan haben: messen, wie weit, und es dann eingrenzen.
Im Lauf vom Oktober 2026, 77 Kritiken von 73 Fotos, jede 3-mal analysiert, an einem Set voller Grenzfälle, bewegte sich keine um mehr als 0,4 Punkte über die 3 Analysen, und 47 der 77 bekamen bei allen 3 denselben FinalFrame-Score; die Buchstabenstufe stimmte bei allen 3 für 71 der 77 überein, die Einschätzung zu „Lohnenswert“ für 73 und die Stoppentscheidung für 75. Dahin kamen wir, indem wir zuerst gemessen haben: Im August 2026, an 10 Fotos mit je 5 Analysen, halbierte eine Änderung daran, wie das Modell betrieben wird, die mediane Spanne zwischen dem höchsten und dem niedrigsten potenziellen Score eines Fotos (wie weit Bearbeitung es bringen könnte), von 0,8 auf 0,4 Punkte. Die Spanne wird inzwischen bei jedem vollständigen Testlauf ausgewiesen; die Oktoberzahlen oben stammen aus einem dieser Läufe.
Eine Grenze. Das benannte Problem wiederholt sich weniger zuverlässig als der Score: In einem Lauf im September 2026 mit einer früheren Version, 71 Fotos mit je 5 Analysen, stand bei 59 davon in mindestens 4 der 5 Analysen dasselbe Problem vorn und bei 40 in allen 5, also kann eine erneute Analyse mit einem anderen Problem beginnen.
Wie du beide nutzt
Behandle die beiden als verschiedene Instrumente statt als Rivalen. Nutze die KI-Analyse innerhalb der Bearbeitungsschleife: Behebe das eine, was sie benennt, lade die neue Version hoch, sieh nach, ob die Korrektur gegriffen hat, und hör auf, wenn das Stoppsignal sagt, warum. Bei der neuen Version sagt die Kritik, ob das frühere Problem behoben, teilweise behoben oder noch vorhanden ist, und eine Scoreänderung von 0,1 oder weniger wird als „im Rahmen der normalen Schwankung“ gekennzeichnet, statt als Fortschritt gemeldet zu werden.
Nutze Menschen dort, wo die KI dir gesagt hat, dass sie blind ist. Bring die fertige Version zu einem Kritikabend im Fotoclub oder in ein Forum wie r/photocritique und stell eine einzige Frage: Sagt dieses Bild, was ich gemeint habe? Du bekommst die emotionale Einschätzung, die Einschätzung des Kontexts und manchmal ein „Dieses Foto lässt mich kalt“, das dir kein Modell geben wird. Wo die beiden bei einem technischen Fehler uneins sind, entscheidet die Datei, bei 100 % und in der Größe, in der sie gezeigt wird; wo sie uneins sind, ob das Bild funktioniert, beantwortet der Mensch die Frage, auf die es ankommt.
Wenn du das Symptom schon benennen kannst (ein flaues Bild, ein weißer Himmel, ein weiches Auge), geh direkt zum Diagnose-Verzeichnis, das jedes davon zu seiner Lektion leitet. Und wenn das Bild aufnahmebegrenzt ist, hebt keine Bearbeitung diese Grenze auf: Dann lautet die Frage, ob es so funktioniert, wie es ist, oder eine Neuaufnahme verdient. Wenn du die Methode suchst, der eine Kritik folgt, und keinen Vergleich, wer sie liefert, lies So kritisierst du ein Foto.
Häufige Fragen zur KI-Fotokritik
- Kann ChatGPT meine Fotos kritisieren?
- Das tut es, und mit einem ausführlichen Prompt besser. Peter Fenech von TechRadar fand, dass es „das Feedback wahrscheinlich allgemein hält“, solange er seine Absicht nicht beschrieb, und vermutete trotzdem, dass vieles davon „aus Standardantworten gezogen“ war. (TechRadar, Dez. 2025; Amateur Photographer, Nov. 2025) OpenAI sagt, dass ChatGPT sich bei aktiviertem Memory Details aus deinen früheren Chats merken und sie nutzen kann, um seine Antworten zu personalisieren (OpenAI Help Center, „Memory in ChatGPT“, abgerufen im Oktober 2026). Wenn du Feedback zum Foto willst, das nicht davon geprägt ist, was ChatGPT über dich weiß, starte einen temporären Chat und wähle, wo es die Wahl gibt, „Unpersonalized“ (nicht personalisiert). Keiner der beiden Zeitschriftenartikel hat es an einem Foto mit bekanntem Fehler getestet, und keiner hat gemessen, ob es dasselbe Foto zweimal gleich liest. Was FinalFrame hinzufügt, liegt außerhalb des Prompts: eine Fokusprüfung am entscheidenden Detail als eigener Schritt, Analysen, die an Fotos mit bekannten Fehlern getestet sind, und eine gemessene Antwort darauf, wie weit sich eine wiederholte Analyse bewegt.
- Ist KI-Fotokritik zutreffend?
- Das hängt davon ab, was gemessen wurde, also frag nach den Zahlen. Die von FinalFrame, aus seinen eigenen gelabelten Testläufen: Unschärfe in 75 von 80 Analysen deutlich unscharfer Bilder erkannt und fälschlich in 0 von 100 Analysen scharfer Bilder (September 2026, mit einer früheren Version), und bei 77 Kritiken von 73 Fotos, jede 3-mal analysiert, dieselbe Stufe in allen 3 Analysen für 71 (Oktober 2026). Bei der Absicht kennt es den Kontext, den du wählst: den Maßstab, an dem es urteilt. Was es nicht wissen kann, ist, dass eine Entscheidung innerhalb des Bildes bewusst war, also kann ein High-Key-Himmel oder ein absichtlich gekippter Horizont als Fehler gelesen werden; gewichte diesen Hinweis geringer. Seine Nutzungsbedingungen nennen die Ausgabe „algorithmische Meinung“, keine Expertenbewertung. Behandle es als gemessene Zweitmeinung gegen einen benannten Maßstab.
- Macht KI-Feedback meine Fotos austauschbar?
- Das kann passieren, wenn du alles umsetzt, was ein allgemeines Modell sagt: Der Preprint von 2026 fand, dass Modelle „fast jeden ästhetischen Aspekt abdecken, wo Menschen selektiv sind“, und dass ihre Ähnlichkeit mit menschlichen Kritiken „eher einen stabilen Kritikstil als bildspezifische Beobachtung“ widerspiegelt (arXiv:2606.29689); 10 Hinweise auf einmal zu beheben ist der Weg, auf dem ein unverwechselbares Bild zu einem bloß korrekten wird. FinalFrame benennt ein Problem pro Kritik, ausgewählt danach, was es das Bild in dem gewählten Kontext kostet. Behebe es, lade die neue Version hoch und sieh nach, ob die Korrektur gegriffen hat. Wenn das eine, was es benennt, eine Entscheidung ist, die du absichtlich getroffen hast, behalte sie.
- Gibt es eine kostenlose KI-Fotokritik?
- Ja. Die Startseite von FinalFrame bietet eine kostenlose Demo-Kritik ohne Konto (die Stufe, die Scores, der benannte Engpass und das Urteil; die vollständigen Bearbeitungsanpassungen brauchen ein kostenloses Konto), und ein kostenloses Konto bekommt 3 Kritiken pro Monat, je 1 Credit, dazu bis zu 2 Bonus-Credits, einmalig, wenn du eine bearbeitete Version hochlädst.
Sieh dir eine gemessene Kritik eines Bildes an, das du gut kennst
Lade ein Foto hoch, zu dem du schon eine Meinung hast. FinalFrame liest seinen Fokus und ob es eine Grenze aus der Aufnahme hat, benennt das eine Problem, das es am meisten kostet, und sagt, ob sich weitere Bearbeitung lohnt, und warum, wenn es Stopp sagt. Die Reglerwerte für diese eine Korrektur gibt es mit einem kostenlosen Konto. Vergleiche das mit dem, was du gesagt hättest; die Abweichungen in beide Richtungen sind der nützliche Teil.
Foto kritisieren lassenChatGPT und OpenAI sind Marken von OpenAI. FinalFrame ist nicht mit OpenAI verbunden und wird von OpenAI nicht befürwortet.