AIの写真講評と人間の講評:チャットボット、講評ツール、人間がそれぞれ見抜くもの
AIの写真講評の質は、モデルの周りに何を組み立て、何を測っているかで決まります。汎用のチャットボットは、あなたが入力した質問に答えます。FinalFrameはまず写真を測り、毎回同じ固定された問いを投げかけ、欠点がすでにわかっている写真で自らの読みをテストしています。得られるのは、あなたが選んだ基準に照らして測られたセカンドオピニオンです。名指しされたひとつの問題、それに対するお使いの編集ソフトのスライダーの値、そしてこれ以上の編集に価値があるかどうかの判定です。だから次の編集に方向が生まれます。それでも、意図と、写真が心に届くかどうかでは、人間の講評者が勝ります。
写真をチャットボットに貼りつけて「どう思う?」と尋ねたことがあるなら、2025年末にChatGPTを試した写真家たちが述べている答えに見覚えがあるかもしれません。温かい書き出し、うまくいっている点の一覧、そして控えめな提案がひとつかふたつ。このページでいう意味での講評は、毎回同じ固定された問いを写真に投げかけ、その技術的な状態を測り、問題をひとつ名指しし、次に何をするかを決めます。
次の写真をどこに見せるか選んでいるなら、このページには、日付を添えたFinalFrameの測定値、同じ依頼に対してチャットボットがどんな返答をするか、そして人のほうがまだ上手なところがまとめてあります。
AIの写真講評とは何か、チャットボットに尋ねるのとどう違うのか
汎用のチャットボットは、受け取ったプロンプトに答えます。写真と曖昧な質問を渡せば、何について話すかはボットが選びます。TechRadarのPeter Fenech(元Digital Photographer誌編集者)は、2025年12月にまさにこのテストを行い、最初のラウンドを一行でまとめました。「汎用的なプロンプトを与えると、フィードバックも汎用的なままになりがちだ」。意図を明示した長いプロンプトでは、より的を絞った返答が得られました。(TechRadar、2025年12月31日)
より良いプロンプトからは、より整った答えが返ってきます。Fenechが確かめたのはまさにそのことです。FinalFrameが加えるものは、プロンプトの中にはありません。FinalFrameは、講評を書く前に写真を測ります。ファイルに記録されたカメラのデータを読み、大事なディテールのピントを、独立したひとつの工程として、拡大して確認します。そのうえで、すべての講評が同じ固定された問いに、決まった順序で答えます。そのため、読みが何を扱うかは、あなたの尋ね方の上手下手に左右されません。FinalFrameは、利用規約に記載のとおり、OpenAIのモデルで動いています。モデルは結果の一部にすぎません。残りは、書く前に測ること、そして書いた内容を、欠点がすでにわかっている写真で検証することです。その数値は次の節で示します。
ここで特に重要なのは3つの問いです。ひとつ目は、大事なところでフレームがシャープか、そしてその問題は撮り直すべきものか、机の前で直せるものか。これは私たちが最も厳しくテストしている2つの読みです。2つ目は、フレームに最も損失を与えているひとつの問題は何か。決まった一覧から名指しされ、あなたが選ぶレーン、つまり測ってほしい基準(クリーン&ナチュラル、ムード&スタイル、プリント向け、コンペティション向け、ソーシャル、クライアント納品)で、それがフレームにどれだけの損失を与えるかによって選ばれます。3つ目は、編集を続けるべきか。理由つきの「編集をやめる」フラグと、「はい」か「いいえ」で答える「続ける価値」の判定です。答えと一緒に、何を動かすかも示されます。そのひとつの問題に対するスライダーの値が、環境設定で選んだ編集ソフト(Lightroom、Capture One、Photoshopなど)の形で示されます。編集したバージョンをアップロードすると、次の講評が、その問題が解決したのか、部分的に解決したのか、まだ残っているのかを伝えます。こうした問いはチャットボットにも入力できます。入力できないのは、ひとつ目の問いを支えるピントの確認、次の節で報告する、欠点がわかっている写真でのテスト、そして編集で何が変わったかの測定です。新しいバージョンはそれぞれ単独で採点されたうえで、前のバージョンと比べて測られ、同じファイルを再アップロードすると同じ画像として示されます。
AI講評が強いところ、そしてその根拠
まずは技術の読みです。Fenechの結論は「AIは技術的な分析がとても得意だ」というものでしたが、彼が試したのは自分の完成したフレームで、私たちが見つけた記事のどれも、欠点がわかっている写真では試していませんでした。(TechRadar;Amateur Photographer、2025年11月;Venture Photography、2025年11月)そこで、私たちは自分たちの講評を試しました。前回の本格的なピントのテストは、2026年9月に以前のバージョンの講評で行ったもので、明らかにピントの甘い写真16枚をそれぞれ5回読ませました。80回の読みのうち75回で甘さを捉え、シャープな写真20枚の100回の読みでは、一度も甘いとは判定しませんでした。2026年10月のテストでは、カメラのデータが残っているファイルを使い、本当の撮影上の限界がある写真15枚について、45回の読みのすべてでその限界を検出しました。また、スタイル上の選択や直せる欠点を撮影上の限界と読んではならない写真44枚では、132回の読みで撮り直しの誤判定は0回でした。これらは私たちが用意した写真とラベルで、難しいものを選んでいます。あなたの写真はこのセットに含まれていません。
2つ目は、やめどきです。初回の講評で、FinalFrameは決まった一連の「やめる」条件を確認します。また、どんな編集でも引き上げられない撮影レベルの限界、つまり被写体を外したピントのように、シャッターを切った瞬間に決まってしまった欠点がフレームにある場合は、早めに「やめる」と言うこともできます。その場合、理由がその限界を名指しし、フレームは一時間をかける価値がないとマークされます。目に見えて楽しそうに編集している写真について、もう編集をやめたらと言ってくれる友人は、あまりいません。言ってくれる指導者も、いつもそばにいるとは限りません。このフラグは、その判断をすべての講評に入れます。そのフラグの読み方は、編集をやめるのレッスンで扱っています。
3つ目はスコアそのものです。欠点のある写真を、問題のない写真より下に置くでしょうか。2026年10月、私たちはFinalFrameの新しいバージョンごとに確認に使っている、ラベルつきのテストセットから42枚の写真を採点しました。欠点がわかっている写真が16枚(うち15枚はピントの問題)、欠点のない写真が26枚です。問題のない写真と欠点のある写真の組み合わせ416組のうち412組(99%)で、FinalFrameは問題のない写真に高いスコアをつけました。平均は、問題のない写真が7.0、欠点のある写真が5.4でした。
同じ写真について、推論エフォートを低く設定したGPT-6.1 Solに、OpenAIのAPI経由で(ChatGPTアプリではなく)写真と、講評と1~10のスコアを求める短い依頼だけを渡したところ、平均は問題のない写真が7.7、欠点のある写真が6.7でした(推論エフォートを高く設定した場合は7.7と6.6)。グループ間の差はおよそ1点で、FinalFrameは1.6点の差をつけました。方法、プロンプト、すべての写真のスコアはテストの方法(英語)にあります。
素のモデルは、数行の指示を与えられた有能なモデルです。FinalFrameを横に並べたときに見えるのは、どちらのモデルが優れているかではなく、モデルの周りに何が組み立てられているかです。FinalFrameがモデルの周りに組み立てているのは、よりどころとして使うための講評です。写真に欠点があれば下がるスコア、名指しされたひとつの問題、これ以上の編集に価値があるのか、それとも撮り直しが必要なのかの判定、スコアを最も動かす変更、そして選んだレーンでの次の編集のためのスライダーの値です。下の2枚の写真は、素の返答とそのスコアが食い違いうるところを示しています。
欠点のある写真から2枚:それぞれが書いたことと、つけたスコア
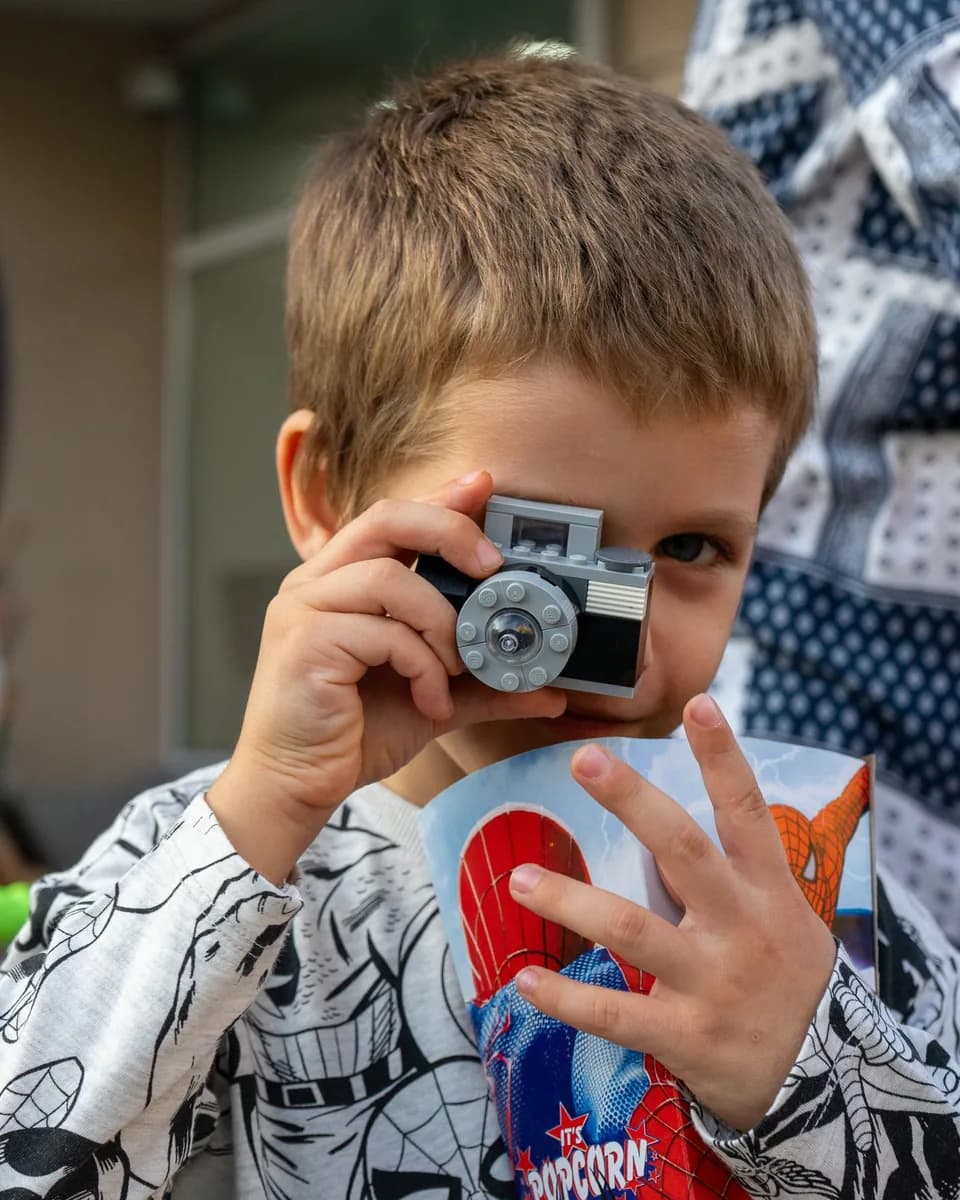
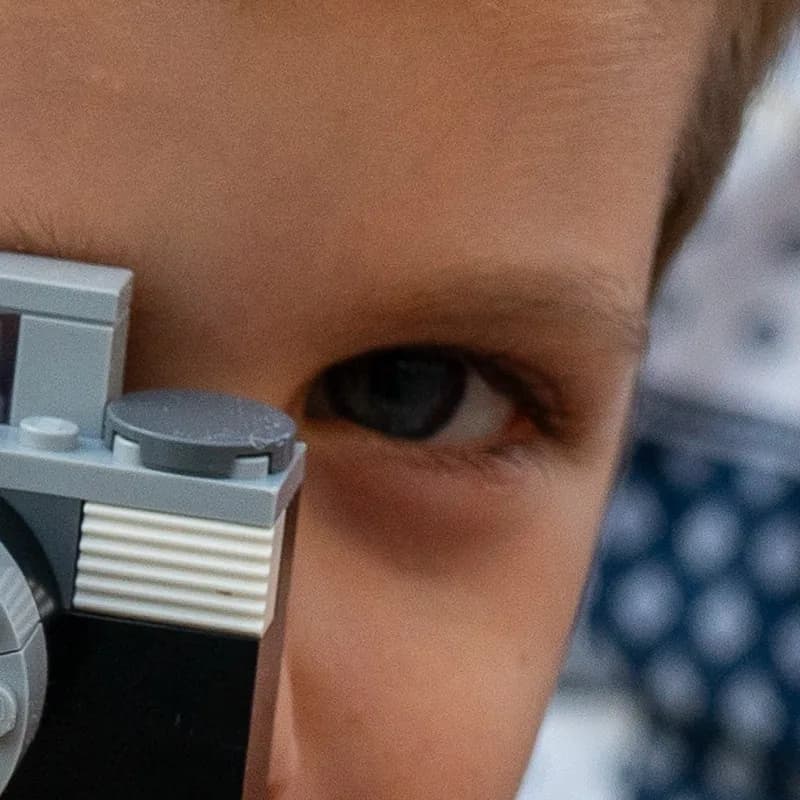
同じファイルから、目を拡大したもの。
素のGPT-6.1 Sol(OpenAI API、低い推論エフォート設定):7.8/10。FinalFrame(クリーン&ナチュラルのレーン):5.5/10。それぞれ1回の読み、2026年10月。
GPT-6.1 Sol(OpenAI API、低い推論エフォート設定/英語から翻訳)
7.8/10
GPT-6.1 Sol:「大事なところのピントは良好で、髪、目、手のディテールが心地よく出ています。」最大の問題として挙げたのは「この写真のいちばんの足かせは、右側の背景にいる、気を散らす人物です。」
FinalFrame(英語から翻訳)
5.5/10
FinalFrame:「見えている片目がポートレート全体を支えなければならないのに、クリーンなポートフォリオ作品としては十分にシャープではありません。」そして判定は「私なら、このバージョンの編集にこれ以上あまり時間はかけません。目にピントをきっちり合わせて撮り直す価値のあるアイデアです。」
素のモデルはピントを褒め、7.8をつけました。FinalFrameはピントの甘い目を限界として名指しし、5.5をつけ、編集を続けるより撮り直すよう伝えました。言葉と数字が同じことを語っています。
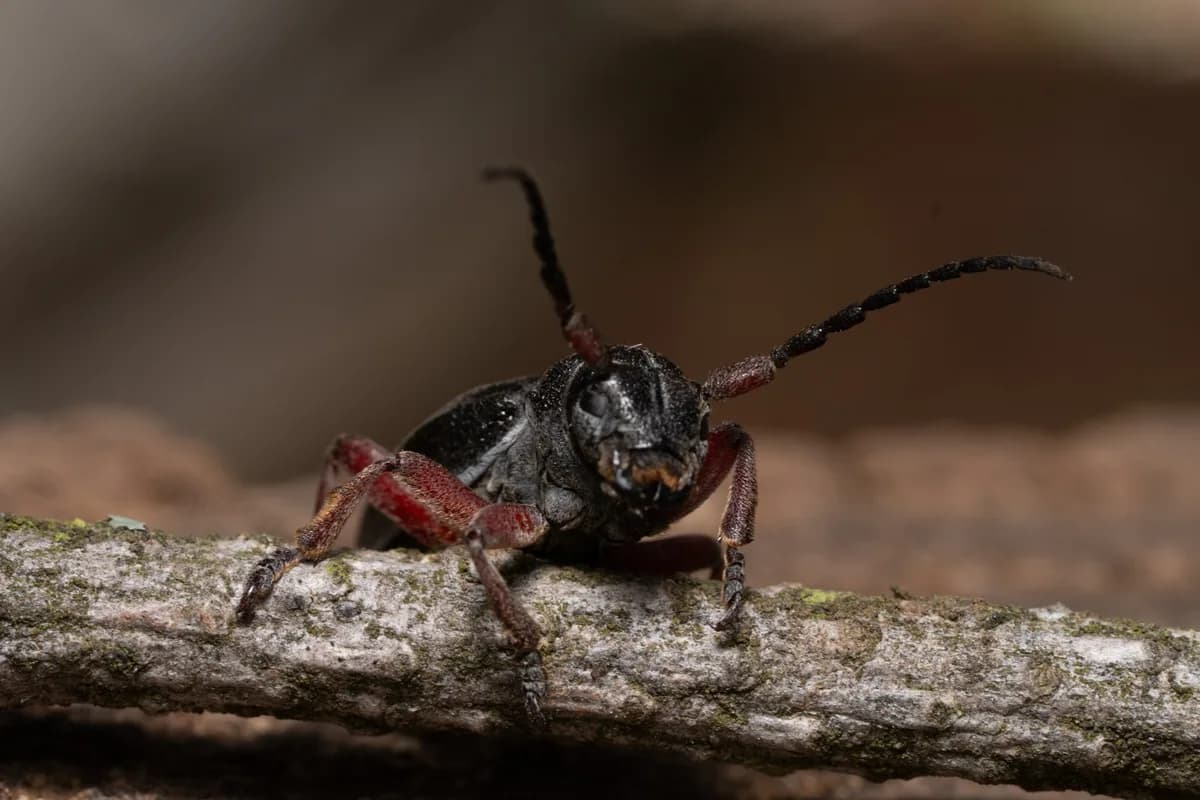
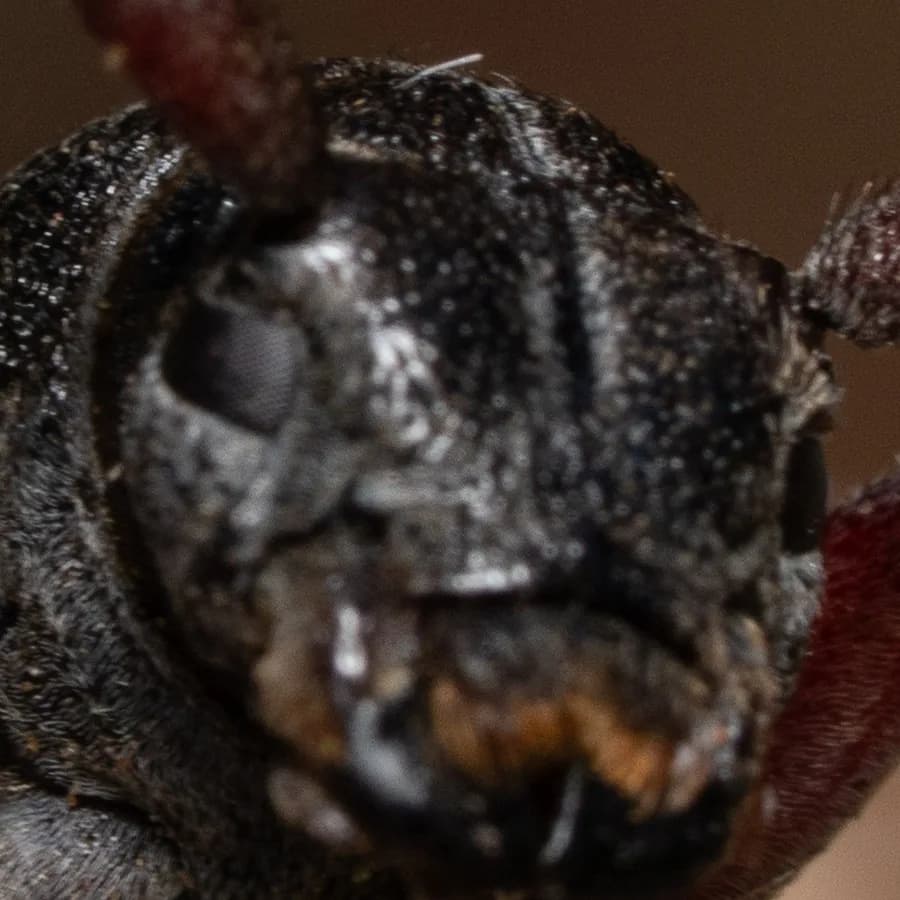
同じファイルから、目を拡大したもの。
素のGPT-6.1 Sol(OpenAI API、低い推論エフォート設定):7.3/10。FinalFrame(クリーン&ナチュラルのレーン):5.6/10。それぞれ1回の読み、2026年10月。
GPT-6.1 Sol(OpenAI API、低い推論エフォート設定/英語から翻訳)
7.3/10
GPT-6.1 Sol:「この写真のいちばんの足かせは、目と顔のまわりにくっきりとしたディテールがないことです。そこは自然と視線が集まる場所ですが、わずかにピントが甘く見えます……」
FinalFrame(英語から翻訳)
5.6/10
FinalFrame:「顔/目の部分が、十分な精度で解像していません。」そして判定は「シャープニングと局所コントラストでは、これをシャープなポートフォリオ作品にはできません。」
こちらでは、両方がピントの甘い顔を指摘しました。おもちゃのカメラの写真ではピントを良好と評した素のモデルは、この写真をわずか0.5点低く採点しただけでした。7.8に対して7.3です。FinalFrameの5.6は、その言葉と同じことを語っています。そして言葉は、シャープニングでは直らないとも伝えています。
自分ですでに判断した写真で試してみてください。名指しされたひとつの問題、これ以上の編集に価値があるかどうかの「はい」か「いいえ」、そしてやめるべきだと言うときの理由がわかります。そのうえで、自分なら言ったであろうことと比べてください。
写真を講評するChatGPTアプリでの同じ依頼
上のテストはOpenAIのAPIを通して行いました。けれども多くの人は、ChatGPTアプリで尋ねます。それも多くの場合、それまでのチャットやメモリが反映された状態で。そこで私たちは、メモリをオンにした有料アカウントで、アプリを開いたときのモデルと設定(GPT-6、Medium)のまま、同じ依頼を手でアプリに入力しました。対象は、APIのモデルのスコアが私たちのスコアと最も離れていたものの一つとして選んだ上の例の2枚と、同じセットの問題のない写真1枚で、それぞれ3回、毎回新しいチャットで尋ねました。
アプリのスコアは、チャットごとにほとんど動きませんでした。問題のない写真は7.6、7.6、7.8、おもちゃのカメラの写真は7.2、7.2、7.1、甲虫の写真は7.2、7.4、7.2です。3回のどのラウンドでも、問題のない写真を欠点のある2枚より0.2~0.7点高く採点しました。ピントが目を外していたおもちゃのカメラの写真については、3回の返答のどれも、目のピントの甘さに気づきませんでした。2回はピントを良好と評し(「ピントはそれなりにシャープです」、英語から翻訳)、3回目は髪、手、おもちゃのカメラのディテールを褒めましたが、そこはまさにピントが合っていた場所です。そして3回とも、雑然とした要素を原因に挙げました。甲虫の写真では、数字よりも言葉のほうが大きく動きました。2回の返答は顔のピントの甘さを挙げ、3回目は「甲虫の顔が暗すぎます」(英語から翻訳)という別の問題を挙げて、シャドウを持ち上げるよう勧めました。どちらの場合も、スコアは7.2から7.4のあいだにとどまりました。
その2枚は大きく外れたものとして選んだため、そうではない写真を2枚加えました。私たち自身のキャリブレーション用セットから、ありふれた欠点(フラットで明るい光と、白飛び寸前の空)のあるロバのポートレートと、問題のない写真をもう1枚、夕景のパノラマです。それぞれ3回のチャットで尋ねました。ロバの写真では、アプリは3回のチャットで毎回違う主な問題を挙げました。光、次に空いた空間、次に背後の木々に重なるロバの頭です。どれもこの写真についてのもっともな指摘で、うち2つは創業者自身の評価にも含まれていますが、毎回違うものでした。FinalFrameは同じファイルで3回実行し、毎回、明るい空が顔より目立っていることを挙げ、毎回7.0をつけ、毎回同じ編集プランを示しました。パノラマでは、アプリの3回の返答もFinalFrameの3回の実行も、すべて暗い前景を指摘しました。この2枚では、アプリのスコアはFinalFrameのスコアから0.5点以内に収まりました。おもちゃのカメラと甲虫での大きな開きは、大きく外れたものとして選んだ2枚でのことです。
API経由では、GPT-6.1 Solは推論エフォートを低く設定した状態で、最初の3枚に8.2、7.8、7.3をつけていました。アプリでの実行は、メモリ以外の点でもそれとは異なります。モデルが違い(GPT-6.1 SolではなくGPT-6)、推論エフォートの設定が違い、さらにアプリがチャットに加えるものがあります。使ったのは創業者のアカウント1つで、メモリはオンでした。そのため、先のチャットが後のチャットに影響した可能性があります。ですから、これが示しているのは、あなたが普段使うのと同じようにChatGPTを使ったときに得られるものであって、メモリだけでスコアがどれだけ動くかではありません。スコアはテストの方法(英語)にあります。
写真の講評を受ける3つの方法
どの行にも例外があります。チャットボットの列は、2025年11月から2026年8月までに写真家たちと1つの研究チームが公開した内容をまとめたもので、管理されたテストではなく個々の体験です。また、チャットボットはよく変わります。素のモデルについての私たち自身のテストは、OpenAIのAPI経由とChatGPTアプリでの手入力の両方とも、この表の前で報告しており、この列には含めていません。
| その場で尋ねるチャットボット | FinalFrame | 人間の講評者 | |
|---|---|---|---|
| 技術的な基本 | 1人のテスターが自分の完成したフレームで高く評価。欠点がわかっている写真では未検証(TechRadar、2025年12月) | 2026年9月に以前のバージョンで測定:明らかにピントの甘い写真の80回の読みのうち75回で甘さを指摘、シャープな写真の100回の読みで誤った指摘は0回。読むのは元のファイルではなく保存された写真のコピーで、大事なディテールのピント確認を独立した工程として実行 | 強い。指導者ならファイル全体を100%で確認できる |
| 意図と、意図的なルール破り | 言われなければ見えない(Venture Photography、2025年11月) | 6つの中から選んだレーンを目標として受け取り、それに照らして判定。それ以上の意図は知りえず、そう明言し、名指しされた問題を写真と一致しないとマークできる | 最も得意とすること |
| 同じ写真をもう一度読むと | この列が依拠する公開記事では測られていない。答えは尋ね方で変わる(TechRadar、2025年12月) | 本格的なテストのたびに測定。2026年10月、77件の講評を3回ずつ読ませた結果:3回の読みの差は最大0.4点、47件は3回とも同じFinalFrameスコア、71件は同じ文字ティア | 疲れや気分、作品の順番で揺れることがある。だからサロンは審査員団を置く |
| 何を決めるか | 2026年のプレプリントのテストでは、ほぼすべての側面にコメント。固定された判定はない(arXiv:2606.29689) | 決まった一覧から問題をひとつ。理由つきの「編集をやめる」フラグ。「続ける価値」のはい/いいえ | その人にとって最も大事なこと。良い講評者なら、フレームが完成したとき、あるいはこれ以上時間をかける価値がないときに教えてくれる |
| 速さと利用しやすさ | 数秒から数分、いつでも | 約1分、いつでも。前述の測定を先に実行 | フォーラムなら数時間。クラブの講評会や指導者なら1週間以上 |
FinalFrameの列は、測定の工程に囲まれたモデルとして読んでください。右の列は、あなたが写真を仕上げて持っていく相手として読んでください。
人間の講評者がまだ勝るところ
意図です。このページのどの情報源も、ここに行き着きます。ワークショップを開く写真学校Venture Photographyは、2025年11月の記事(署名:sengmah)でこう書いています。「AIは目に見えるものしか評価できず、あなたが芸術的な目標を達成したかどうかは評価できない」。(Venture Photography、2025年11月24日)Amateur PhotographerのGeoff Harrisは、2025年11月にアンリ・カルティエ=ブレッソンの一枚をChatGPTに読ませ、改善点の一覧を受け取りました。そのうちの一つは、彼の言葉によれば「HCBが草葉の陰で泣くような」ものでした。(Amateur Photographer、2025年11月17日)あなたを知っている人間の講評者、あるいは単に何を狙ったのかを尋ねてくれる講評者なら、傾いた水平線をアイデアとして読みます。モデルは、それを傾いた水平線として読みます。サロンの審査員も、しばしば同じように読みます。審査員は、説明してくれる作者がその場にいないまま写真を見るからです。
FinalFrameの採点ページには、講評は「あなたの意図を知ることはできません」とあり、「傾いた水平線はアイデアそのものかもしれません」とも書かれています。その代わりに受け取るのが、あなたの目標です。あなたがレーン(クリーン&ナチュラル、ムード&スタイル、プリント向け、コンペティション向け、ソーシャル、クライアント納品)を選ぶと、写真はそれに照らして判定されます。同じ写真でもレーンが違えばスコアが違う、そこが肝心な点です。ラベルつきのセットには、意図的なスタイルの写真(サングラスや帽子のつばに隠れた目、意図的な被写体ブレ)が含まれていて、スタイル上の選択が撮り直しの理由と読まれないようにしています。上で挙げた132回中0回という数字には、これらの写真も含まれています。それでも講評は、その選択が選んだレーンでどれだけの損失になるかを伝えることがあります。読み方の規則は採点ページのとおりです。指摘された欠点が意図的な判断だったなら、その指摘を軽めに受け止めてください。AIがどこで間違いうるかについては、FinalFrameスコアの仕組みで詳しく説明しています。
感情と、その場での読まれ方。人間の講評者は、写真が自分に届いたかどうか、そしてあなたのほかの作品と並べてどう読めるかを伝えられます。FinalFrameのティアは国際的なサロン審査(PSAとFIAPの展覧会)に合わせて調整されていて、それは自分を測る基準として役に立ちます。それでも、それは基準であって、審査員ではありません。Harrisの結論は、ほとんどの写真家が納得するものでしょう。「名のある大きな写真コンテストが、審査員団を解任して代わりにChatGPTを入れることなど、決してないだろう」。(Amateur Photographer)
選択性の問題:2026年のプレプリントが見つけたこと
私たちが見つけた公開の証拠のうち最も直接的なものは、Sajjad Ghiasvandと4人の共著者による2026年6月のプレプリント「Can MLLMs Critique Like Humans?」です。8つのオープンウェイトモデルとGPT-5.5を、r/photocritiqueの1,227件の投稿についての、順位づけされた人間の講評と比べて採点しています。(arXiv:2606.29689、v2 2026年8月31日)ここで重要な知見は2つです。
第一に、フロンティアモデルが判定者の好みを勝ち取りました。主要な条件では、4つのLLMの判定者がすべて「人間の講評よりもフロンティアモデルの講評を好む」結果でした。ところが、各モデルの講評が内容の面で人間の講評とどれほど似ているかを尋ねると、判定者と2人の人間のアノテーターは、どのモデルにも5段階の尺度で1.81から2.59のあいだの点をつけました。「『ほとんど異なる』に近い」値です。(arXiv:2606.29689)
第二に、そしてこちらこそ覚えておくべき点です。「モデルはスコアには表れない形で食い違う。人間が取捨選択するところで、モデルはほぼすべての美的側面を網羅し、人間と同じ長さで書くよう指示されても、1枚の写真に対する複数の講評のあいだで同じことを繰り返す」。すべての側面を網羅することは、すべての問題を見つけることではありません。著者たちはまた、画像を伏せても自動の類似度スコアは「ほとんど変わらない」こと、そして一般的な指標が「人間の講評の選択性や具体性ではなく、流暢で網羅的な講評のスタイルに報いる」ことも見出しています。(arXiv:2606.29689)平たく言えば、放っておくとモデルはほとんどすべてについてコメントし、モデルが写真を一度も見ていなくても、論文の自動スコアはほとんど動きませんでした。良い講評者は、まず見て、それからそのほとんどを省きます。
FinalFrameの設計は、この知見の両方の側面に応えています。ただし、論文のテストをFinalFrameに対して行ったわけではありません。前に述べた測定が、技術の読みをピクセルに結びつけます。選択性の側面は、論文より前からある、教え方としての選択です。講評は、あなたのレーンでフレームにどれだけの損失を与えるかで選んだ問題をひとつ名指しし、それを先頭に置きます。だから次の編集の狙いはひとつに定まります。その問題が、あなた自身なら挙げたであろうものと同じかどうかは、もっともな疑問です。違うときは、その下にある「自分の写真と一致しない」でマークできます。
一貫性:難しいところと、私たちが測ったこと
一貫性は、人間でもAIでも、どんな講評にとっても難しいところのひとつです。米国の大手ワインコンテストで行われた4年間の研究では、1回の審査の中で同じワインを3回出された審査員が、しばしば異なる点をつけ、中には銅賞から金賞まで揺れた例もありました(Hodgson、Journal of Wine Economics、2008年)。写真の審査員について同様の研究は見つかりませんでした。モデルもまた、同じ写真を違うふうに読むことがあり、私たちのものも例外ではありません。チャットボットについても、どの講評アプリについても、それを測った公開の情報源は見つからなかったので、この節は私たちのものについての話です。これは、私たちを含め、あなたが使っているどのツールにも試せるテストでもあります。同じ写真を3回送って比べてください。FinalFrameの採点ページには「同じ写真を読み直すとわずかに異なる結果になることがある」とあり、それは今も変わりません。私たちがしたのは、その揺れがどれほどかを測り、そのうえで抑えることでした。
2026年10月のテストでは、境界的なケースを多く含むセットで、73枚の写真に対する77件の講評をそれぞれ3回読ませたところ、3回の読みのあいだで0.4点を超えて動いたものはひとつもなく、77件中47件は3回とも同じFinalFrameスコアでした。文字ティアは77件中71件、「続ける価値」の判定は73件、「やめる」判定は75件で、3回とも一致しました。そこに至るには、まず測ることが必要でした。2026年8月、10枚の写真をそれぞれ5回読ませたテストで、モデルの動かし方をひとつ変えたことで、写真の潜在スコア(編集でどこまで伸ばせるか)の最高値と最低値の幅の中央値が、0.8点から0.4点へと半分になりました。この幅は現在、本格的なテストを行うたびに報告しており、上の10月の数値もそうしたテストのひとつから得たものです。
限界がひとつあります。名指しされる問題は、スコアほどには安定して繰り返されません。2026年9月に以前のバージョンで71枚の写真をそれぞれ5回読ませたテストでは、5回中少なくとも4回で同じ問題が先頭に来たのが59枚、5回すべてで同じだったのが40枚でした。そのため、読み直すと別の問題が先頭に来ることがあります。
両方の使い方
二つを、競争相手ではなく別々の道具として扱ってください。AIの読みは、編集のループの中で使います。名指しされたひとつのことを直し、新しいバージョンをアップロードして、その修正が効いたかどうかを確かめ、「編集をやめる」フラグが理由を示したらやめます。新しいバージョンでは、講評が前の問題について、解決したのか、部分的に解決したのか、まだ残っているのかを伝えます。また、0.1点以下のスコアの動きは、進歩として報告されるのではなく、誤差範囲内と表示されます。
AIが自分では見えないと言ったところでは、人を使ってください。完成版を写真クラブの講評会やr/photocritiqueのようなフォーラムに持っていき、ひとつだけ尋ねます。この写真は、私が伝えたかったことを伝えていますか。感情面の読み、文脈の読み、そして時には「この写真には興味が持てない」という答えが返ってきます。それはどのモデルからも得られないものです。技術的な欠点で両者の意見が分かれたら、決着をつけるのはファイルです。100%表示で、そして実際に見せるサイズで確かめてください。フレームが成り立っているかどうかで意見が分かれたら、大事な問いに答えているのは人間のほうです。
症状をすでに言葉にできるなら(フラットなフレーム、白い空、ピントの甘い目)、まっすぐ診断ページへ行ってください。それぞれの症状を、そのレッスンへと案内してくれます。そして、フレームに撮影が原因の限界があるなら、どんな編集でもその限界は越えられません。問題は、そのままで成り立つのか、それとも撮り直す価値があるのか、になります。誰が講評するかの比較ではなく、講評がたどる方法を知りたいなら、写真を講評する方法を読んでください。
AIの写真講評についてよくある質問
- ChatGPTで写真を講評できますか?
- できますし、詳しいプロンプトを渡せばより良くなります。TechRadarのPeter Fenechは、自分の意図を説明しない限り「フィードバックも汎用的なままになりがち」だと気づき、それでもその多くは「定型の答えから引っ張ってきた」ものではないかと疑っていました。(TechRadar、2025年12月;Amateur Photographer、2025年11月)OpenAIによれば、メモリがオンのとき、ChatGPTは過去のチャットの詳細を覚えておき、それを使って返答をパーソナライズできます(OpenAIヘルプセンター「Memory in ChatGPT」、2026年10月閲覧)。ChatGPTがあなたについて知っていることに左右されない写真へのフィードバックがほしいなら、一時チャットを始め、選択肢があれば「パーソナライズなし(Unpersonalized)」を選んでください。どちらの雑誌記事も、欠点がわかっている写真では試しておらず、同じ写真を2回同じように読むかどうかも測っていません。FinalFrameが加えるものはプロンプトの外にあります。大事なディテールのピント確認を独立した工程として実行すること、欠点がわかっている写真で検証された読み、そして読み直しでどれだけ動くかについての測定された答えです。
- AIの写真講評は正確ですか?
- 何が測られたかによるので、数字を求めてください。FinalFrameの数字は、自社のラベルつきテストによるものです。明らかにピントの甘いフレームの80回の読みのうち75回で甘さを指摘し、シャープなフレームの100回の読みで誤った指摘は0回でした(2026年9月、以前のバージョン)。また、73枚の写真に対する77件の講評をそれぞれ3回読ませたところ、71件で3回とも同じティアでした(2026年10月)。意図については、あなたが選ぶレーン、つまり判定の基準を知っています。知りえないのは、フレームの中のある選択が意図的だったということです。そのため、ハイキーの空や意図的な傾きが欠点として読まれることがあります。その指摘は軽めに受け止めてください。利用規約は、その出力を専門家による評価ではなく「アルゴリズムによる意見」と呼んでいます。名前のついた基準に照らして測られたセカンドオピニオンとして扱ってください。
- AIのフィードバックで、写真がありきたりになりませんか?
- 汎用のモデルが言うことすべてに従えば、なりえます。2026年のプレプリントは、モデルが「人間が取捨選択するところで、ほぼすべての美的側面を網羅する」こと、そして人間の講評との類似が「画像に固有の観察よりも、安定した講評のスタイル」を反映していることを見出しました(arXiv:2606.29689)。10個の指摘を一度に直すことこそ、個性のあるフレームが正しいだけのフレームになる道筋です。FinalFrameは1回の講評につき問題をひとつ、選んだレーンでフレームにどれだけの損失を与えるかで選んで名指しします。それを直し、新しいバージョンをアップロードして、修正が効いたかどうかを確かめてください。名指しされたひとつのことが、あなたが意図して選んだものなら、残してください。
- 無料のAI写真講評はありますか?
- あります。FinalFrameのホームページでは、アカウントなしで無料のデモ講評を受けられます(ティア、スコア、名指しされたボトルネック、判定。編集ソフトの調整をすべて見るには無料アカウントが必要です)。無料アカウントでは月に3回講評を受けられ(1回につき1クレジット)、さらに編集したバージョンをアップロードしたときに一度だけ獲得できるボーナスクレジットが最大2つ付きます。
よく知っているフレームの、測定にもとづく講評を見てみる
すでに自分なりの意見がある写真をアップロードしてください。FinalFrameはそのピントと撮影上の限界の有無を読み、最も損失を与えているひとつの問題を名指しし、これ以上の編集に価値があるかどうかを伝え、やめるべきだと言うときにはその理由も述べます。そのひとつの修正のためのスライダーの値は、無料アカウントで見られます。それを、自分なら言ったであろうことと比べてください。どちらの方向の食い違いも、役に立つ部分です。
写真を講評するChatGPTおよびOpenAIは、OpenAIの商標です。FinalFrameはOpenAIと提携しておらず、OpenAIによる推奨も受けていません。